Как на самом деле работает память OpenClaw (4 слоя памяти)
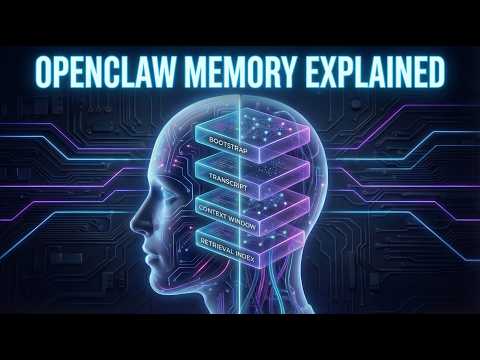
## Файлы Bootstrap — это ваша единственная долговечная память OpenClaw: постоянная идентичность OpenClaw хранится в файлах bootstrap, загружаемых с диска при каждом запуске сессии. По умолчанию это 20 000 символов на файл / 150 000 символов всего; всё, что превышает лимит, обрезается. Сам бот создателя Loki превысил лимит, потому что soul.md выполнял более 100 строк, а параллельные под-агенты читают только agents.md и tools.md — поэтому у них ощущение отсутствия личности. Держите soul.md к 15–30 строк. Навыки .md файлы — это отдельная экосистема, которая внедряется по требованию, а не в каждой сессии.
## Транскрипт сессии = Полная история, суммированная в контексте Каждое сообщение сохраняется на диск (часто в виде зашифрованной SQLite в .openclaw/memory), но модель видит только сводку после срабатывания авто-компактации. Математика триггера: context_limit − reserve_tokens − soft_threshold — для окна в 200К это 200,000 − 40,000 − 4,000 = 156,000, а не 200К. Последние 20 000 токенов остаются целыми; всё старое становится сводкой. Вот почему пользователь Discord создателя SummerU (Безопасность и Согласование, Meta Superintelligence Labs) наблюдала за массовым удалением писем в OpenClaw — правило «не удалять» жило в чате и было сведено в сводку.
## Контекстное окно имеет фиксированный размер и активно использует инструменты Claude Opus/Sonnet: 200K токенов (~150K слов, ~300 страниц). GPT-4: 128K. Gemini Pro: 1M. Наибольшее потребление токенов связано с результатами инструментов — чтением файлов, снимками веб-страниц, ответами API — а не с чатами. Совет: для анализа YouTube скопируйте транскрипт в .rtf и загрузите его напрямую. Создатель утверждает, что это экономит ~95% токенов по сравнению с передачей ссылки через API транскрипта.
## Индекс поиска = Гибридный поиск по файлам памяти OpenClaw индексирует memory.md /memory директорию и предоставляет двухэтапный memory_search → memory_get процесс с использованием ключевых слов + семантического соответствия. Постоянные торговые правила хранятся внутри директории памяти; новостные материалы с World Monitor выгружаются в Obsidian + GitHub, чтобы индекс оставался компактным.
## Когда память «ломается», проверьте слой Автор подталкивает к продолжению: три режима отказа (инъекция, структура пути/папки, поиск) и исправления конфигурации — здесь не рассматриваются.