Рейтинг моделей ИИ для агентских рабочих процессов (апрель 2026)
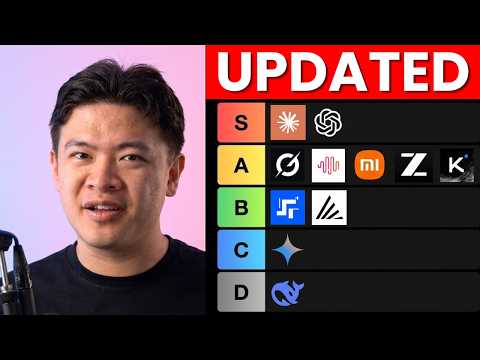
Claude — уровень S, но у Anthropic падает доверие
Claude занимает первое место, потому что каждый конкурент оценивается по нему Claude Opus и инженеры Meta используют его для создания. Создатель называет его «бесспорным королем» и даже предлагает уровень бога выше S. Загвоздка в том, что это «самая дорогая модель», и Anthropic тихо урезает лимиты планов — Z.AI, Kimi и MiniMax точно указывают количество запросов, Anthropic — нет. Стоит продолжать использовать, но следите за счетом.
GPT 5.4 — это настоящий претендент, а не Gemini
GPT 5.4 попадает в S-класс как вариант Claude на ~95%. Он сопоставим с Claude в реальных задачах Wild Claw Bench и выигрывает по стоимости, поэтому пользователи переходят на него. OpenAI закрыла Sora в этом месяце, чтобы сосредоточиться на основных моделях, и также пытается обойти Claude Cowork. Gemini 3.1 Flash попадает в C — команда говорит «не заморачивайтесь», отмечая, что он проигрывает Kimi, MiniMax и даже Step в Wild Claw Bench, и по цене уступает всем китайским лабораториям.
MiniMax M2 сейчас лучший китайский инструмент для повседневного использования
MiniMax M2 находится на уровне A и является самой удобной китайской моделью: щедрый план кодирования/токенов, полная прозрачность по числу запросов и 100 токенов/сек в непиковое время (что означает, что пользователи из США всегда находятся в непиковое время). Загвоздка: чисто агентская производительность «немного не дотягивает», а дешевые варианты base/Flash непригодны — V2 Flash «по сути как Haiku. Не трогайте его».
Kimi, Step, Grok и Xiaomi Mimo формируют уровни A/B
Kimi получает редкую оценку A+, потому что несколько платформ крипто-заказов принимают только его API-ключи, а экосистема роя реальна. Step — это уровень B, дешёвый и весёлый, но «китайцы дерутся изо всех сил». Grok — уровень A для повседневной работы с X, но создатель предупреждает: если Grok продолжает проваливать ваш код, «это не вы. Это Grok» — он занимает позиции ниже Kimi, MiniMax и Step on Wild Claw Bench. Xiaomi Mimo — единственная китайская модель с окном контекста 1M, которая превосходит Gemini по задачам агентов; Pro — надёжный, а непрофессиональный — нет.
DeepSeek заморожен, Z.AI находится на испытательном сроке
DeepSeek не отправлял ничего с до Китайского Нового года 2025 — вы «используете технологии 2025 года в 2026 году», и он даже не указан в бенчмарке Wild Claw. Их новая статья про объединённые токены действительно является новаторским исследованием, которого на Западе не делают, так что ожидайте скачок до уровня S в следующем релизе. Z.AI 5.1 выиграл игру с первой попытки за два дня до записи, что впечатляет, но за эти выходные была «нестабильность» из-за лимитов скорости и перегрузки после того, как генеральный директор публично пригласил провести стресс-тесты. В настоящее время уровень A, ожидается повторное тестирование.
Trinity и Hermes являются временными решениями
Создатель признаётся, что они «не сделали домашнюю работу» на Trinity (временное решение уровня A) и Hermes Agent (временное решение уровня B). Полный живой список уровней доступен по адресу boxminingai.com и будет обновляться по мере прогресса апреля 2026 года.