
Anthropic
Claude Fable 5.1
Премиум-опция Fable от Anthropic для сложных задач планирования и программирования, с сильными опубликованными результатами запуска.
Цены на API
USD за миллион токенов · Claude API Standard- Ввод
- $10
- Вывод
- $50
- Кэшированный ввод
- $0.25
- Контекстное окно
- 1М
Попробовать активные визуальные тесты
Откройте сгенерированную сцену для тестирования или сравните этот промпт с другой моделью.
Городское путешествие по прокрутке
Дата запуска: 02.09.2026
Специализированный тест · оценка отдельно
Кинематографическое путешествие по прокрутке, тестирующее непрерывность сцен, сгенерированных ИИ, движение камеры при прокрутке и художественно оформленные посадочные аппараты.
Ember Glider
Дата запуска: 02.09.2026
Закатное скользящее путешествие: тестирование управления энергией полета, потока контрольных точек и художественного оформления атмосферы.
Роханская крепость
Дата запуска: 02.09.2026
Тестирование сцены осады крепости: масштаб, освещение, архитектура и кинематографическая атмосфера.
Симулятор полета на метле в Хогвартсе
Дата запуска: 02.09.2026
Тестирование сцены полета на метле: глубина, визуальные подсказки движения, масштаб замка и фантастическое настроение.
Low-Poly Tower Defense
Дата запуска: 02.09.2026
Оборона башни диорамы: тестирование баланса экономики, дизайна волн, правил расстановки и читаемости боя.
Симулятор механических часов
Дата запуска: 02.09.2026
Интерактивное тестирование часов: механическая читаемость, точное относительное движение и управление в 3D в реальном времени.
Neon Drift
Дата запуска: 02.09.2026
Гоночные соревнования синтвейва на время: тестирование физики заносов, времени кругов, повтора привидений и прогрессии разблокировок.
Арена Звездопада
Дата запуска: 02.09.2026
Выживание в неоновой арене: тестирование нарастания волн, сборки улучшений, обратной связи частиц и дизайна боссов.
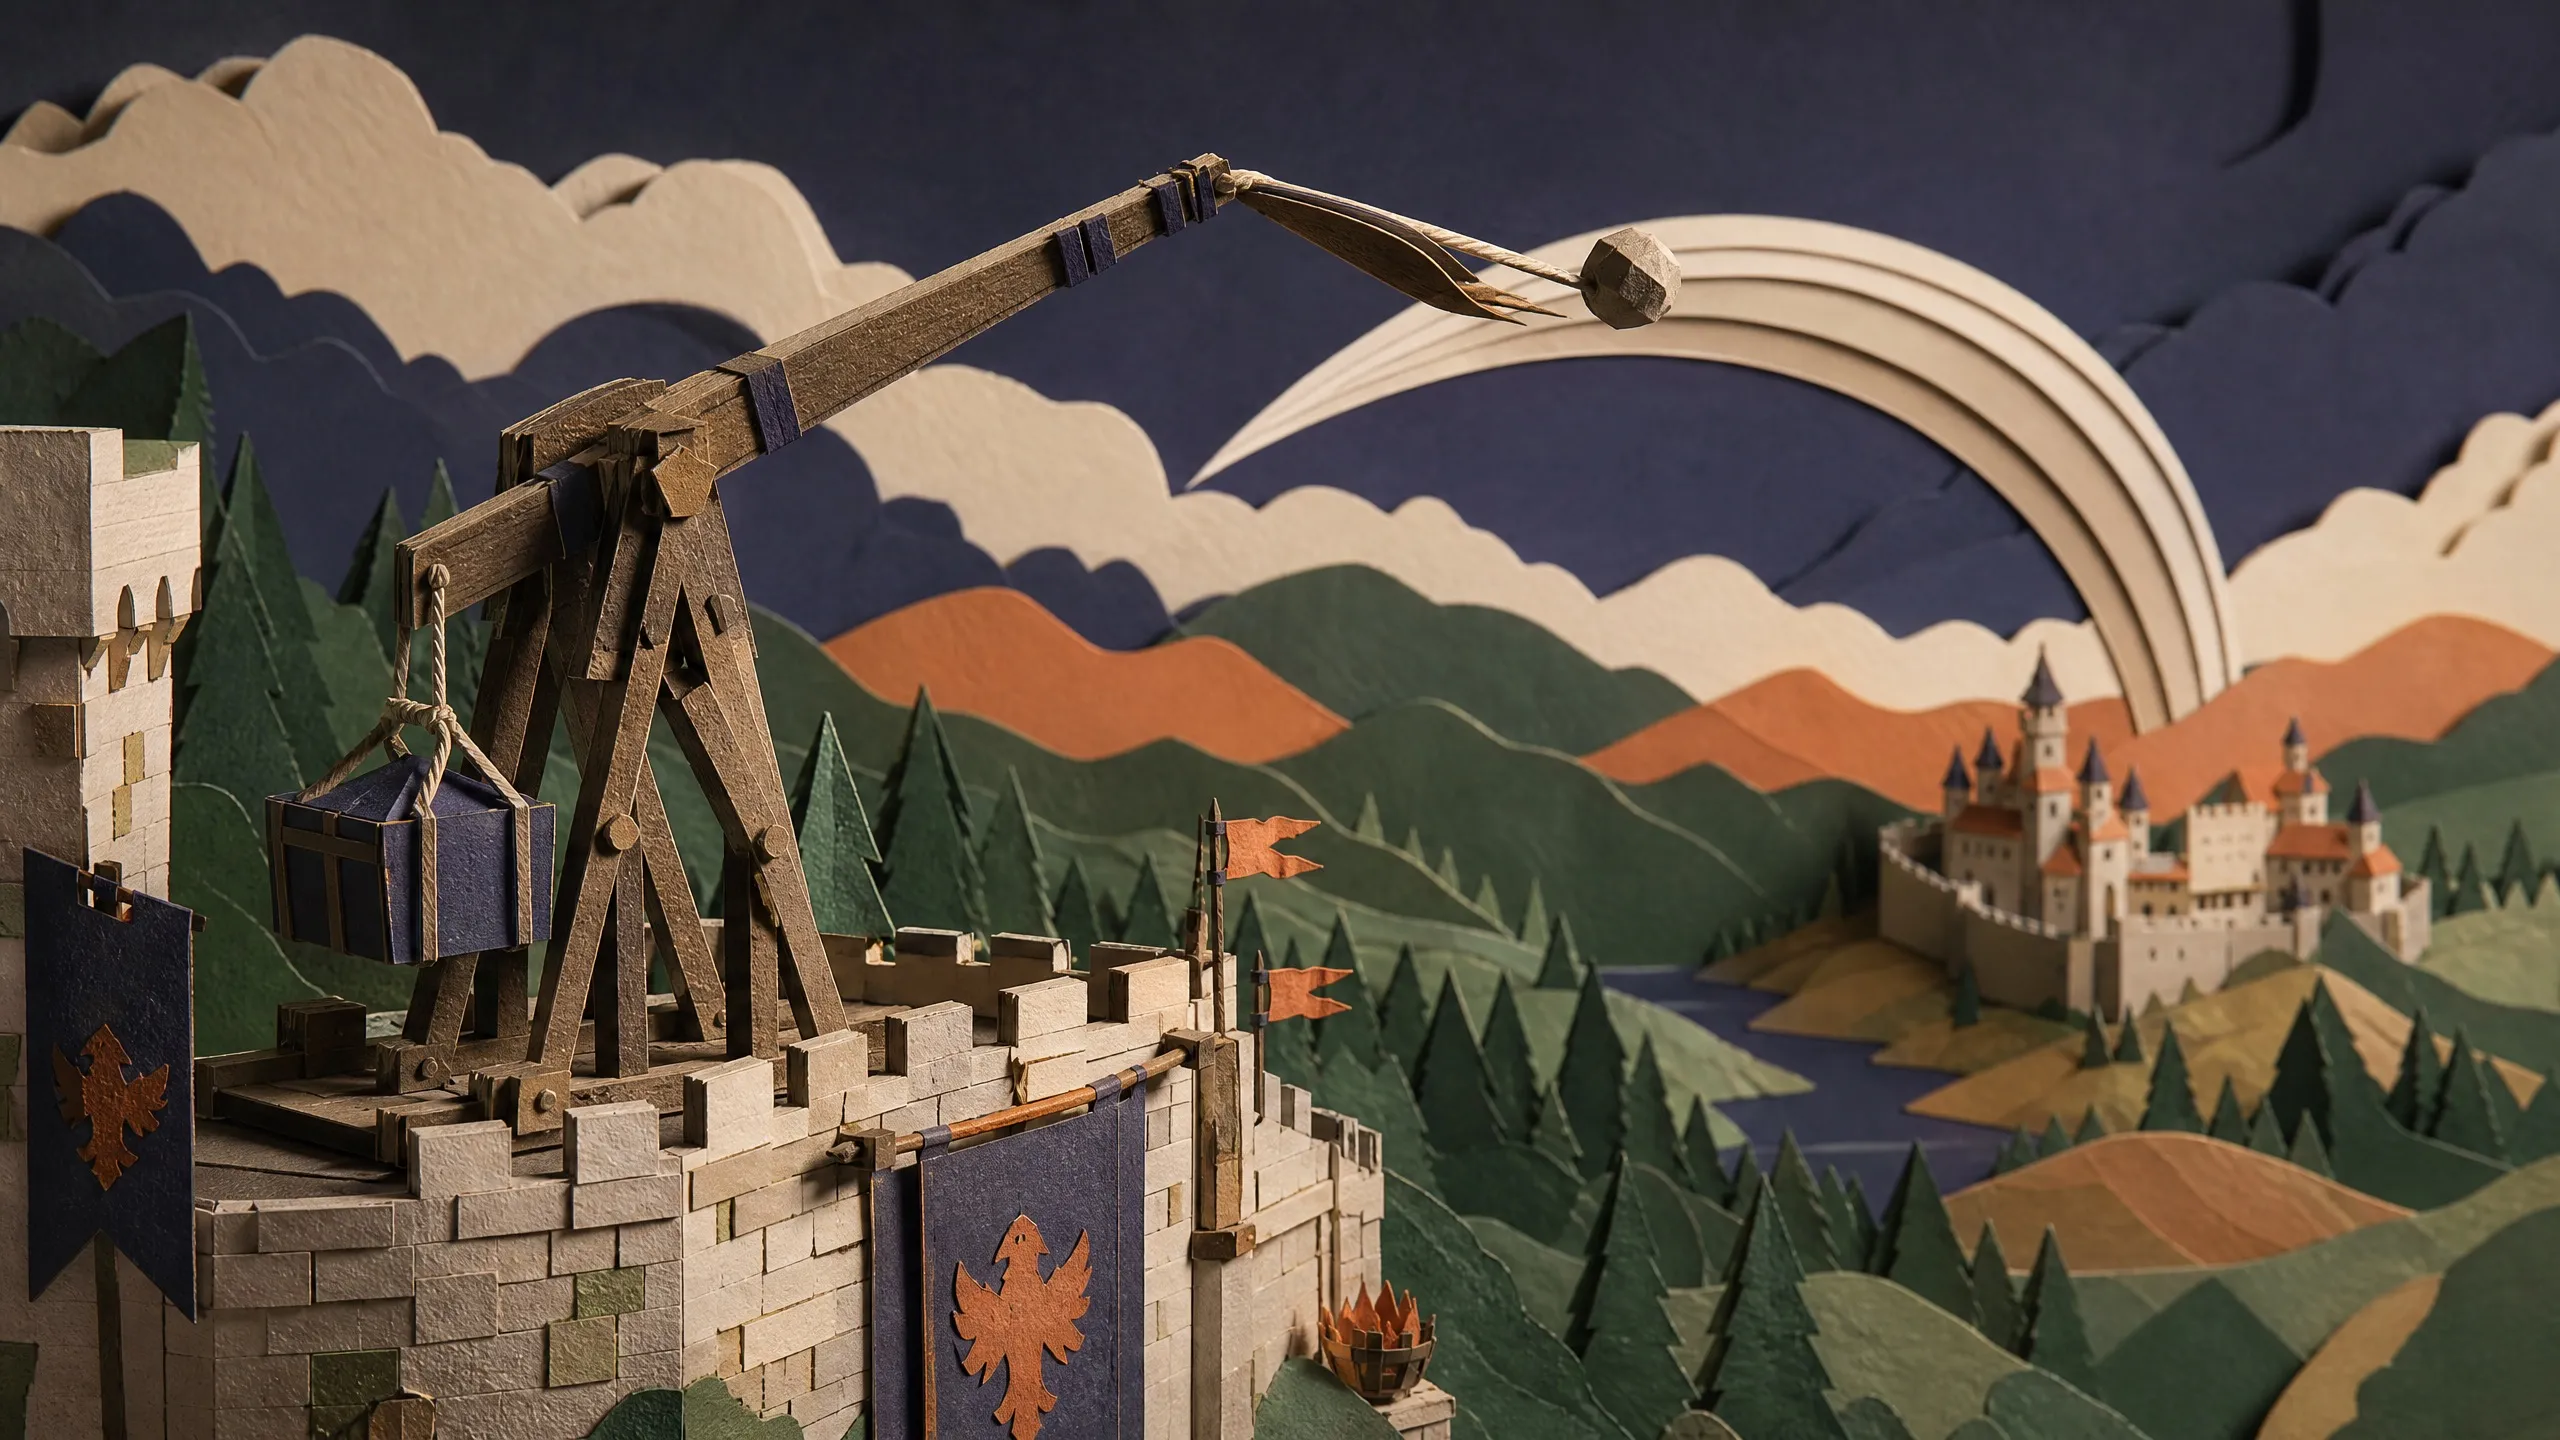
Симулятор Требушета Штормграда
Дата запуска: 02.09.2026
Тестирование осадного моделирования Counterweight с проверкой связанных механизмов, предсказанием траектории, камерами для снарядов и интерактивной настройкой.
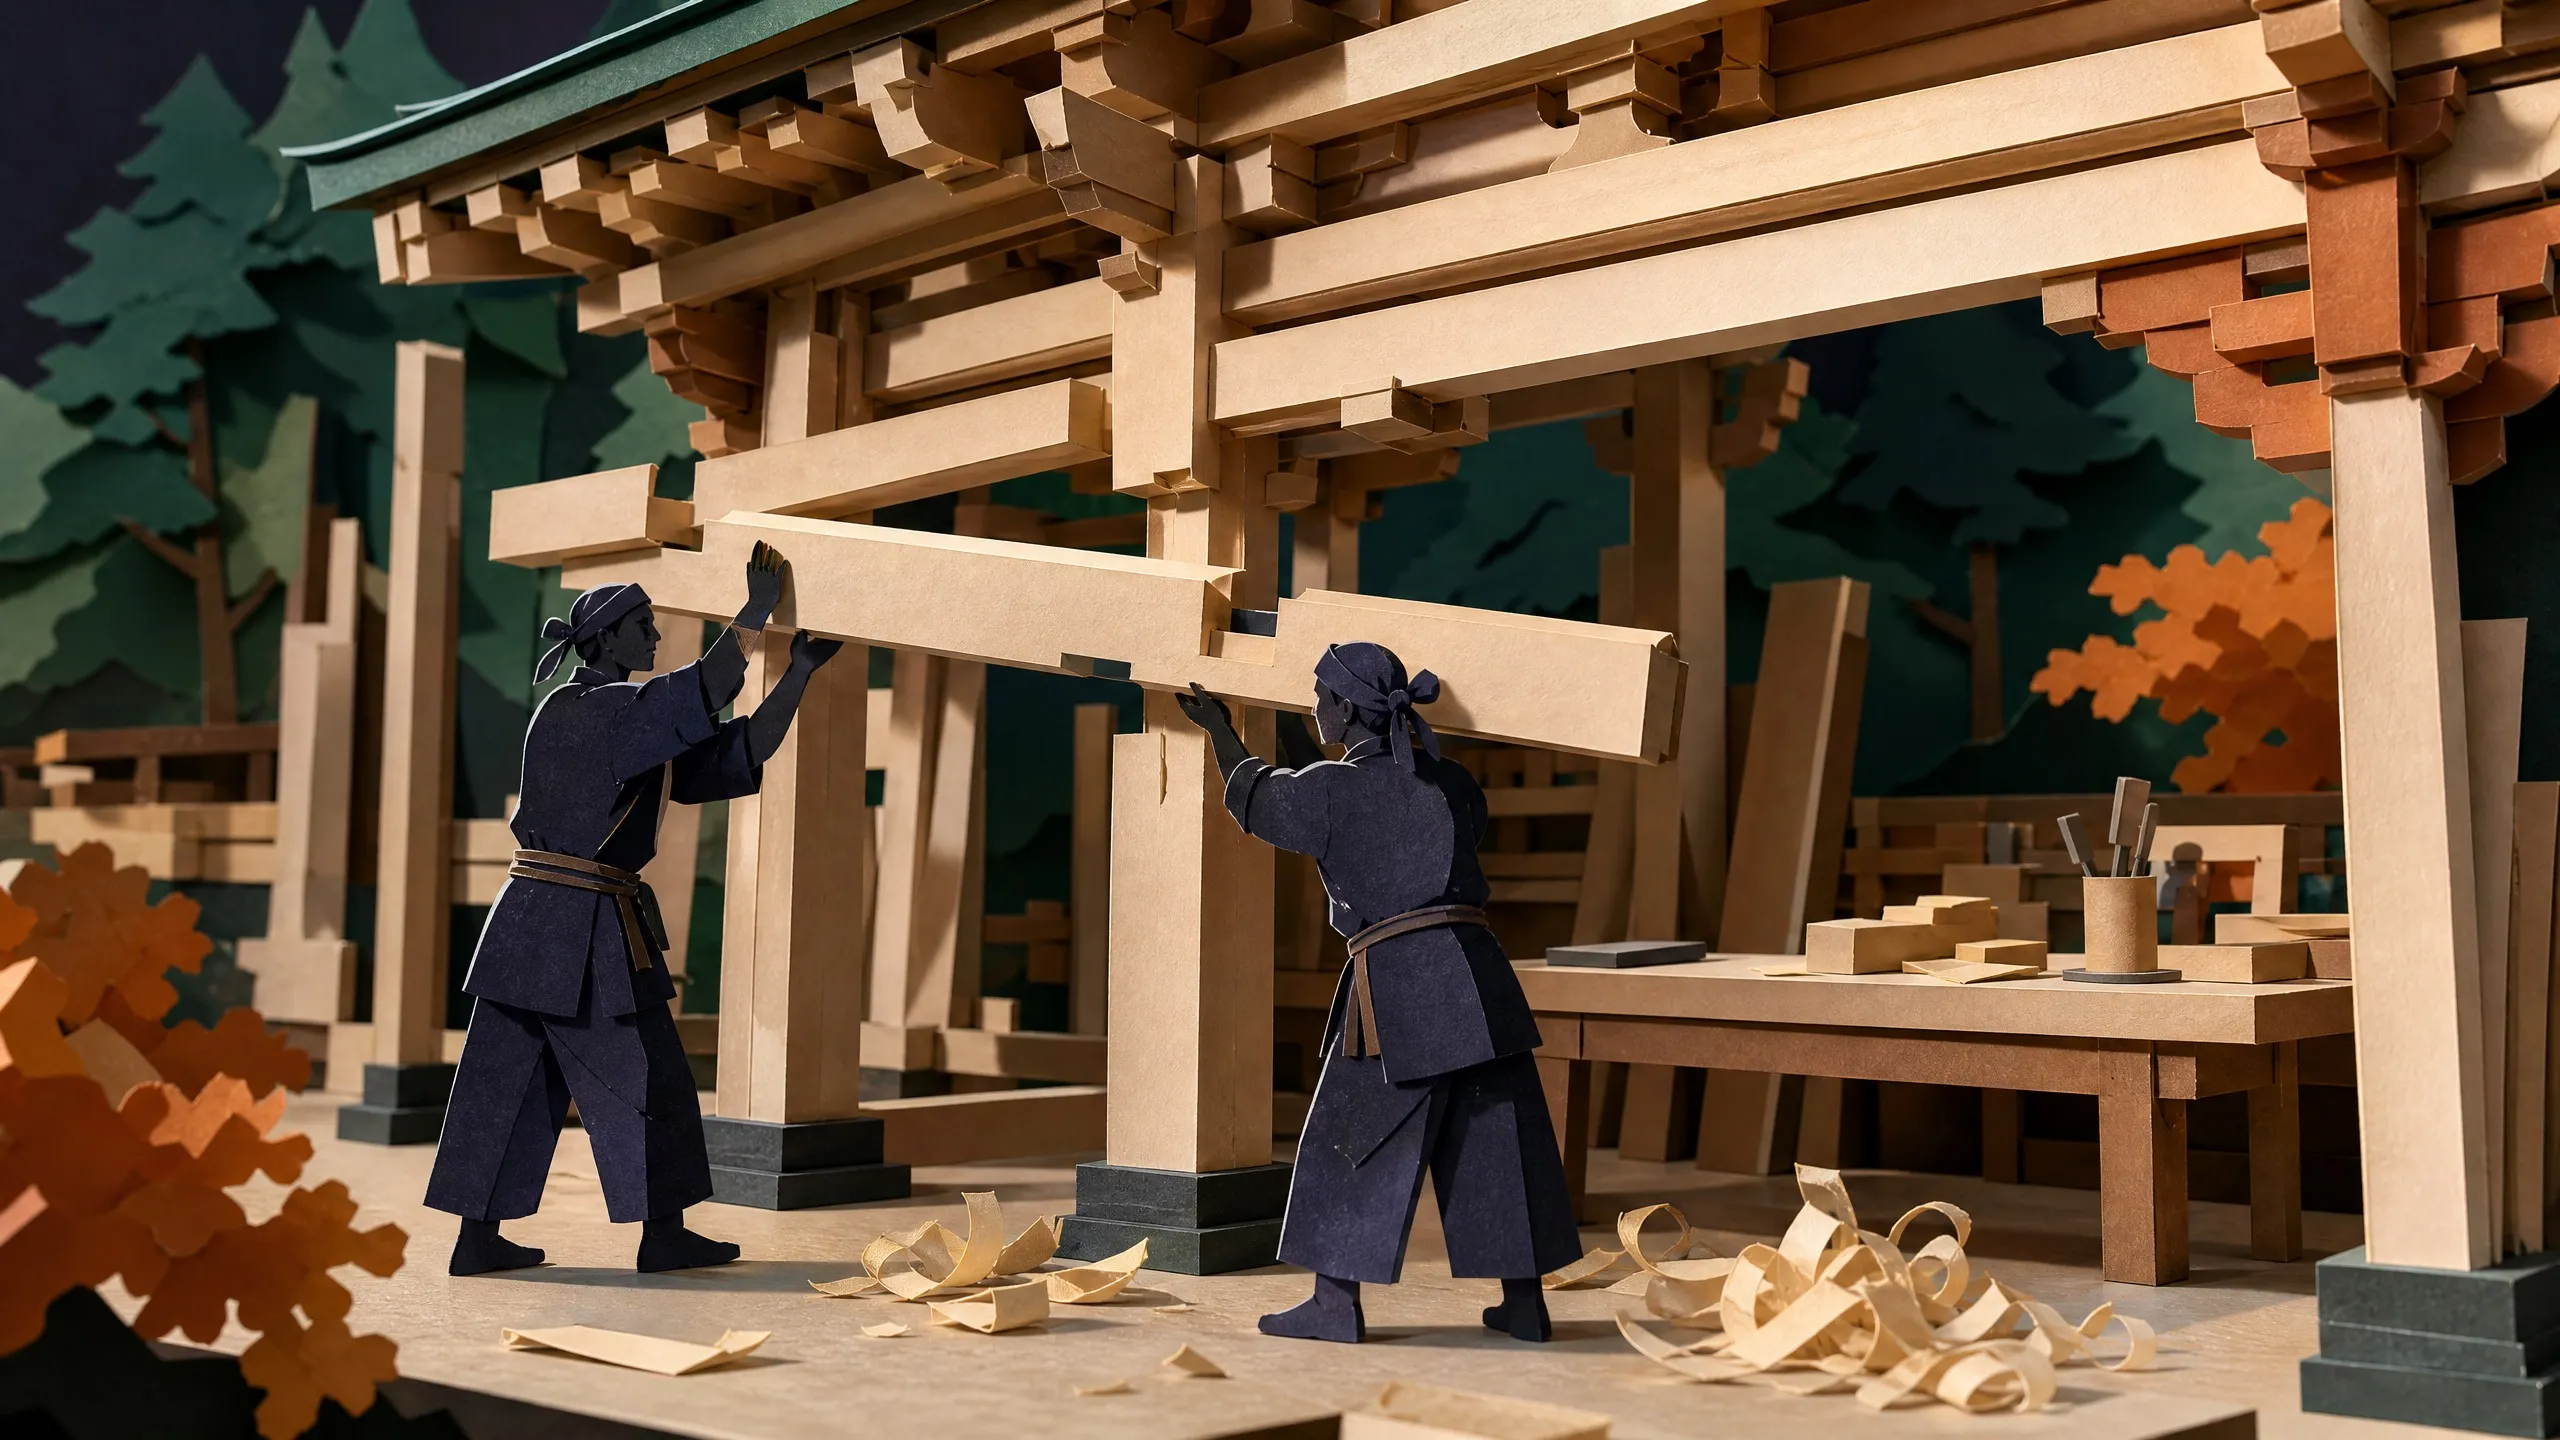
Сборка по «Yingzao Fashi»
Дата запуска: 02.09.2026
Специализированный тест · оценка отдельно
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Снятые с эксплуатации тесты · 6 заархивированных запусков
Эти тесты больше не входят в активный набор. Их исходные результаты остаются доступными для просмотра.
Как сравнивается Claude Fable 5.1
Трое соответствующих коллег, бок о бок.
- Claude Fable 5.1 Эта модель
- GPT-6 Astra
- Claude Fable 5
- Claude Opus 5
6 бенчмаркs · 4 модели
Официальный профиль бенчмарка
Результаты запуска Claude Fable 5.1 для агентного кодирования, исследований и автоматизации.
Полная официальная таблица бенчмарков16 оценок и сравнений с коллегами
| Бенчмарк | Площадь | Балл | Сравнение |
|---|---|---|---|
| Последний экзамен человечества (с инструментами) | Рассуждение | 65.0% | |
| Индекс интеллекта искусственного анализа v4.1.1 | Рассуждение | 65.7 | |
| FrontierMath Уровень 4 (v2) | Рассуждение | 87.8% | |
| DeepSWE v1.1 | Программирование | 67.4% | |
| FrontierCode 1.1 Расширенный (оценка) | Программирование | 63.6% | |
| FrontierCode 1.1 Основной (оценка) | Программирование | 50.9% | |
| GPQA Diamond | Наука | 93.7% | |
| ARC-AGI-2 | Рассуждение | 90.0% | |
| ARC-AGI-1 | Рассуждение | 97.5% | |
| BenchCAD (с инструментами) | Профессиональная работа | 84.3% | |
| Миграция базы данных (внутреннее OpenAI) | Программирование | 57.8% | |
| Безопасность использования компьютера (внутреннее OpenAI)Чем ниже, тем лучше | Выравнивание | 9.5% | |
| Terminal-Bench-Science 0.1 | Агентское исследование | 52.6% | |
| Terminal-Bench 4.0 | Агентное кодирование | 55.8% | |
| CursorBench 3.2.0 | Агентное кодирование | 73.4% | |
| AutomationBench | Многоступенчатая автоматизация | 31.4% |
Источники, детали ценообразования и методология
Проверенные данные о модели
Характеристики модели
- Статус
- Текущий
- ID модели API
claude-fable-5-1- Контекст
- 1М
- Максимальный вывод
- 128K
- Лицензия
- Не подтверждено публично
- Способ доступа
- Не подтверждено публично
- Модальности
- ввод текста, ввод изображения, вывод текста
- Аппаратное обеспечение
- Не подтверждено публично
- Claude API Standard · USD / 1M токенов
- Ввод $10 · Кэшированный ввод $0.25 · Запись в кэш $12.5 · Вывод $50
Показанная запись в кэш — это ставка за 5 минут; запись в кэш за 1 час стоит $20 за 1M токенов. Стандартная глобальная маршрутизация; пакетный режим, быстрый режим там, где доступно, и региональные тарифы отличаются.
Источники бенчмарков
Anthropic выпустила Claude Fable 5.1 1 сентября 2026 года как преемника Fable 5 по тем же ценам $10 / $50 за 1 млн токенов с уменьшением стоимости чтения кэша до $0,25. График запуска показывает прирост по сравнению с Fable 5 и Opus 5 в терминальном кодировании, научных исследованиях и многошаговой автоматизации.
Представляем Claude Fable 5.1Fable 5.1 была оценена с включенными производственными средствами защиты, поэтому Anthropic отмечает, что эти результаты, вероятно, недооценивают модель. Перечислены только строки с опубликованным числом Fable 5.1; система карты того же дня является более подробным источником.
Настройки оценки
- Таблица сравнения запуска OpenAI Astra, проверена 7 сентября 2026 года. Максимальный зарегистрированный балл при любых усилиях; исследовательские/API окружения. Общая таблица не гарантирует идентичные программные комплекты, бюджеты или средства защиты.
- Меньше — лучше. Таблица сравнения запуска OpenAI Astra, проверено 7 сентября 2026 года. Максимальный зарегистрированный результат при любых усилиях; исследовательские/API среды. Общая таблица не гарантирует идентичные комплекты инструментов, бюджеты или меры безопасности.
- Диаграмма запуска Anthropic; стандартная ошибка около 3,5–4,5 пунктов на модель. Anthropic воспроизводит Opus 5 на 29,0% и Fable 5 на 24,7% в собственной настройке.
- Диаграмма запуска Anthropic. Mythos 5.1, та же модель без производственных мер безопасности, набирает 60,9%.
- Диаграмма запуска Anthropic; агент производства Cursor.
- Диаграмма запуска Anthropic. Вмешательства мер безопасности оцениваются в ноль, что, по словам Anthropic, особенно снижает показатели Fable 5.
- Последний экзамен человечества (с инструментами)
- Источник
- Индекс интеллекта искусственного анализа v4.1.1
- Независимый индекс, воспроизведённый в таблице запуска OpenAI; отдельно от более старых наблюдений v4.1 в cost explorer. Источник
- FrontierMath Уровень 4 (v2)
- Источник
- DeepSWE v1.1
- Источник
- FrontierCode 1.1 Расширенный (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8). Источник
- FrontierCode 1.1 Основной (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8). Источник
- GPQA Diamond
- Источник
- ARC-AGI-2
- Источник
- ARC-AGI-1
- Источник
- BenchCAD (с инструментами)
- Результаты Claude используют три модификации оценки. Оценки показаны для контекста; прямой разницы не рассчитывается. Источник
- Миграция базы данных (внутреннее OpenAI)
- Источник
- Безопасность использования компьютера (внутреннее OpenAI)
- Меньше — лучше. Исследовательский комплект без подтверждений в производстве; меры безопасности и инструменты поставщика по-прежнему различаются. Источник
Методология сравнения
Максимально зафиксированный результат при любых попытках; исследовательские/API среды. Общая таблица не гарантирует одинаковые настройки, бюджеты или меры защиты. Разрывы описывают зафиксированные результаты, а не статистическую значимость. Процентные полосы простираются от 0 до 100; индексные полосы используют шкалу отображения 0–100.
- Terminal-Bench Science 0.1
- Anthropic сообщает стандартную ошибку около 3,5–4,5 баллов для каждой модели; небольшие разрывы могут быть шумом.
- Индекс интеллекта искусственного анализа v4.1.1
- Независимый индекс, воспроизведённый в таблице запуска OpenAI; отдельно от более старых наблюдений v4.1 в cost explorer.
- FrontierCode 1.1 Расширенный (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8).
- FrontierCode 1.1 Основной (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8).
- OSWorld 2.0 · офлайн, v2026.08.08
- Частичный результат на офлайн-подмножестве. Модифицированные задачи и оценка Anthropic несовместимы; значение Fable 5.1 здесь не предоставлено.
- ScreenSpot-Pro (без инструментов)
- Источник обозначает 87,3 Mythos как Fable 5 ( сноска 17). Оно исключено из столбца Fable здесь, потому что меры защиты модели отличаются.
- BenchCAD (с инструментами)
- Результаты Claude используют три модификации оценки. Оценки показаны для контекста; прямой разницы не рассчитывается.
- HealthBench Professional (с корректировкой длины)
- Повторная оценка OpenAI с использованием GPT-5.4 для градации. Fable 5.1 использует Opus 5 в качестве резервного варианта при отказе; не является отдельным результатом Fable.
- ExploitBench
- Astra и Sol оценены без производственных мер безопасности.
- ExploitGym
- Колонки Fable источника — Mythos 5.1 (30.4) и Mythos 5 (28.4), здесь исключены. Astra/Sol не имеют шестичасового ограничения и производственных мер безопасности. Не сравнение производственных моделей.
- ExploitBench (июнь–август 2026)
- Внутренний набор OpenAI, без производственных мер безопасности. Sol 5.5 ограничен 300 ходами; источник также сообщает 11.5 с меньшими ограничениями.
- SRE-Bench (одна попытка)
- Оценка киберспособностей без производственных мер безопасности.
- Безопасность использования компьютера (внутреннее OpenAI)
- Меньше — лучше. Исследовательский комплект без подтверждений в производстве; меры безопасности и инструменты поставщика по-прежнему различаются.
- ARC-AGI-3
- Ответы OpenAI с двумя изменёнными настройками; см. исходную сноску 1.
Редакционный вердикт
Где подходит эта модель
Fable 5.1 заменила Fable 5 1 сентября 2026 года. Сохраняется ценообразование $10 / $50 за 1М токенов, чтение из кэша сокращено до $0,25, и адаптивное мышление включено по умолчанию. График запуска показал 55,8% на Terminal-Bench 4.0 и 73,4% на CursorBench 3.2.0 с включенными защитными механизмами для производственной среды. Opus 5.5 теперь является более доступной рекомендацией Anthropic для большинства рабочих нагрузок.
Лучшее для
Внимание
Почему она занимает это место
Доказательство
Рейтинг редакционной модели Mantis
Основной вывод: Claude Fable 5.1 в настоящее время помещён в категорию S.
Редакционная таблица сентября 2026 года размещает Claude Fable 5.1 на 3 месте.
Открытый исходный код →Связанные руководства