OpenAI
GPT-6 Astra
Уровень S для работы агентом сквозного цикла, поддерживаемой полным набором из 16 опубликованных визуальных тестов Mantis.
Цены на API
USD за миллион токенов · OpenAI API Standard (≤272K входных токенов)- Ввод
- $10
- Вывод
- $50
- Кэшированный ввод
- $1
- Контекстное окно
- 1.05М
Демонстрация 2 октября: четыре сборки браузера и кинематографический ролик Гизы →
Попробовать активные визуальные тесты
Откройте сгенерированную сцену для тестирования или сравните этот промпт с другой моделью.
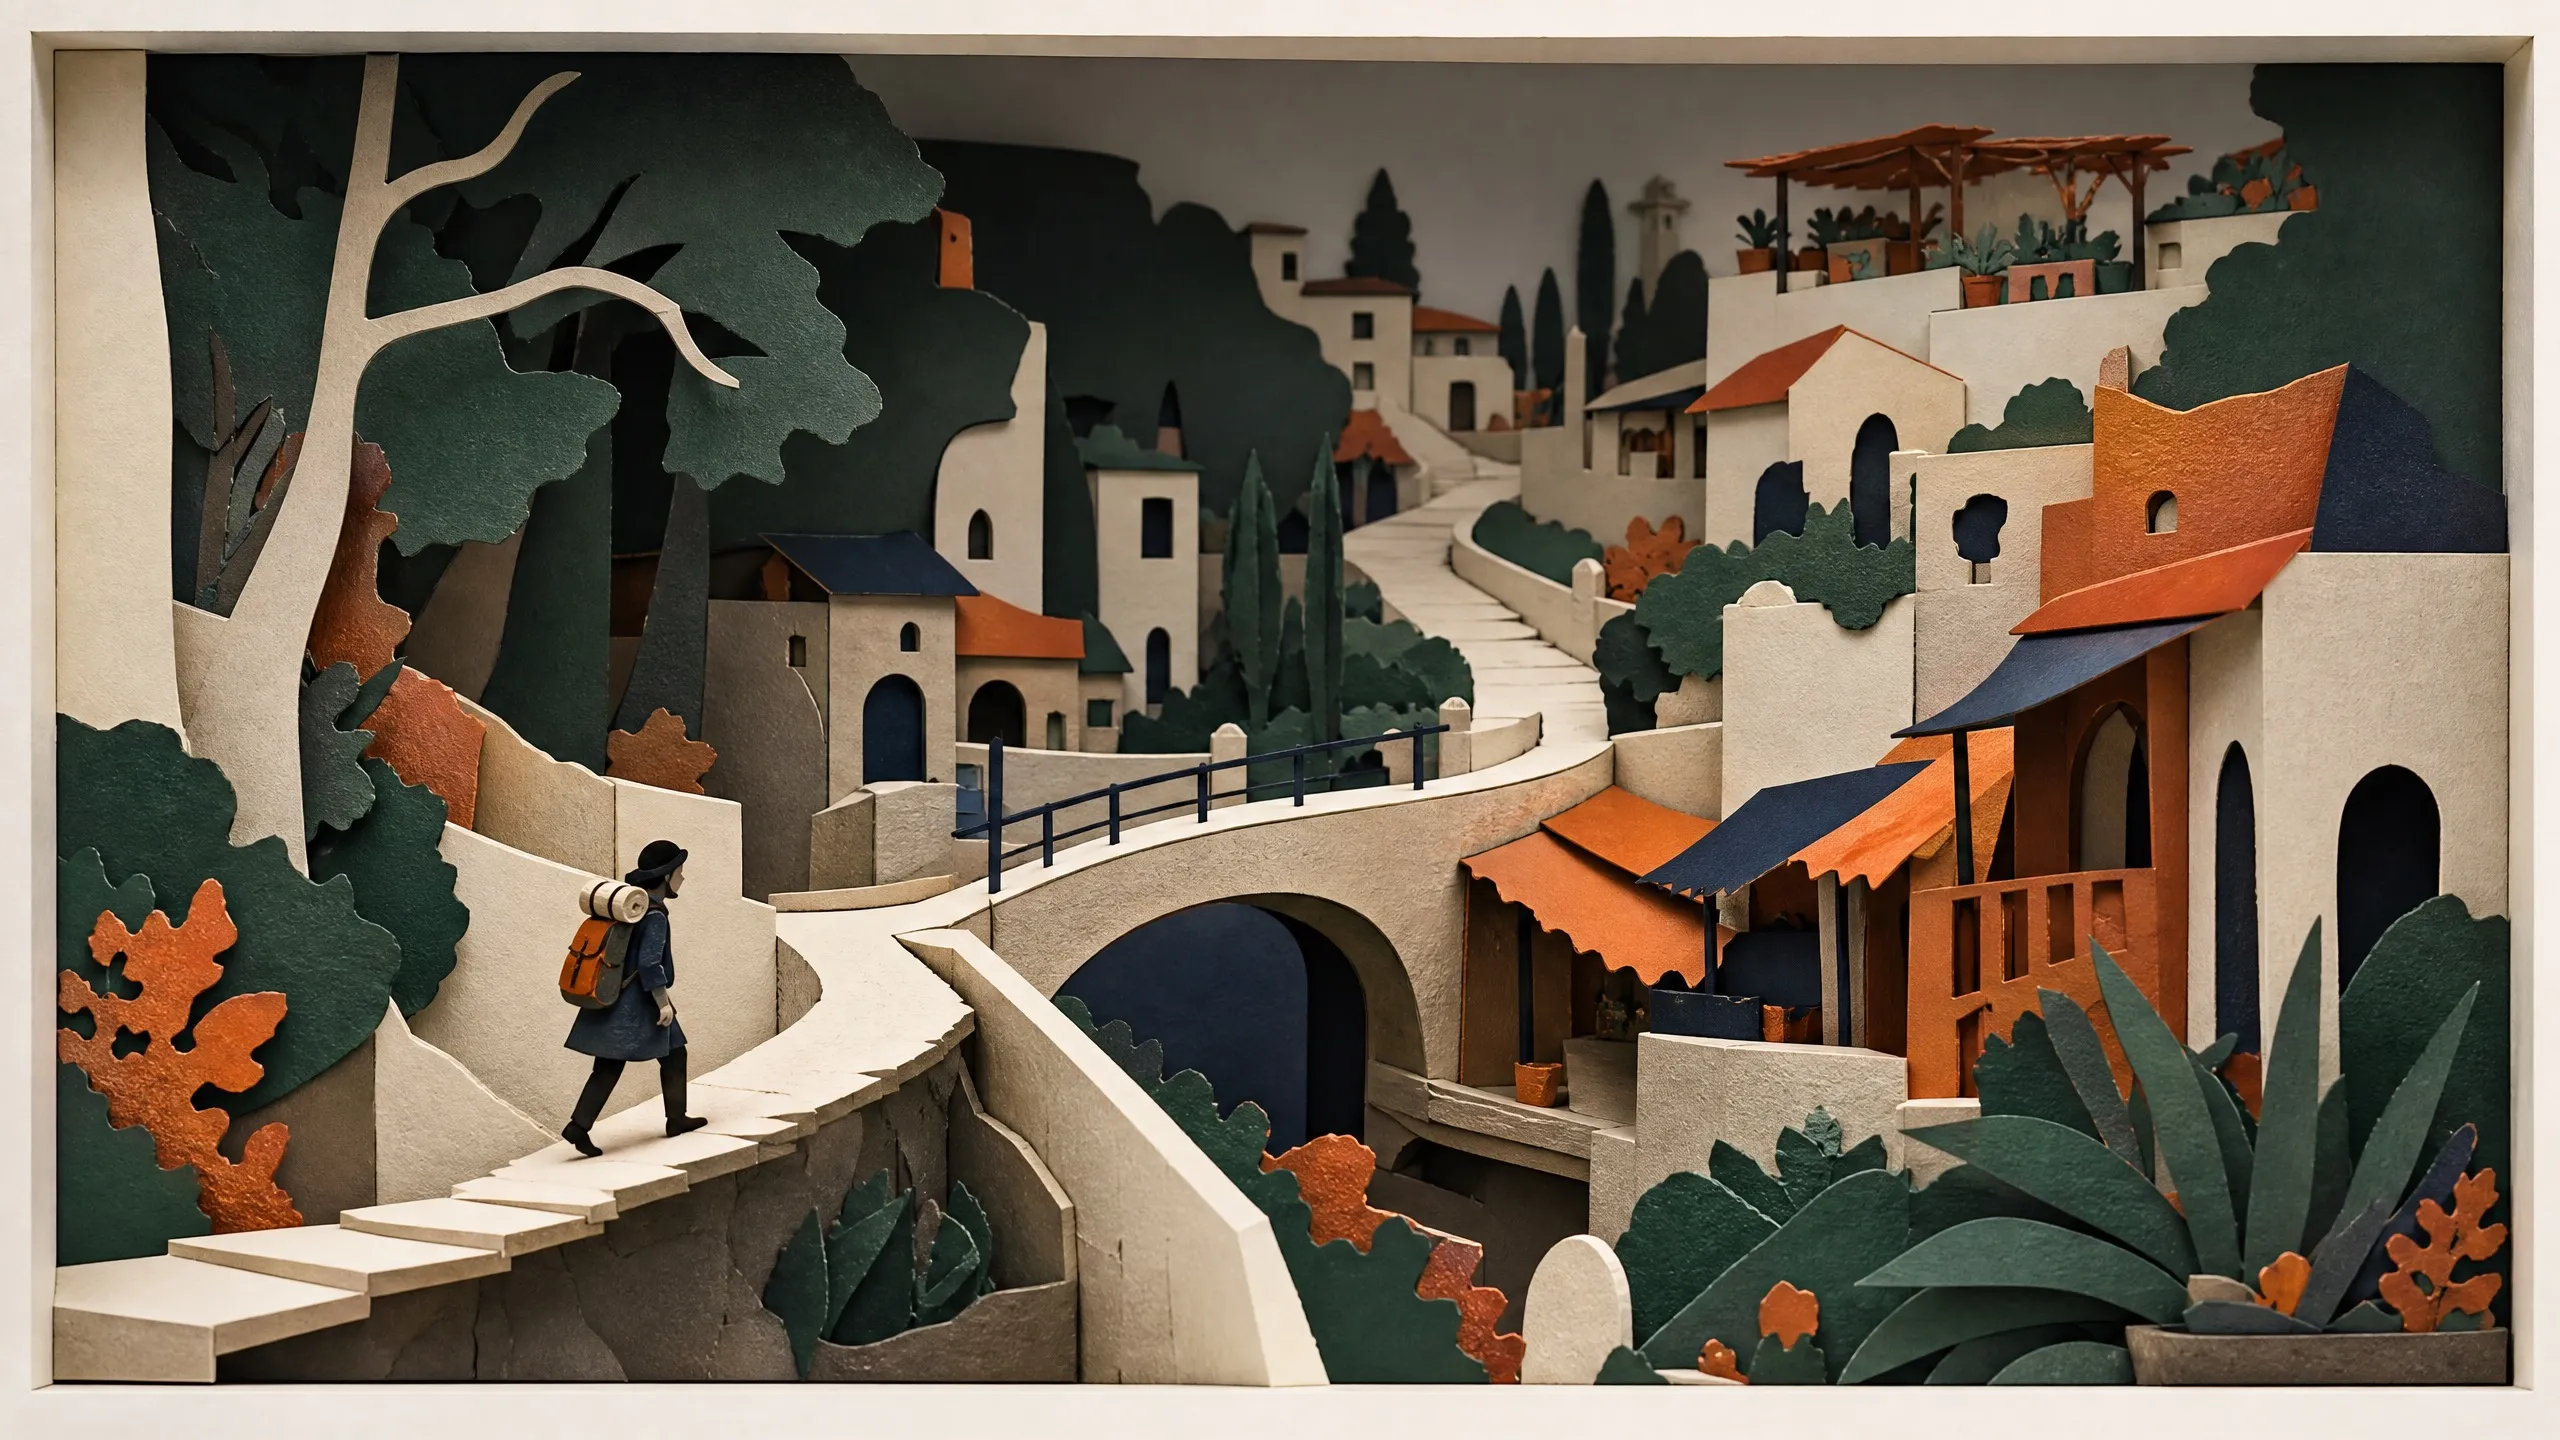
Городское путешествие по прокрутке
Дата запуска: 07.09.2026
Специализированный тест · оценка отдельно
Кинематографическое путешествие по прокрутке, тестирующее непрерывность сцен, сгенерированных ИИ, движение камеры при прокрутке и художественно оформленные посадочные аппараты.
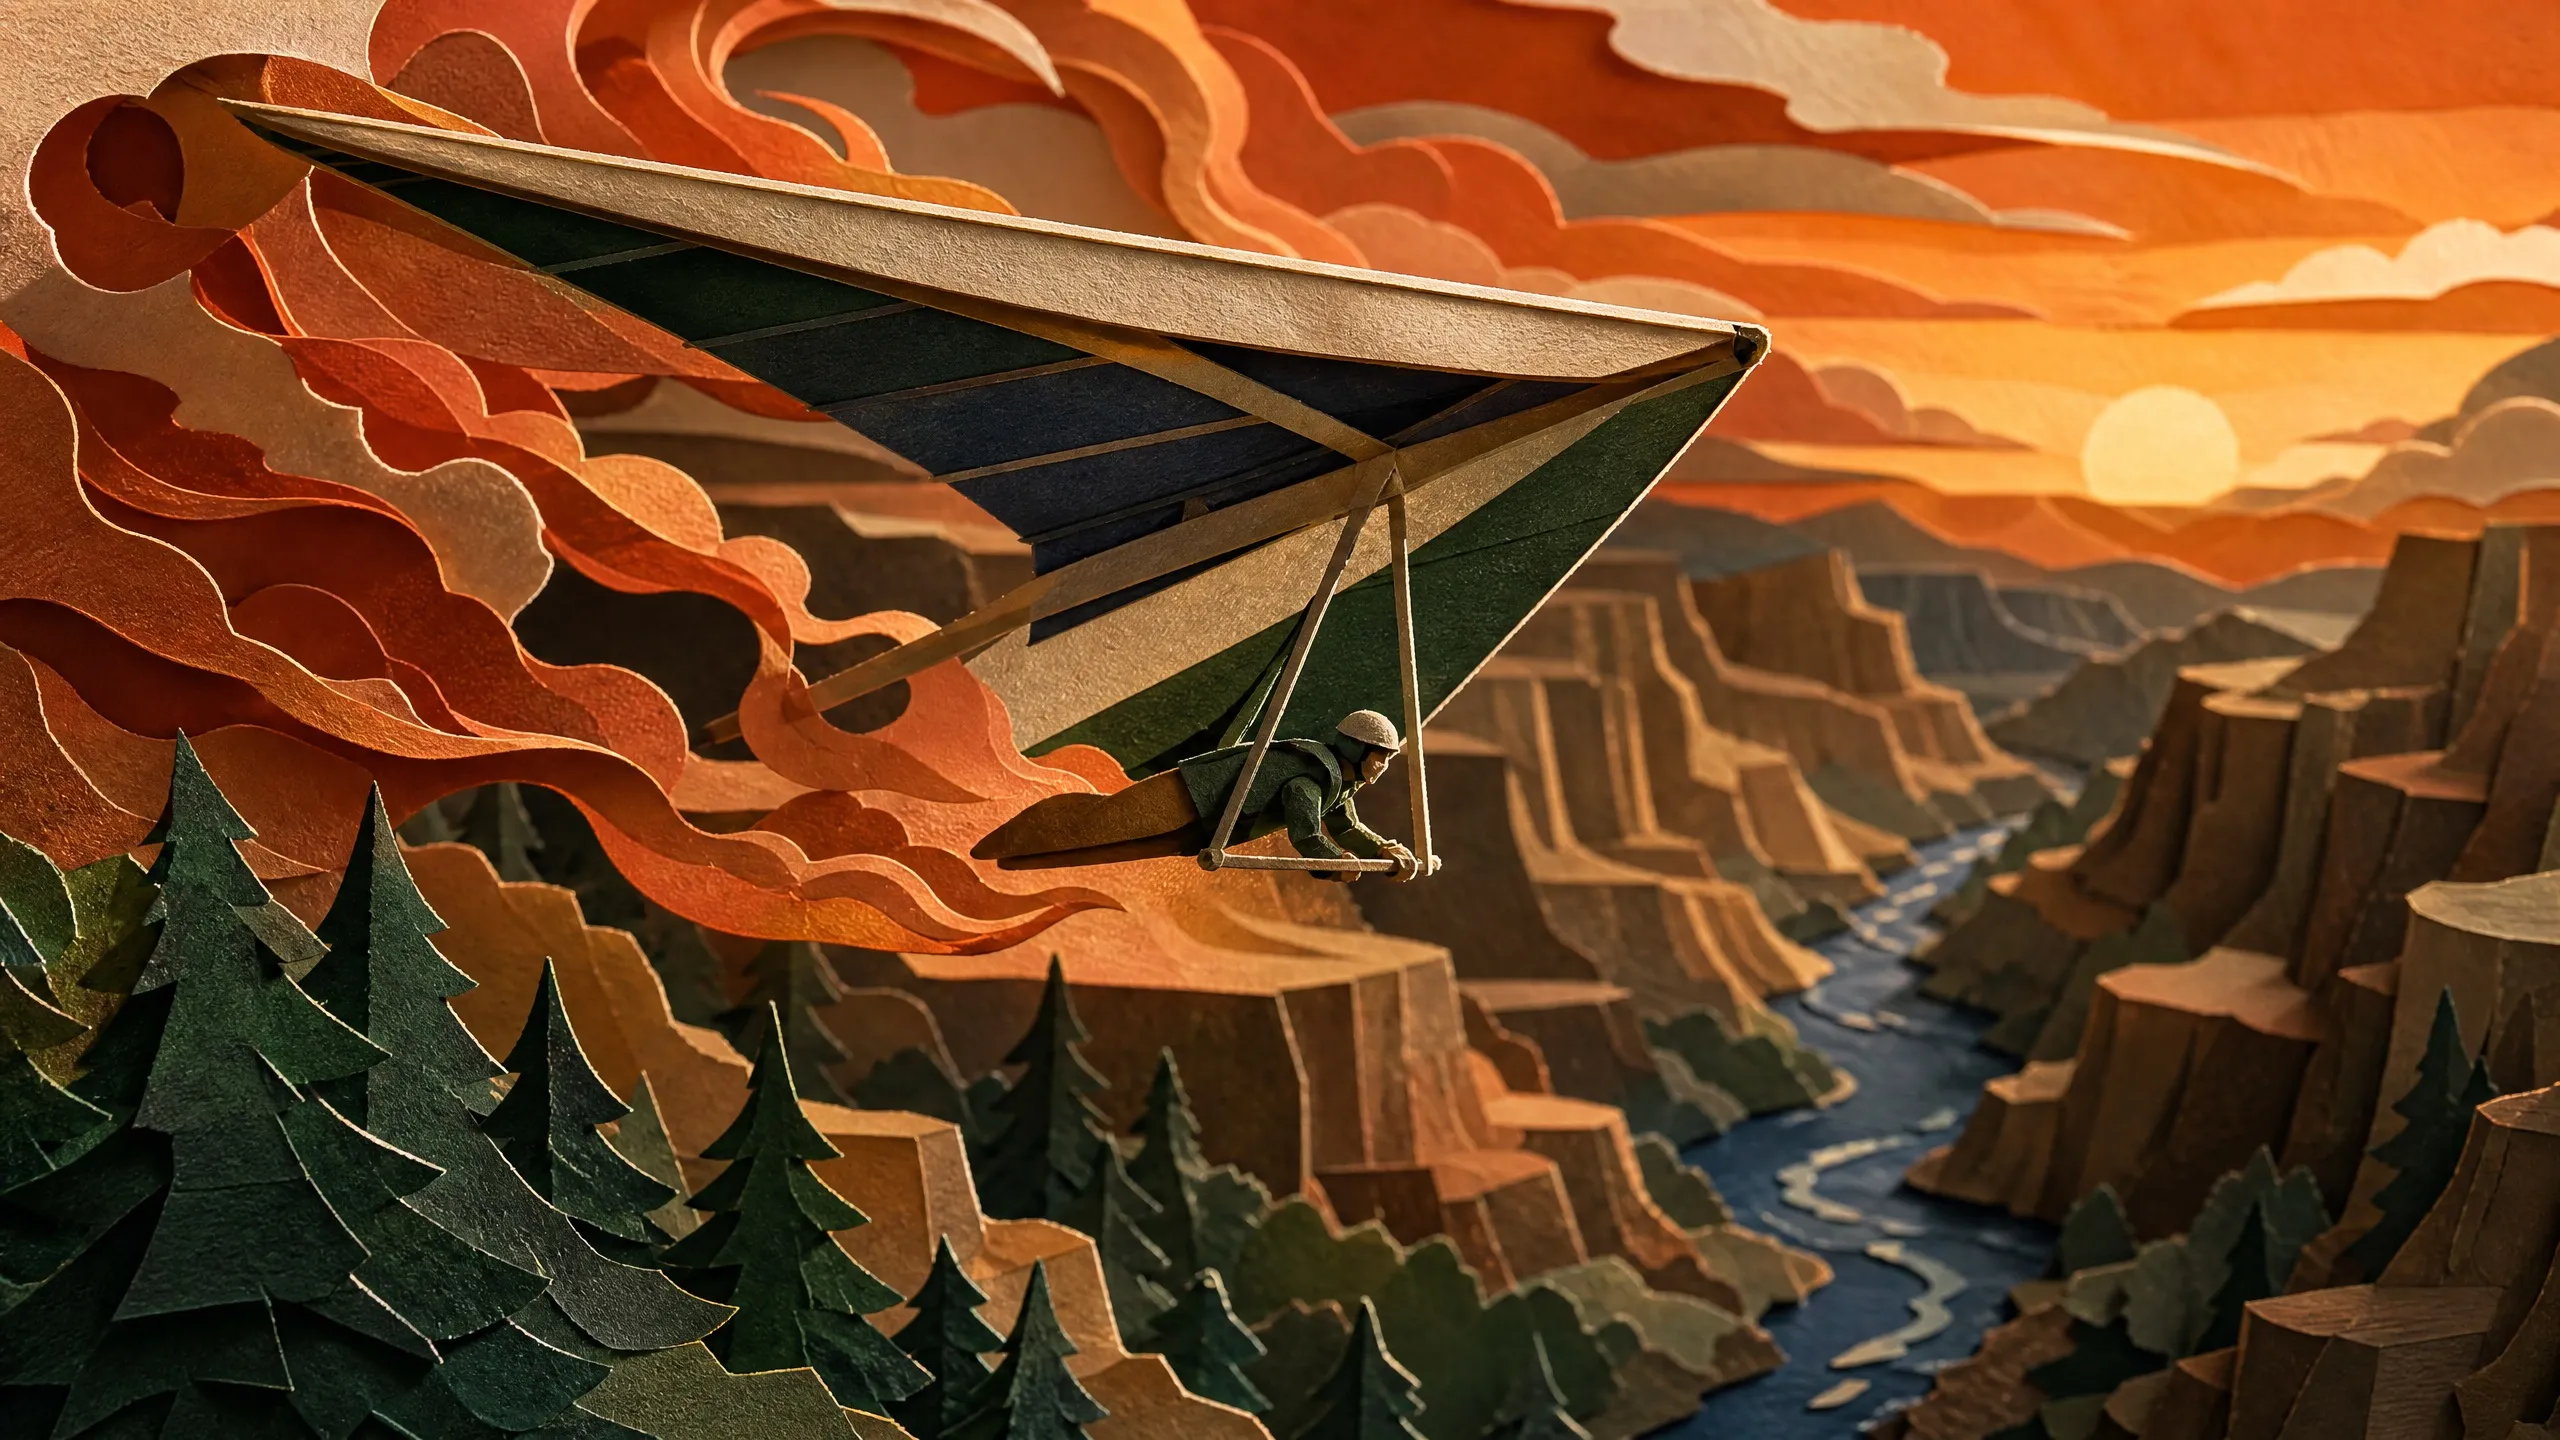
Ember Glider
Дата запуска: 07.09.2026
Закатное скользящее путешествие: тестирование управления энергией полета, потока контрольных точек и художественного оформления атмосферы.
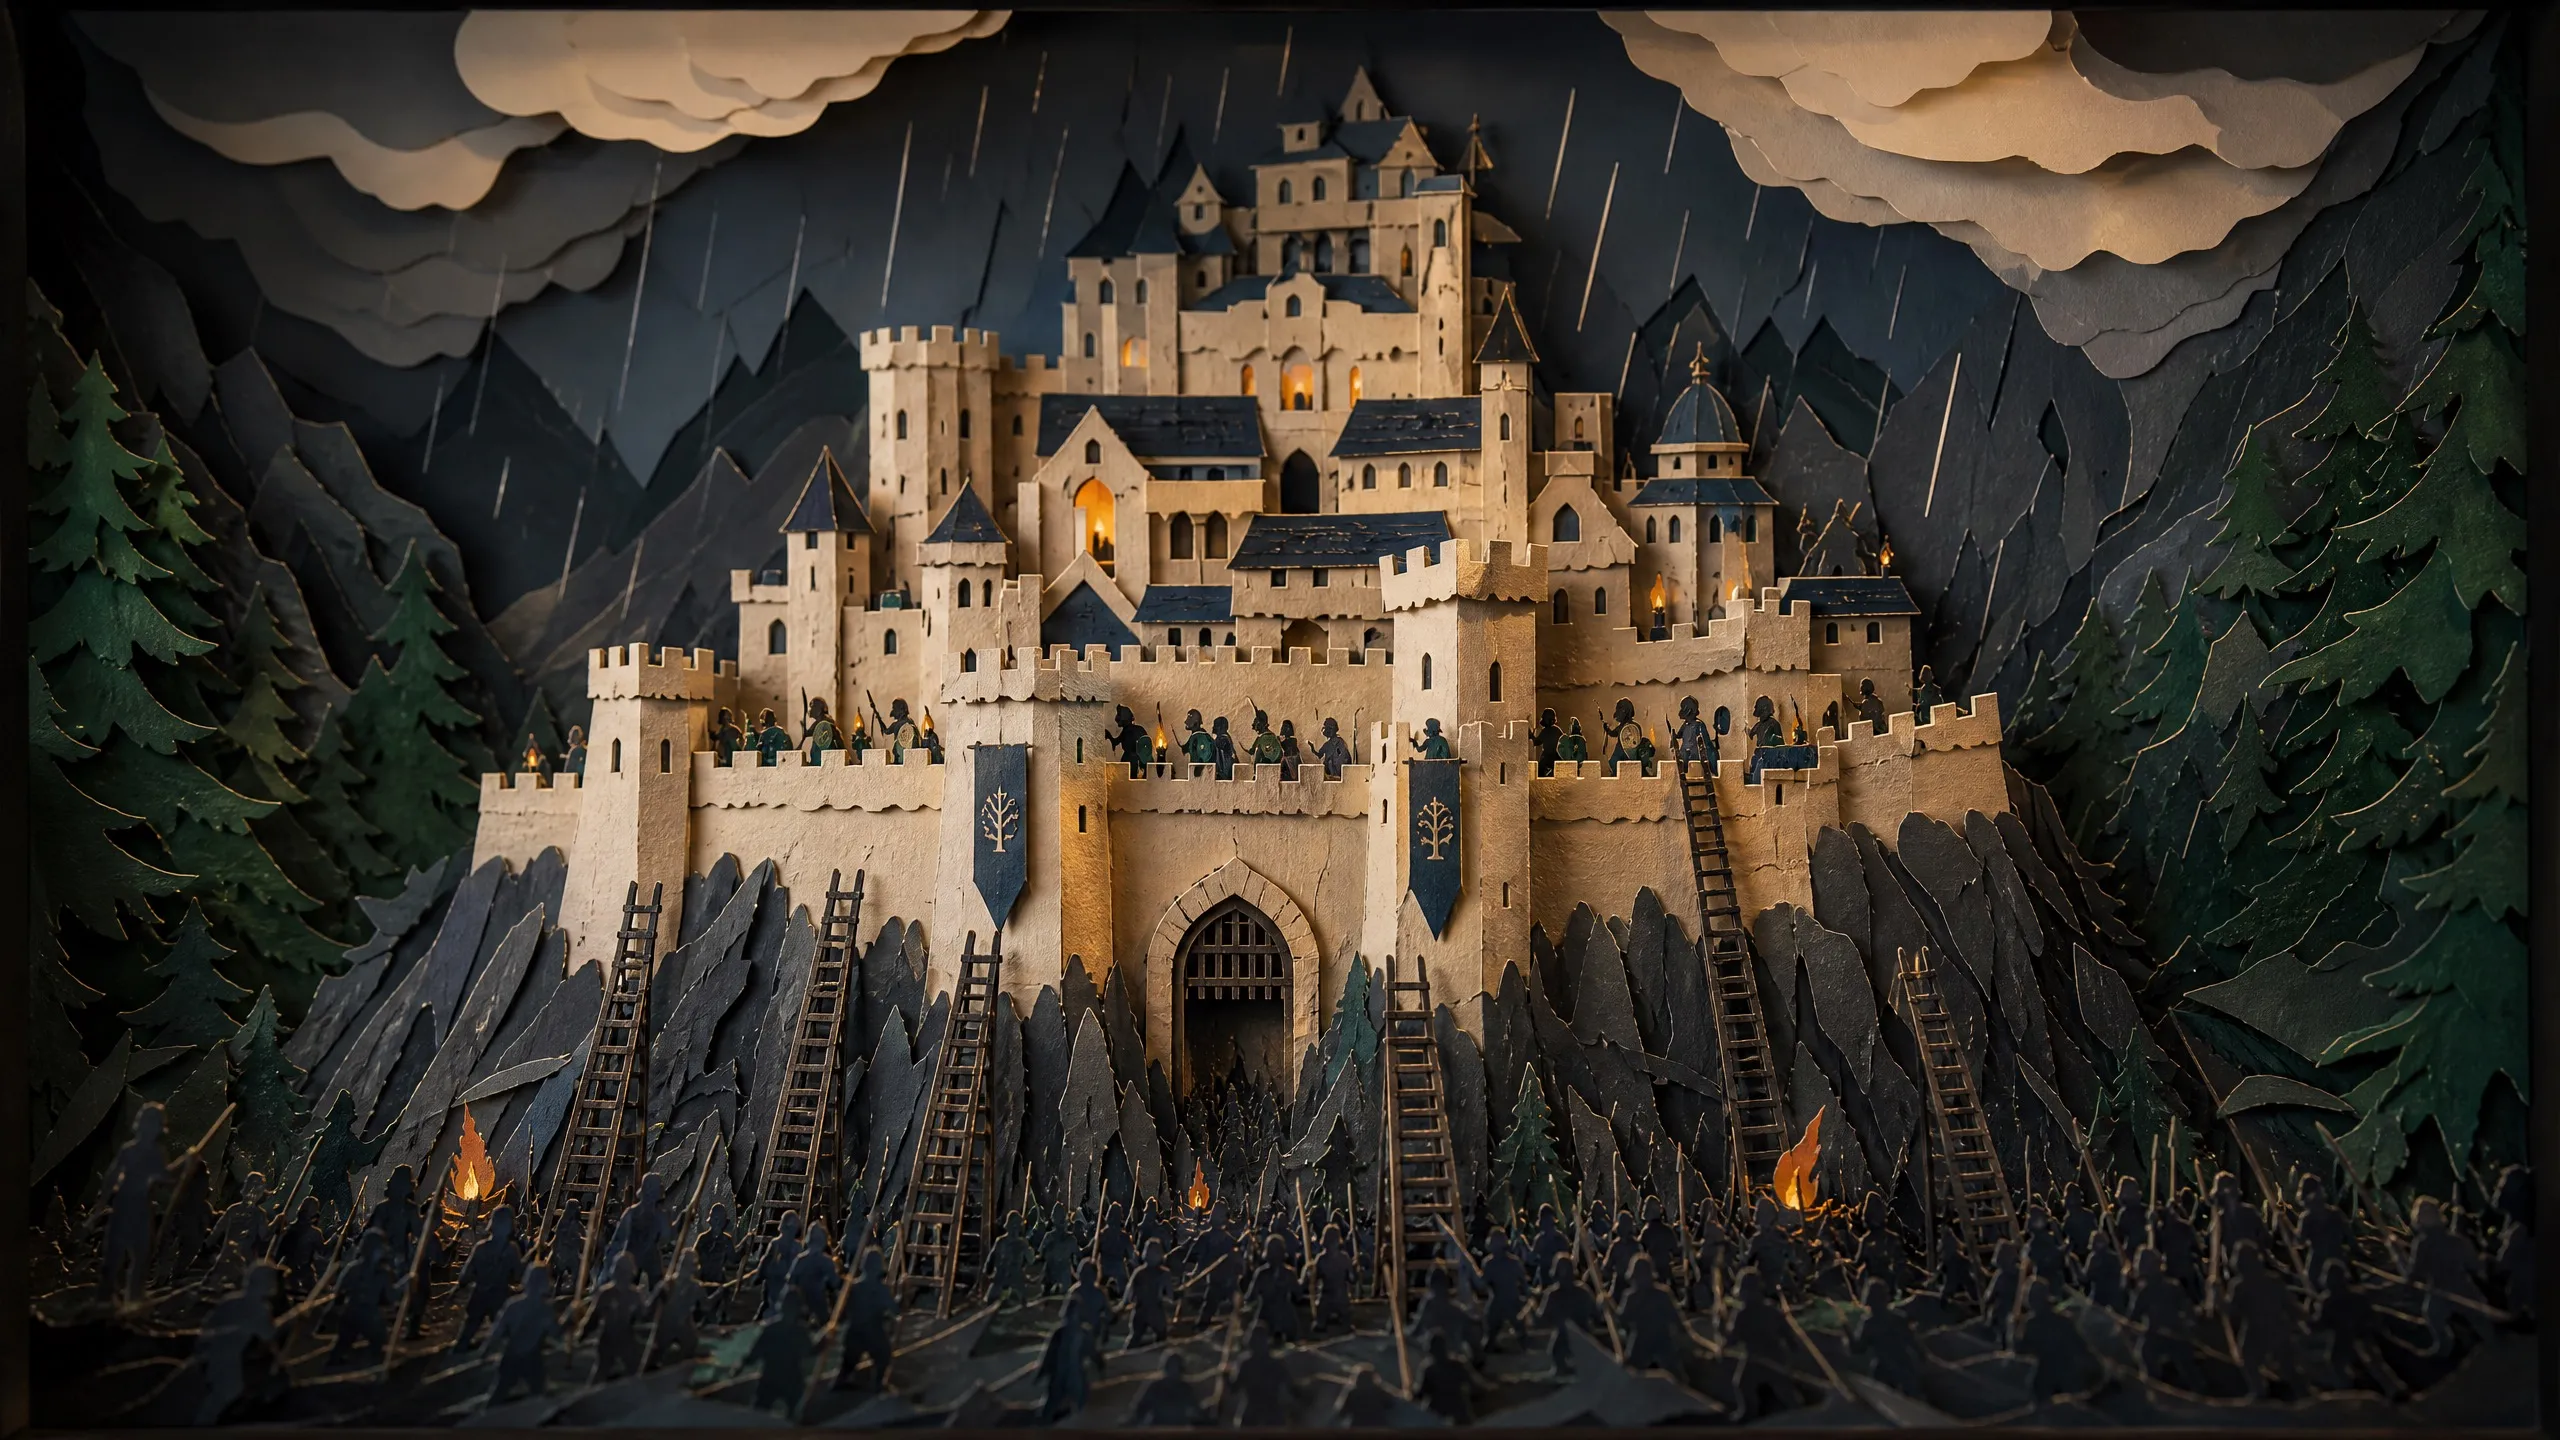
Роханская крепость
Дата запуска: 07.09.2026
Тестирование сцены осады крепости: масштаб, освещение, архитектура и кинематографическая атмосфера.
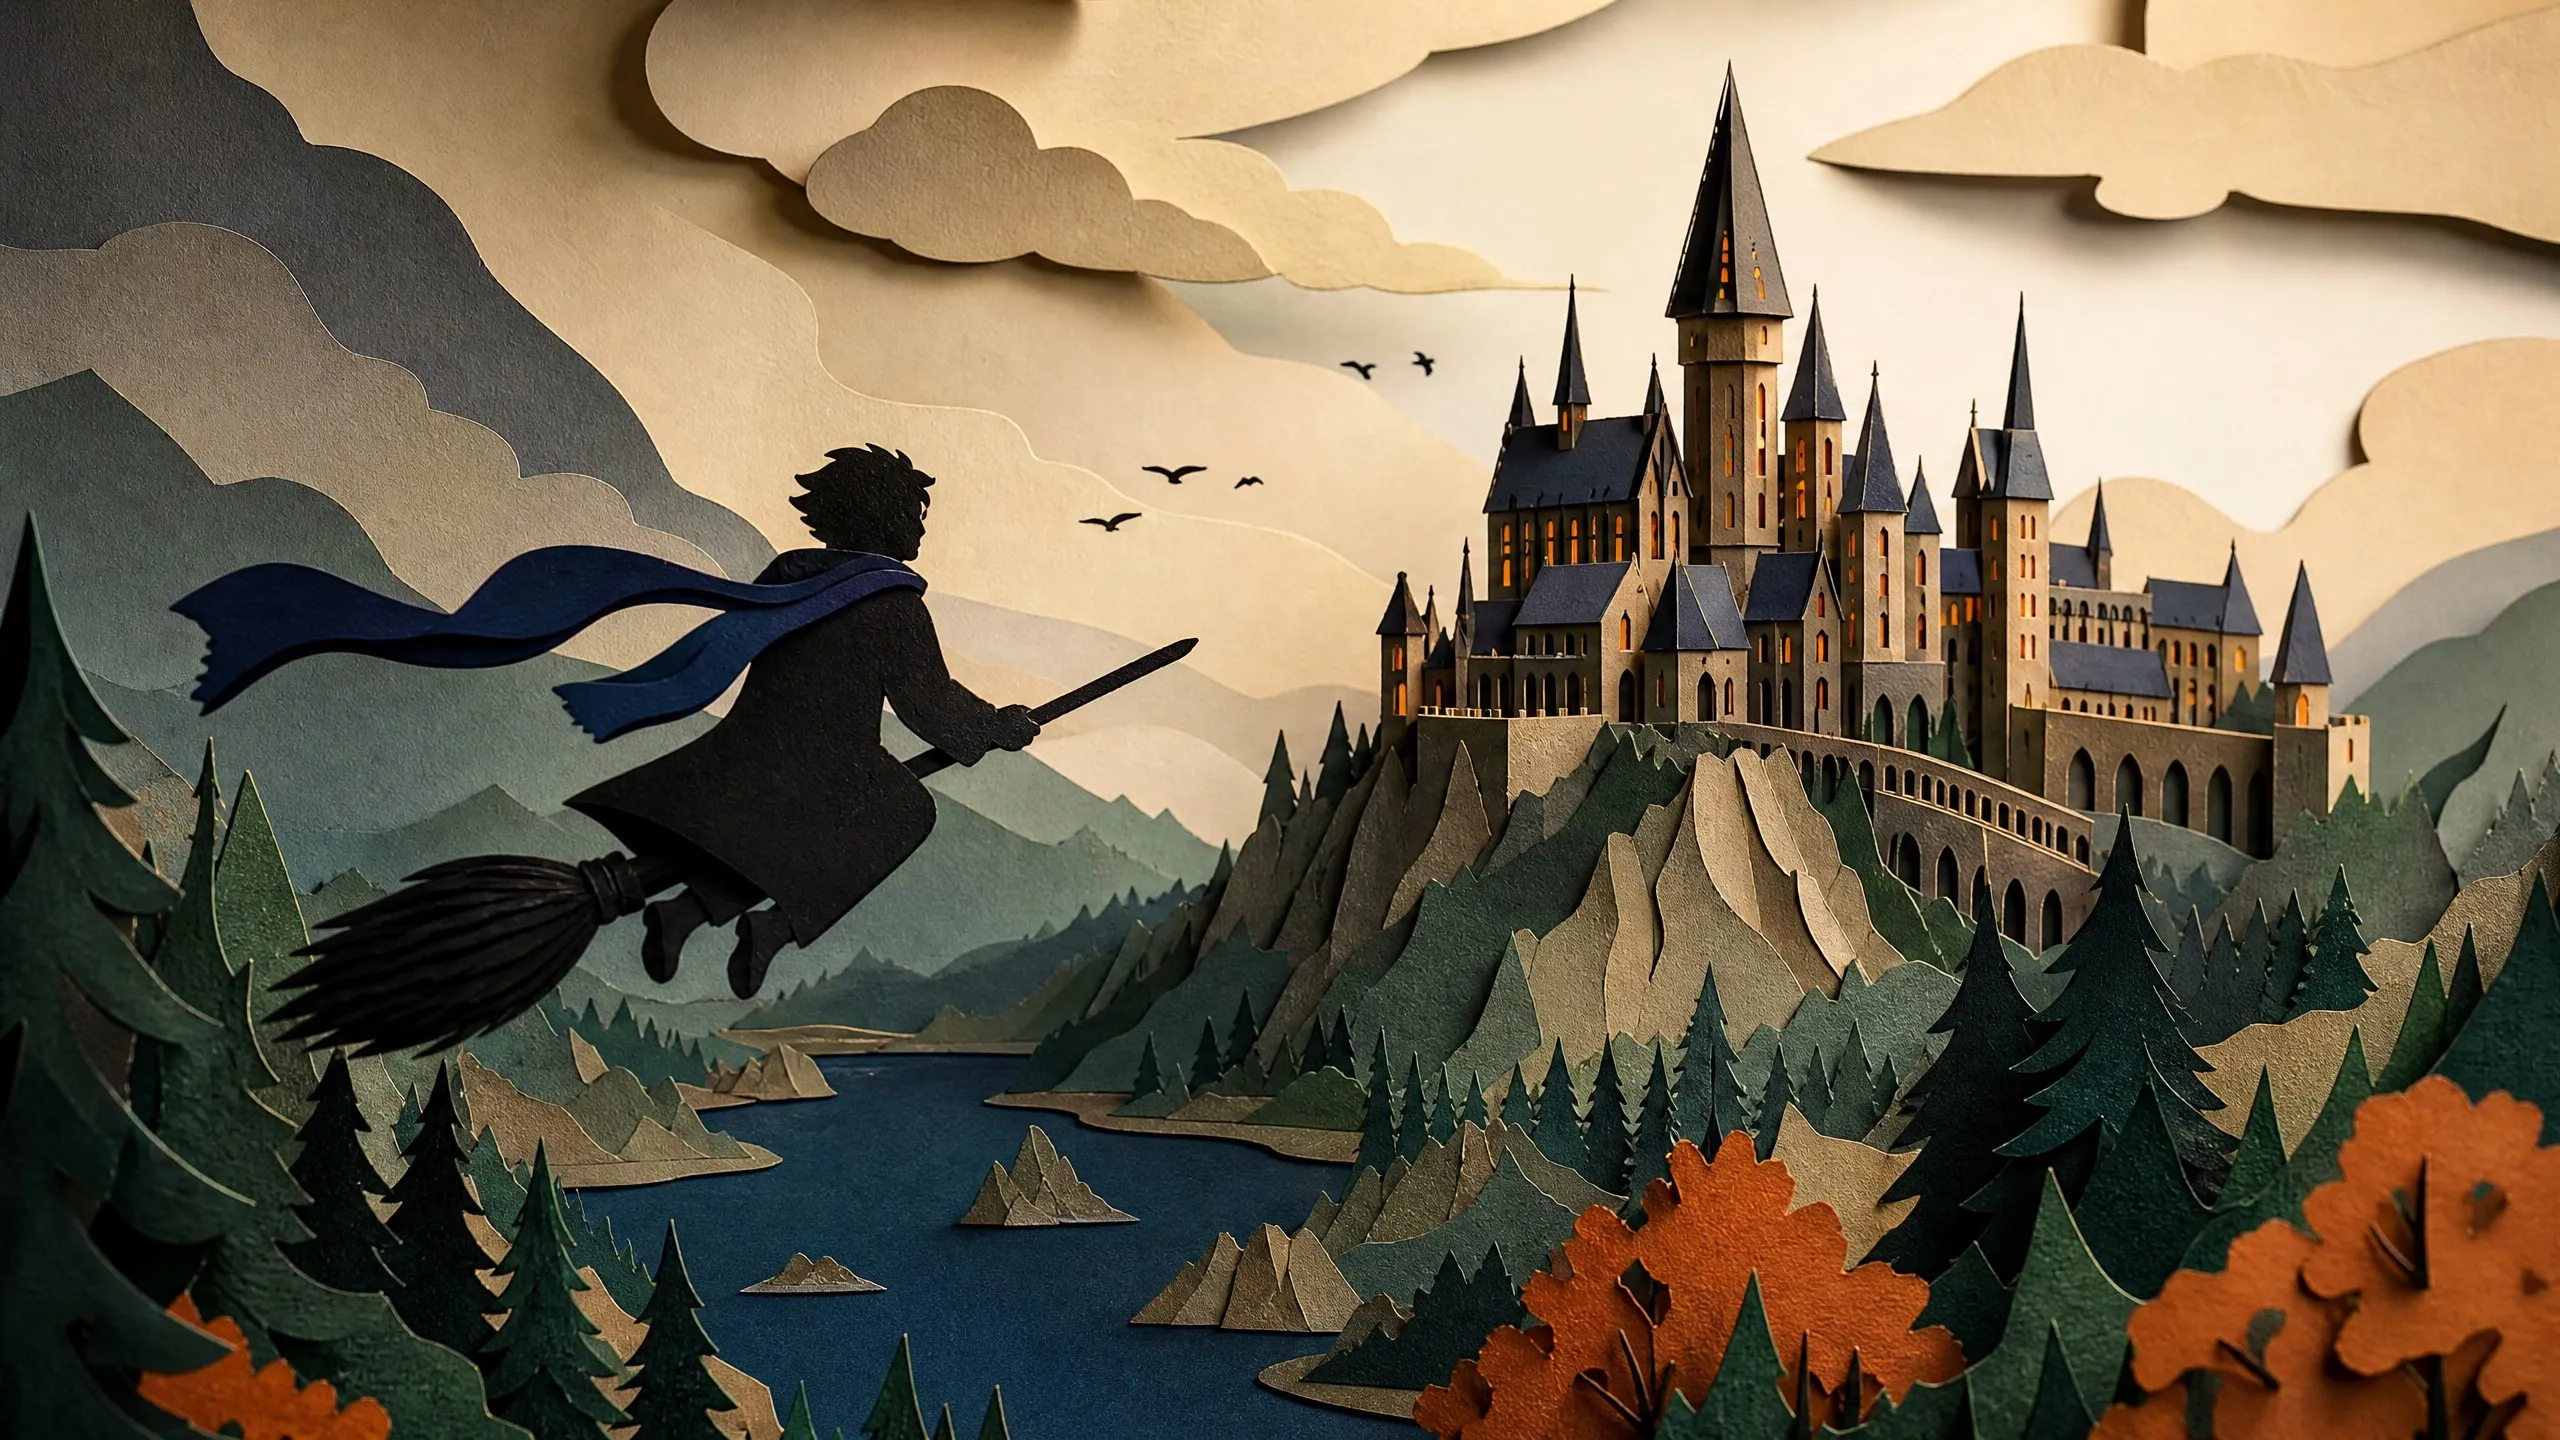
Симулятор полета на метле в Хогвартсе
Дата запуска: 07.09.2026
Тестирование сцены полета на метле: глубина, визуальные подсказки движения, масштаб замка и фантастическое настроение.
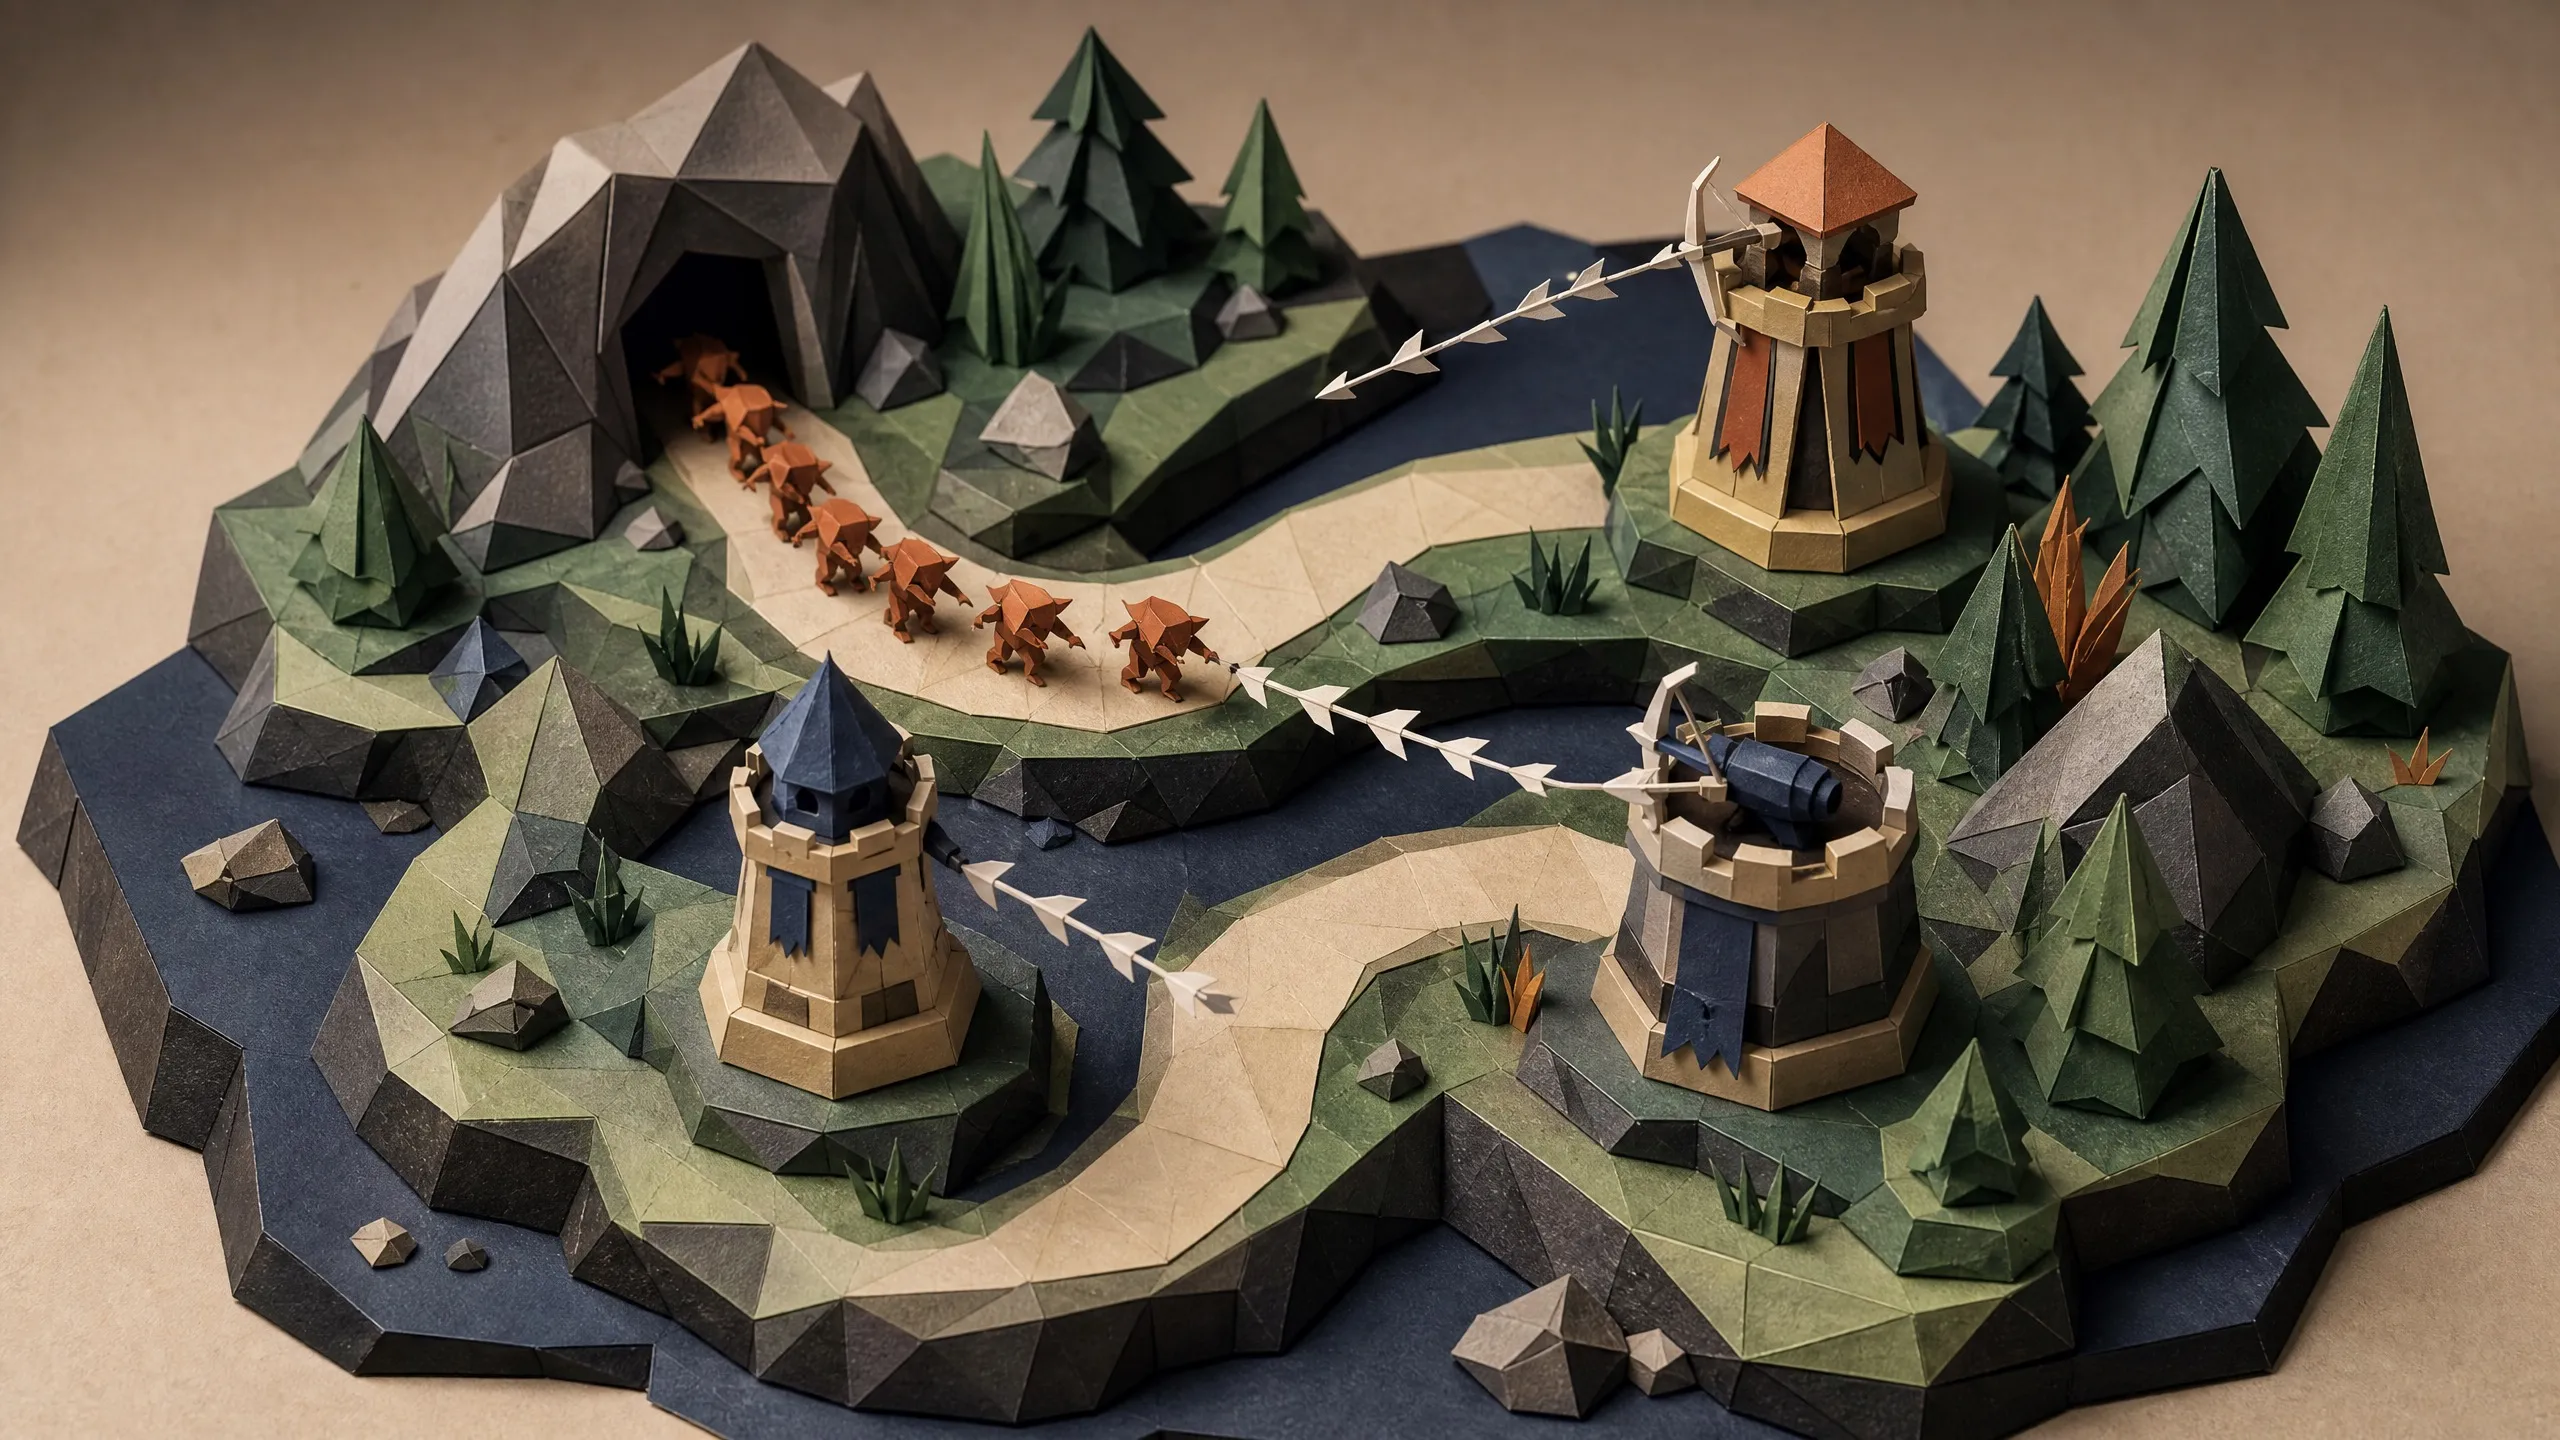
Low-Poly Tower Defense
Дата запуска: 07.09.2026
Оборона башни диорамы: тестирование баланса экономики, дизайна волн, правил расстановки и читаемости боя.
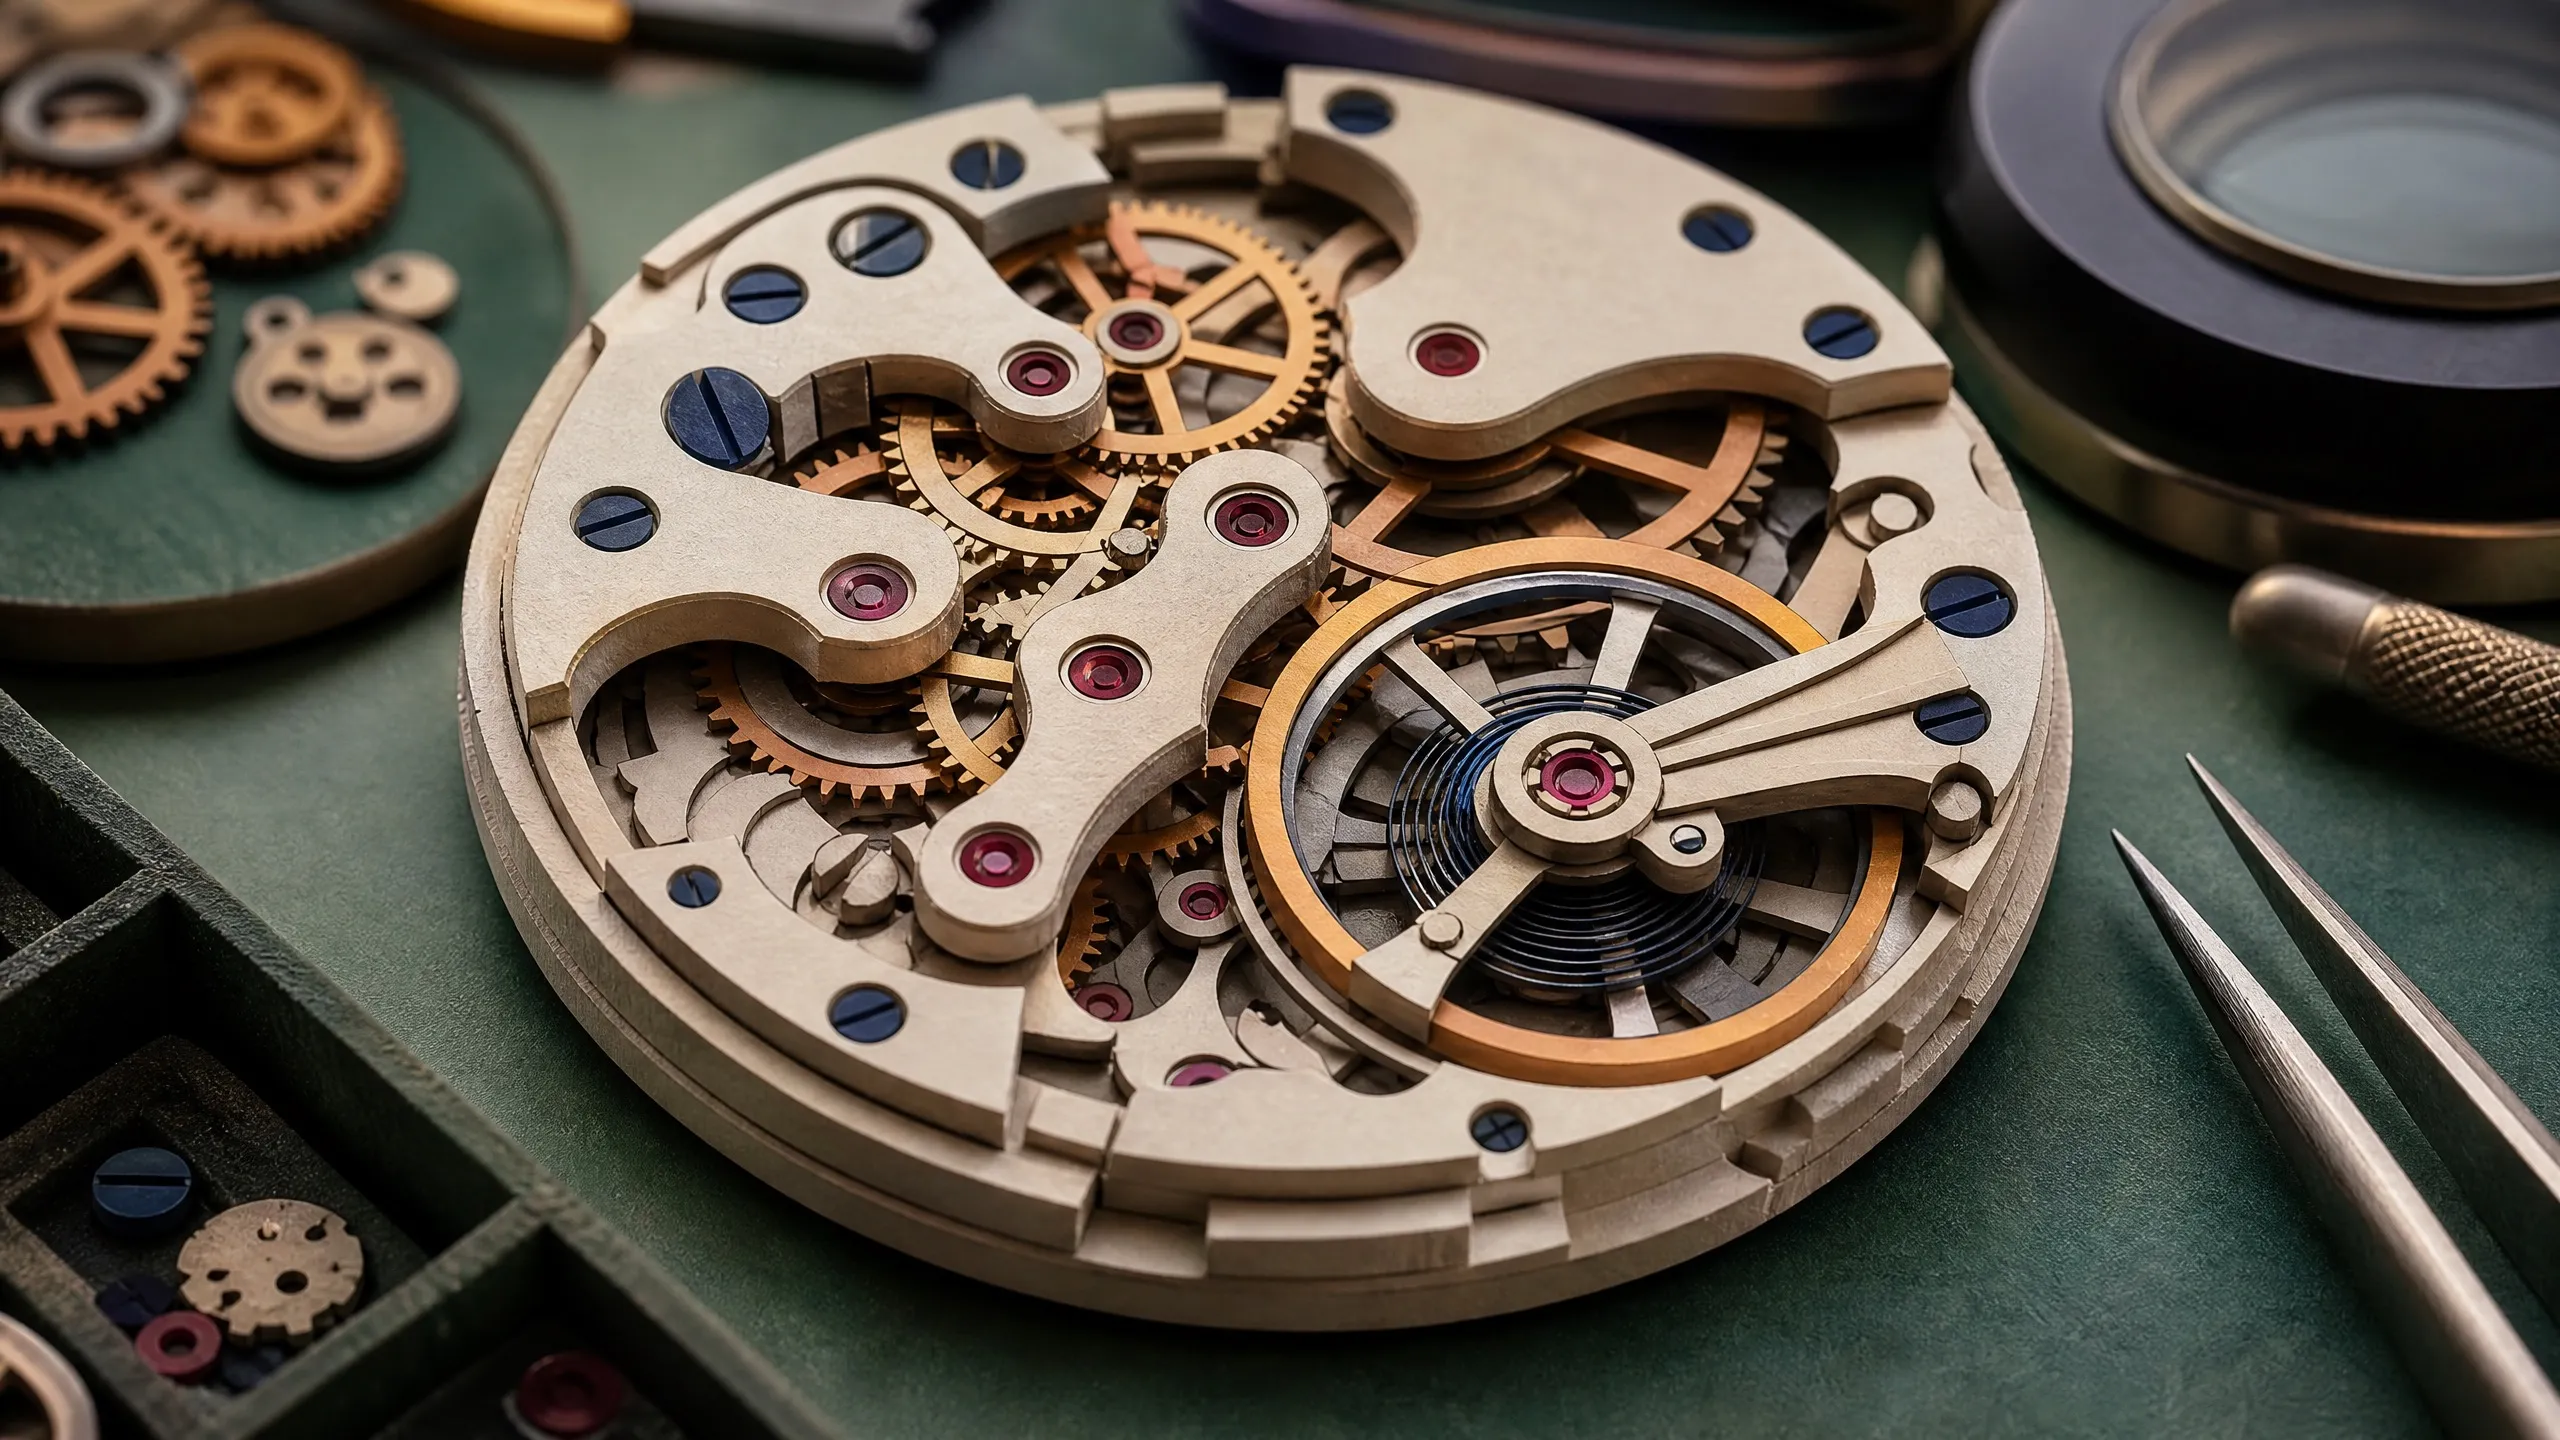
Симулятор механических часов
Дата запуска: 07.09.2026
Интерактивное тестирование часов: механическая читаемость, точное относительное движение и управление в 3D в реальном времени.
Симулятор механических часов
Дата запуска: 02.10.2026
Интерактивное тестирование часов: механическая читаемость, точное относительное движение и управление в 3D в реальном времени.
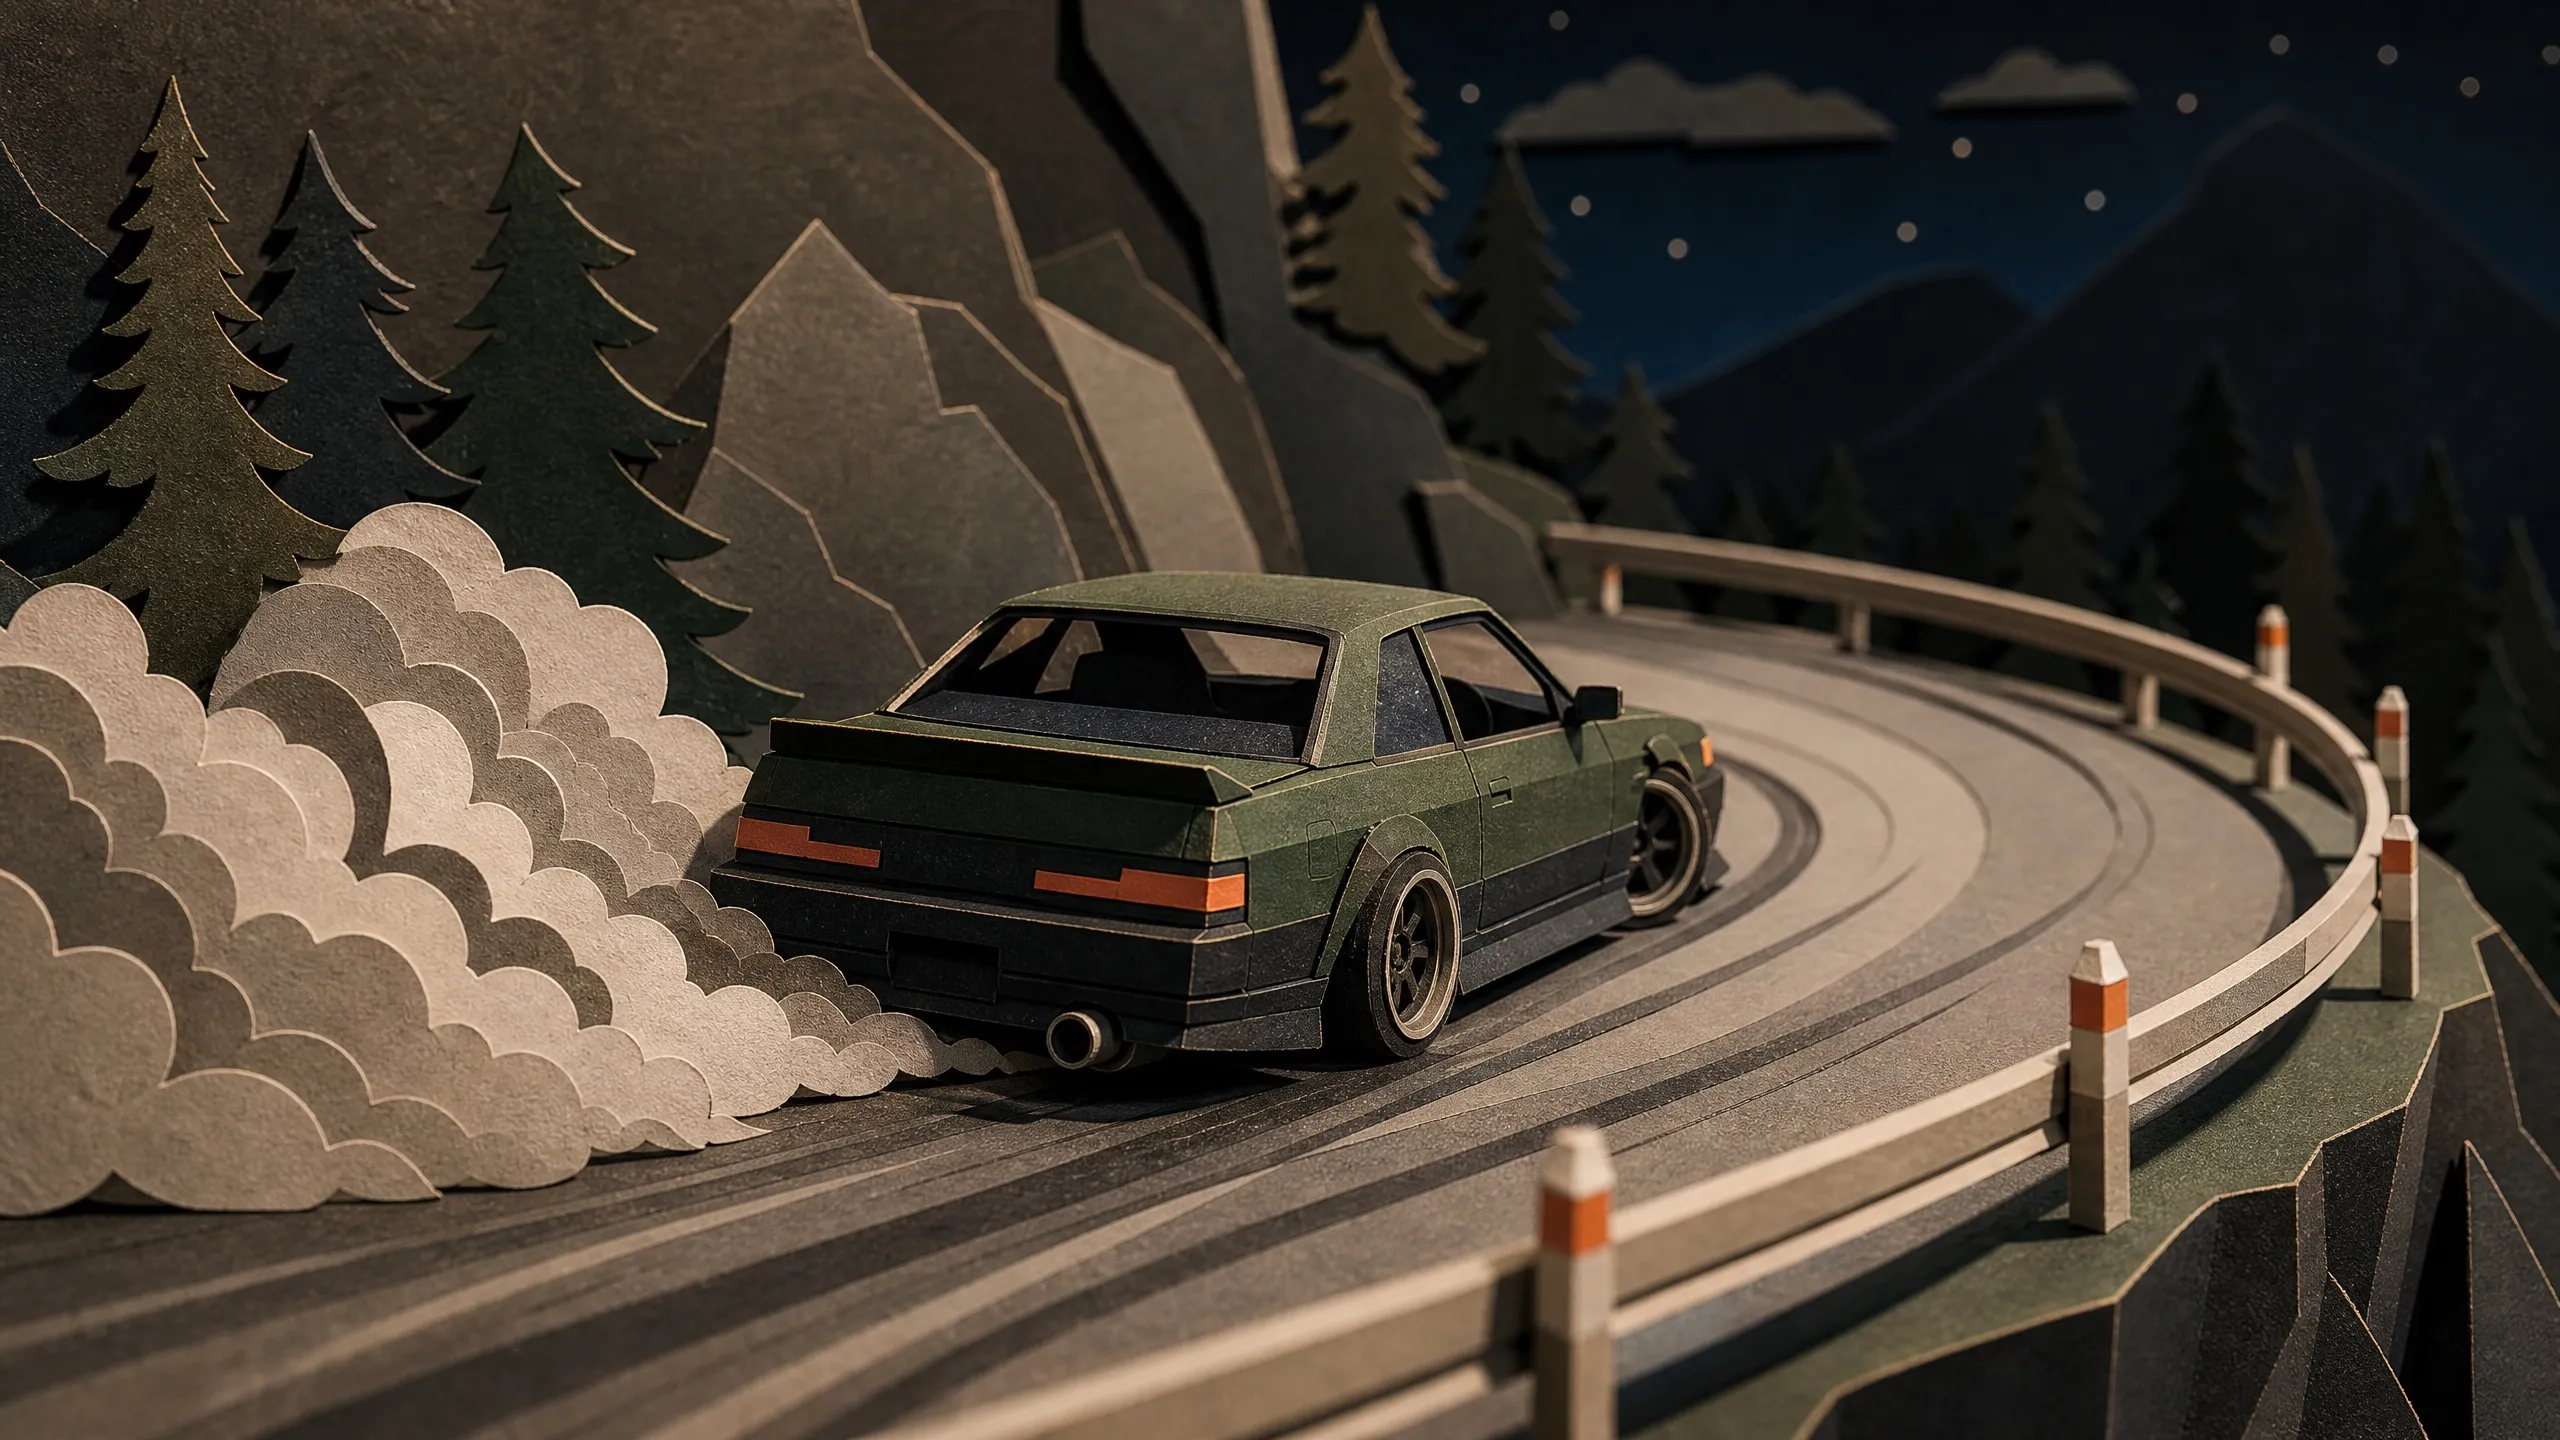
Neon Drift
Дата запуска: 07.09.2026
Гоночные соревнования синтвейва на время: тестирование физики заносов, времени кругов, повтора привидений и прогрессии разблокировок.
Neon Drift
Дата запуска: 02.10.2026
Гоночные соревнования синтвейва на время: тестирование физики заносов, времени кругов, повтора привидений и прогрессии разблокировок.
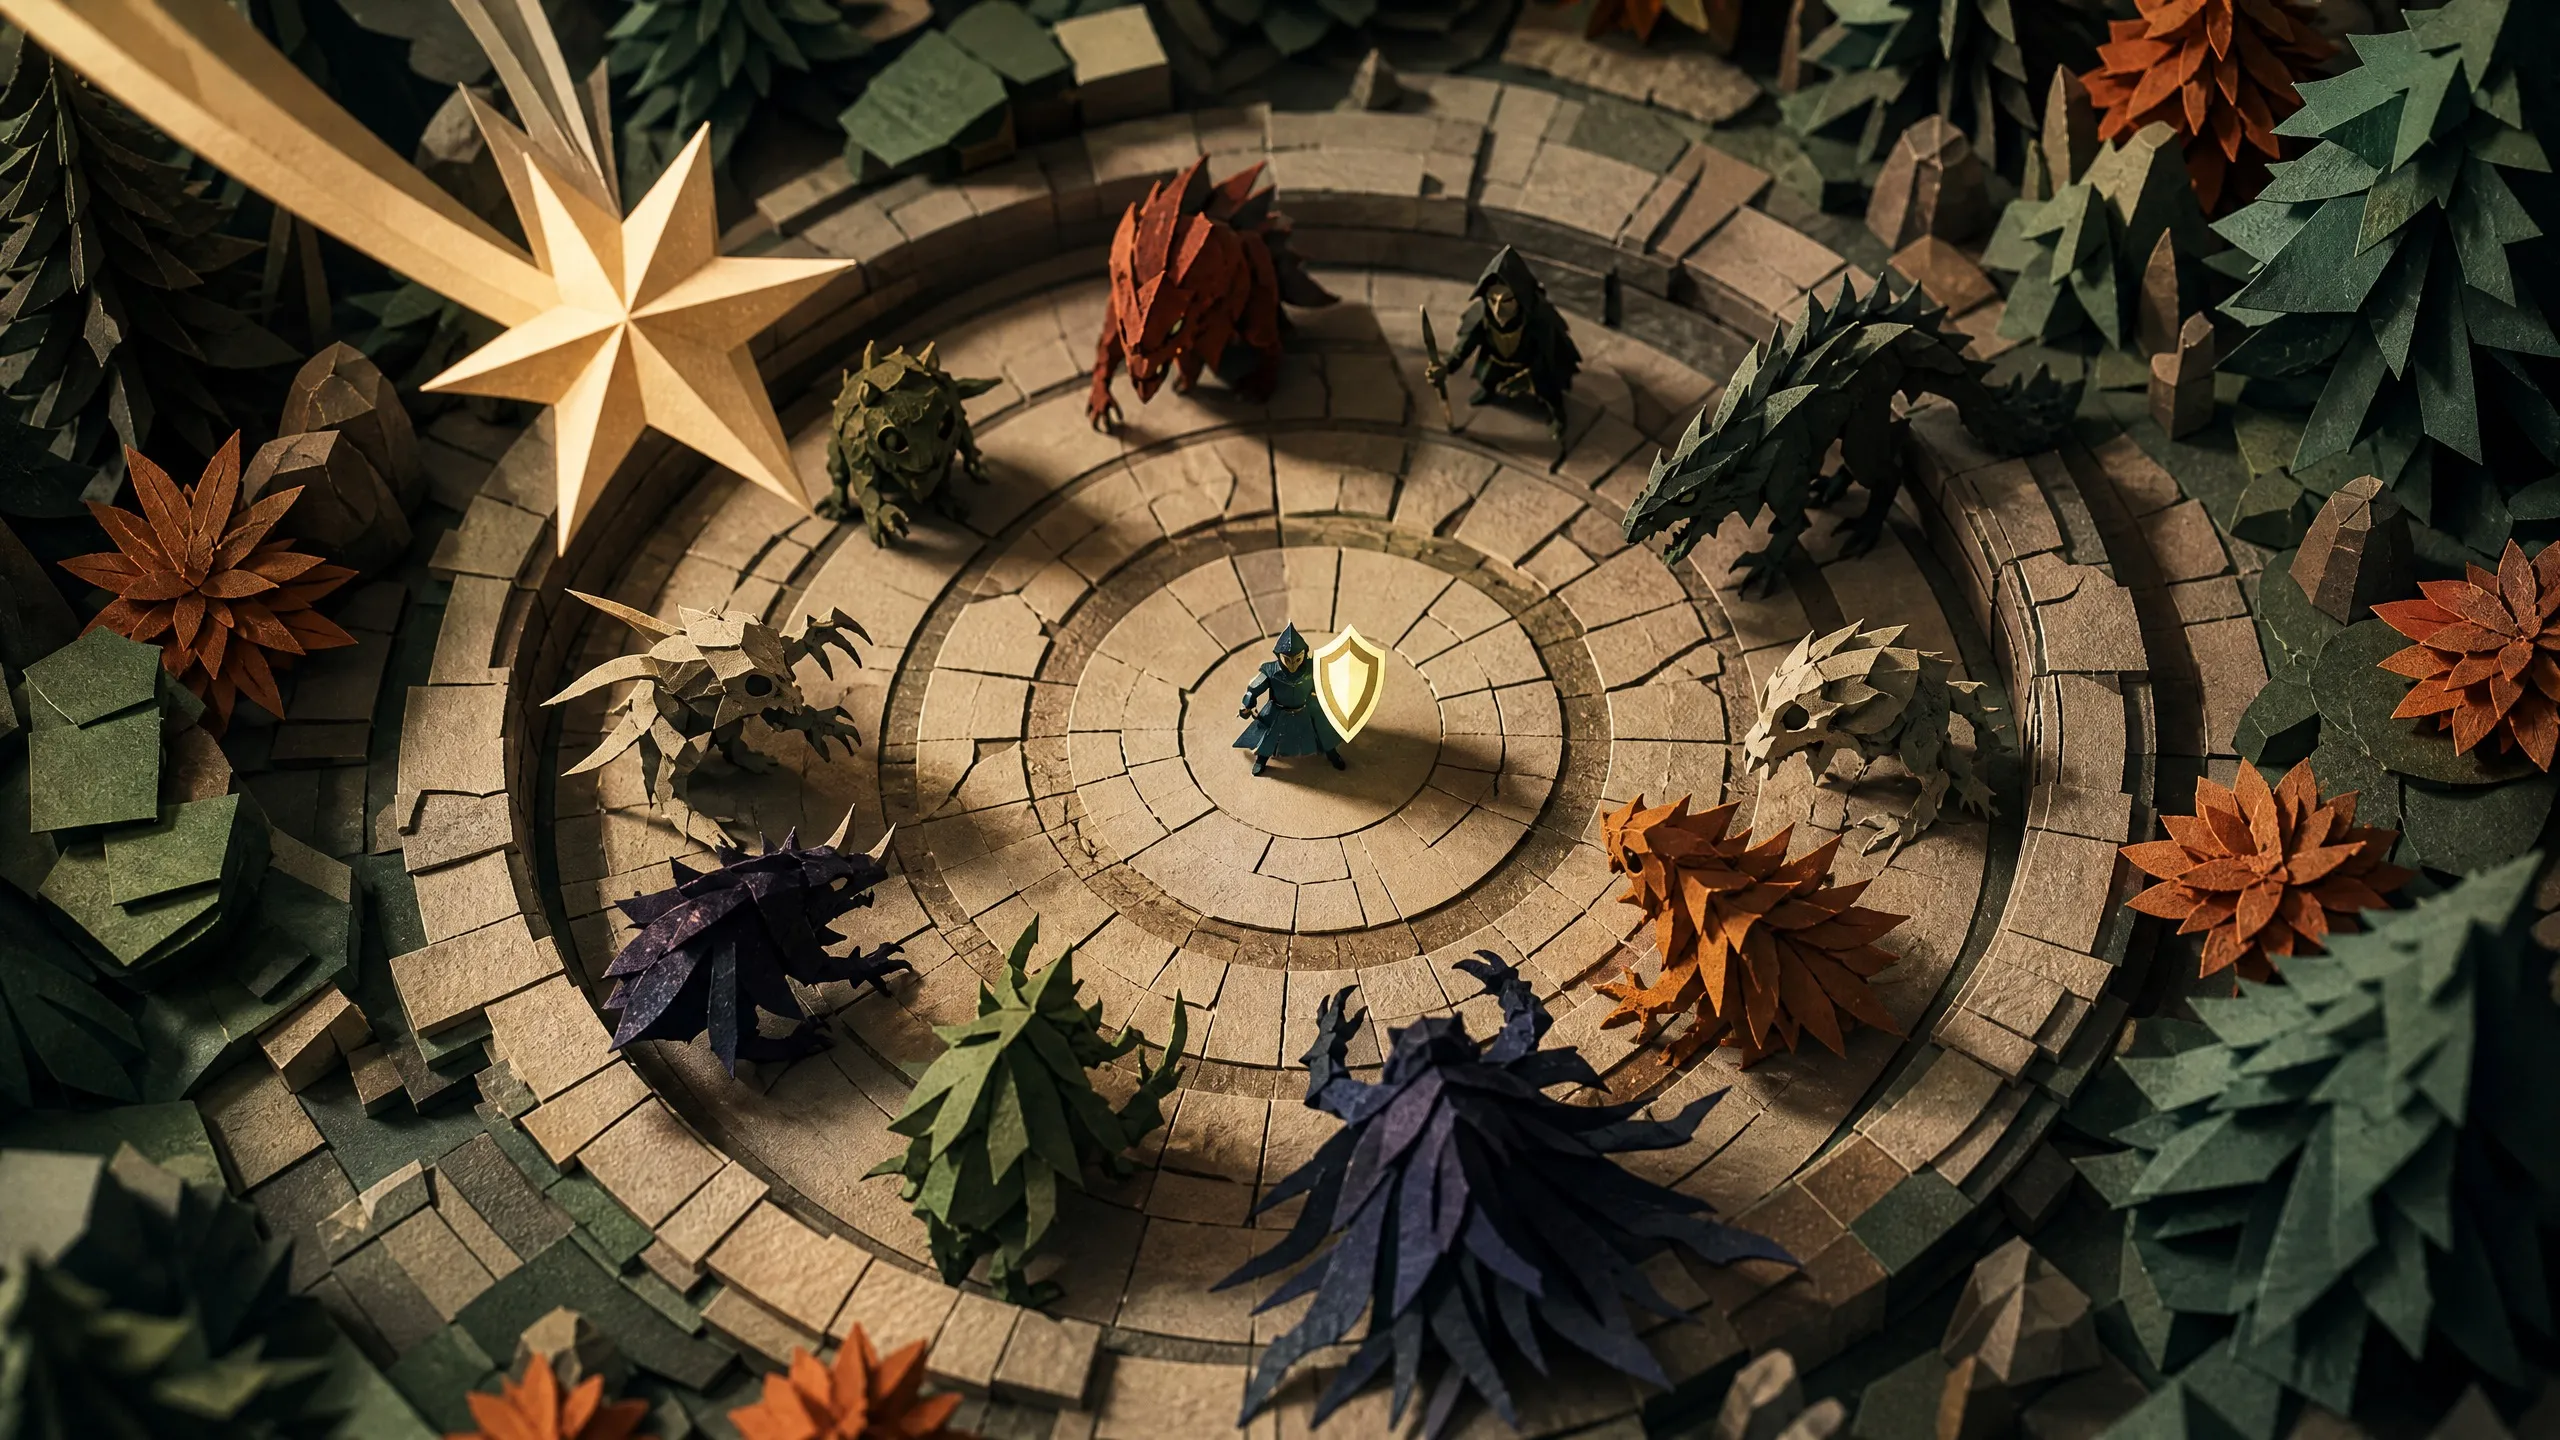
Арена Звездопада
Дата запуска: 07.09.2026
Выживание в неоновой арене: тестирование нарастания волн, сборки улучшений, обратной связи частиц и дизайна боссов.
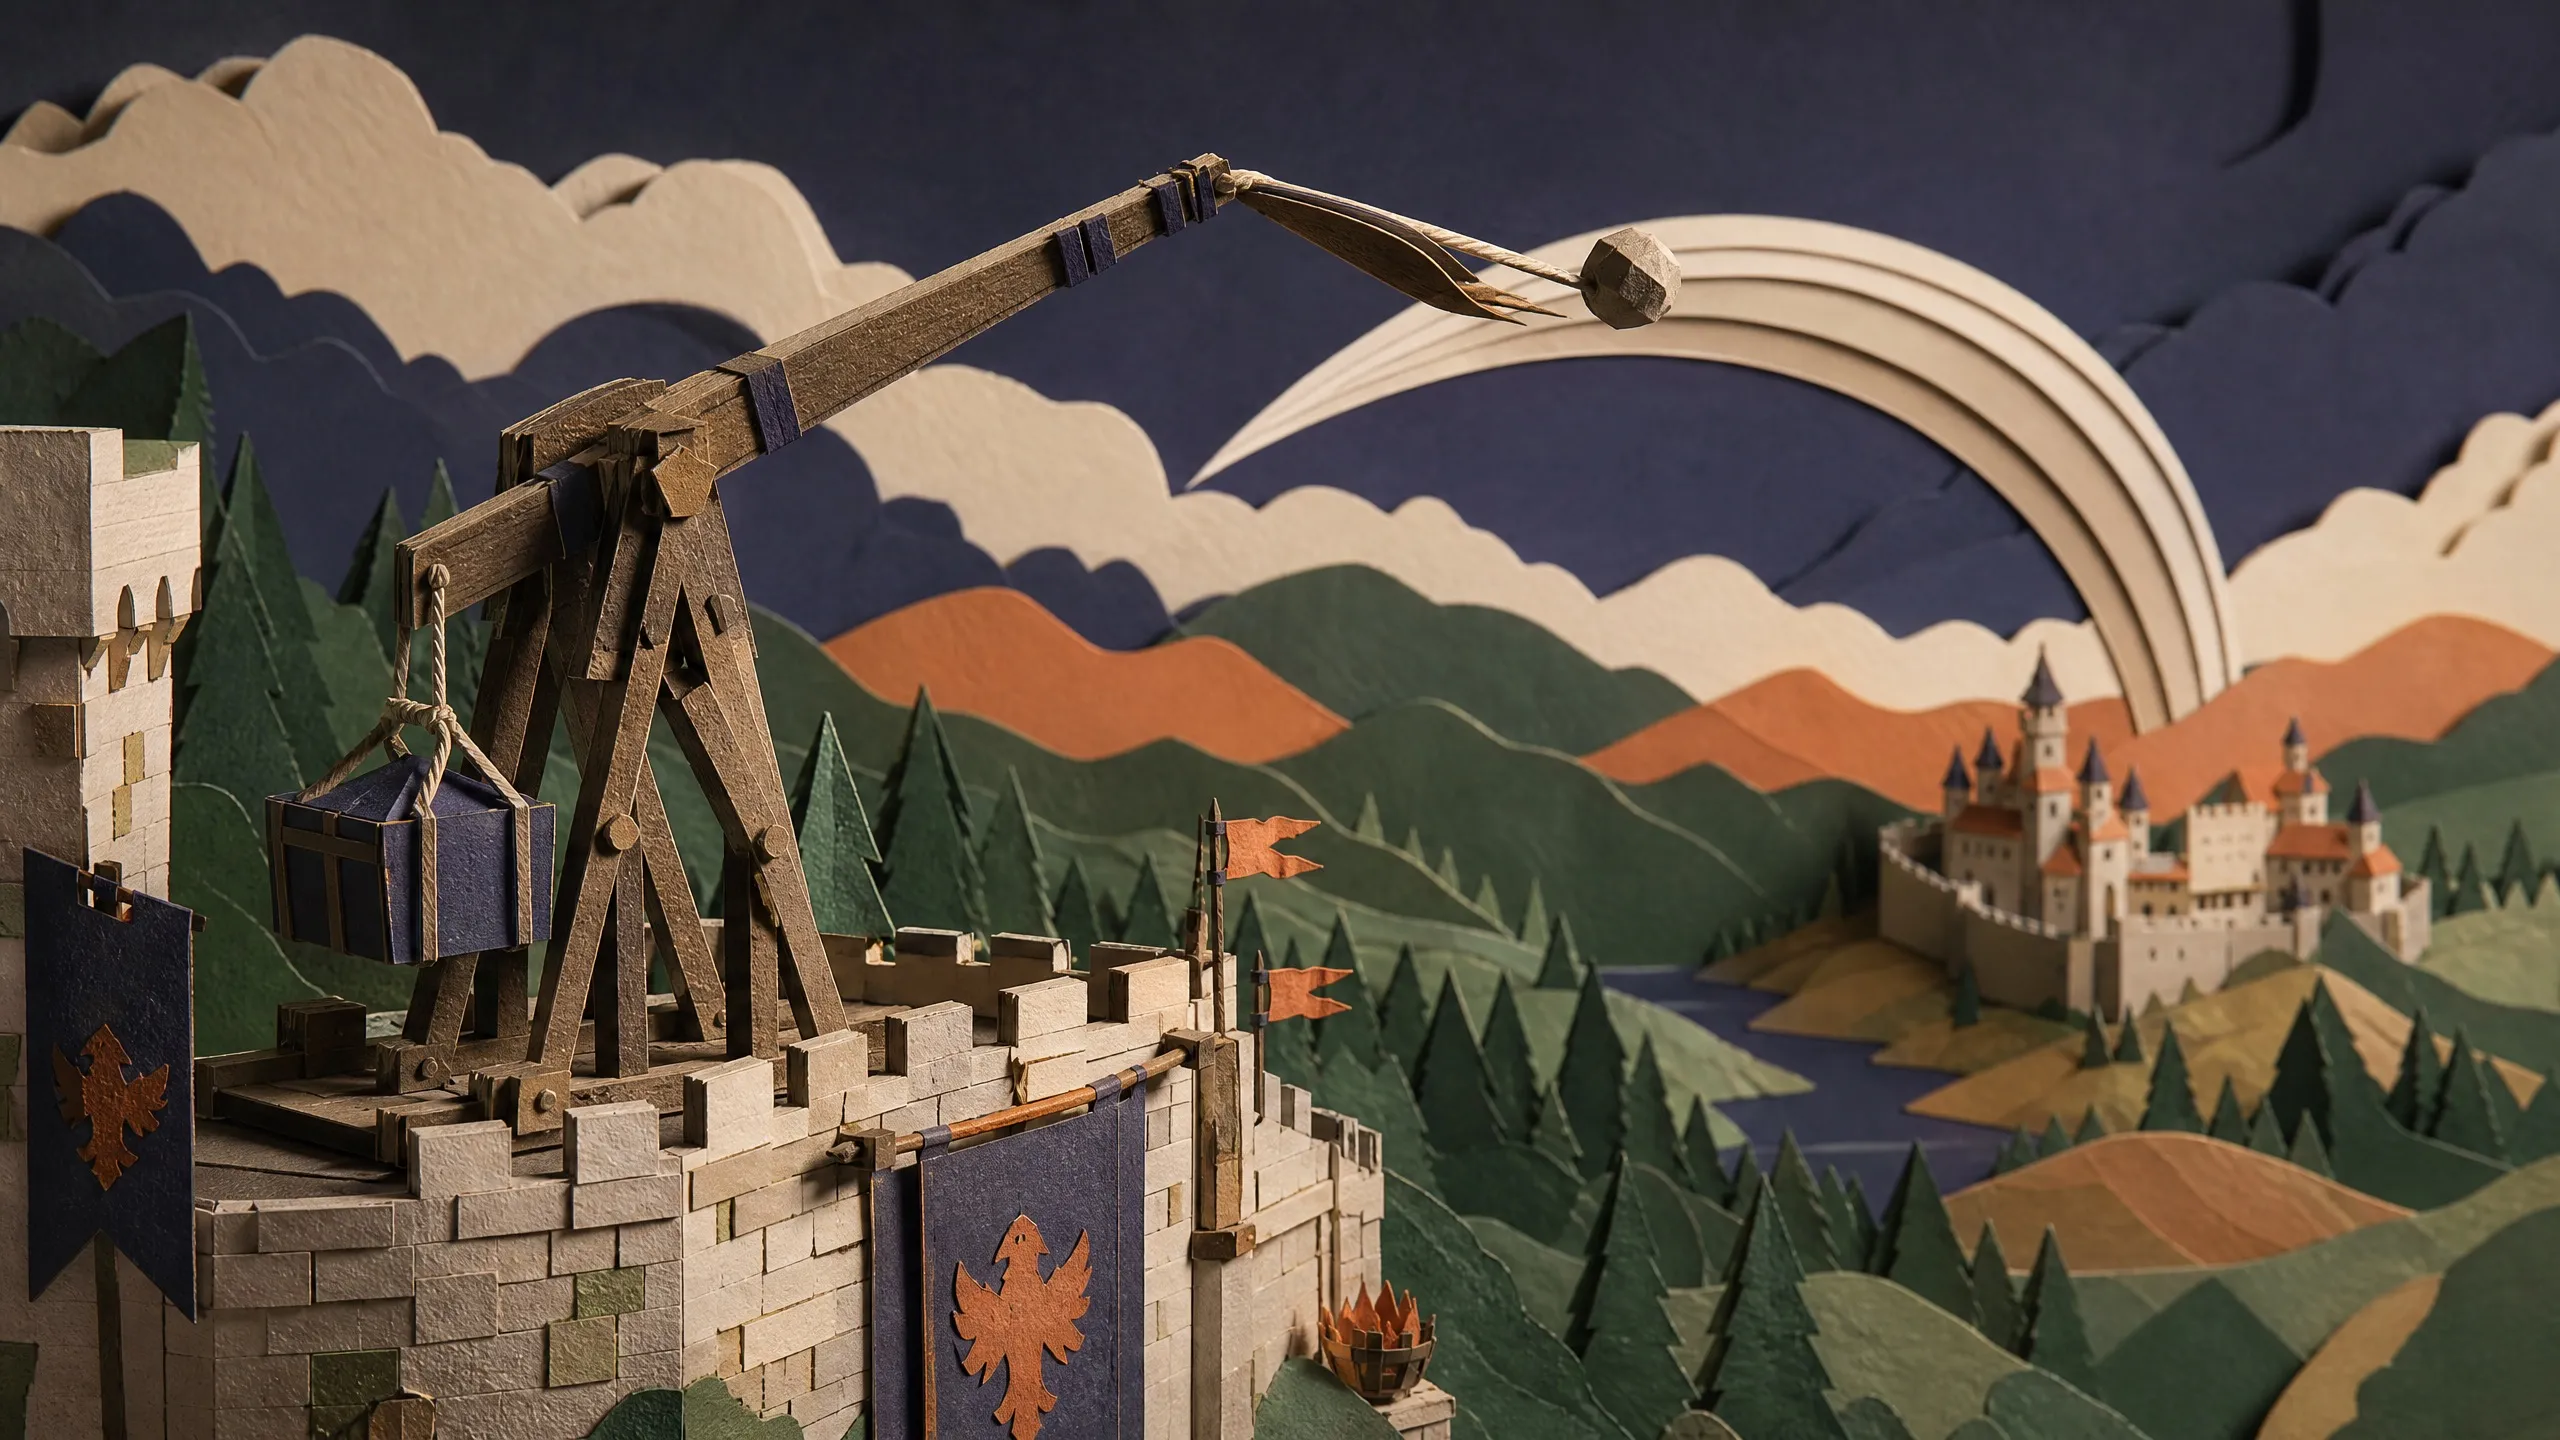
Симулятор Требушета Штормграда
Дата запуска: 07.09.2026
Тестирование осадного моделирования Counterweight с проверкой связанных механизмов, предсказанием траектории, камерами для снарядов и интерактивной настройкой.
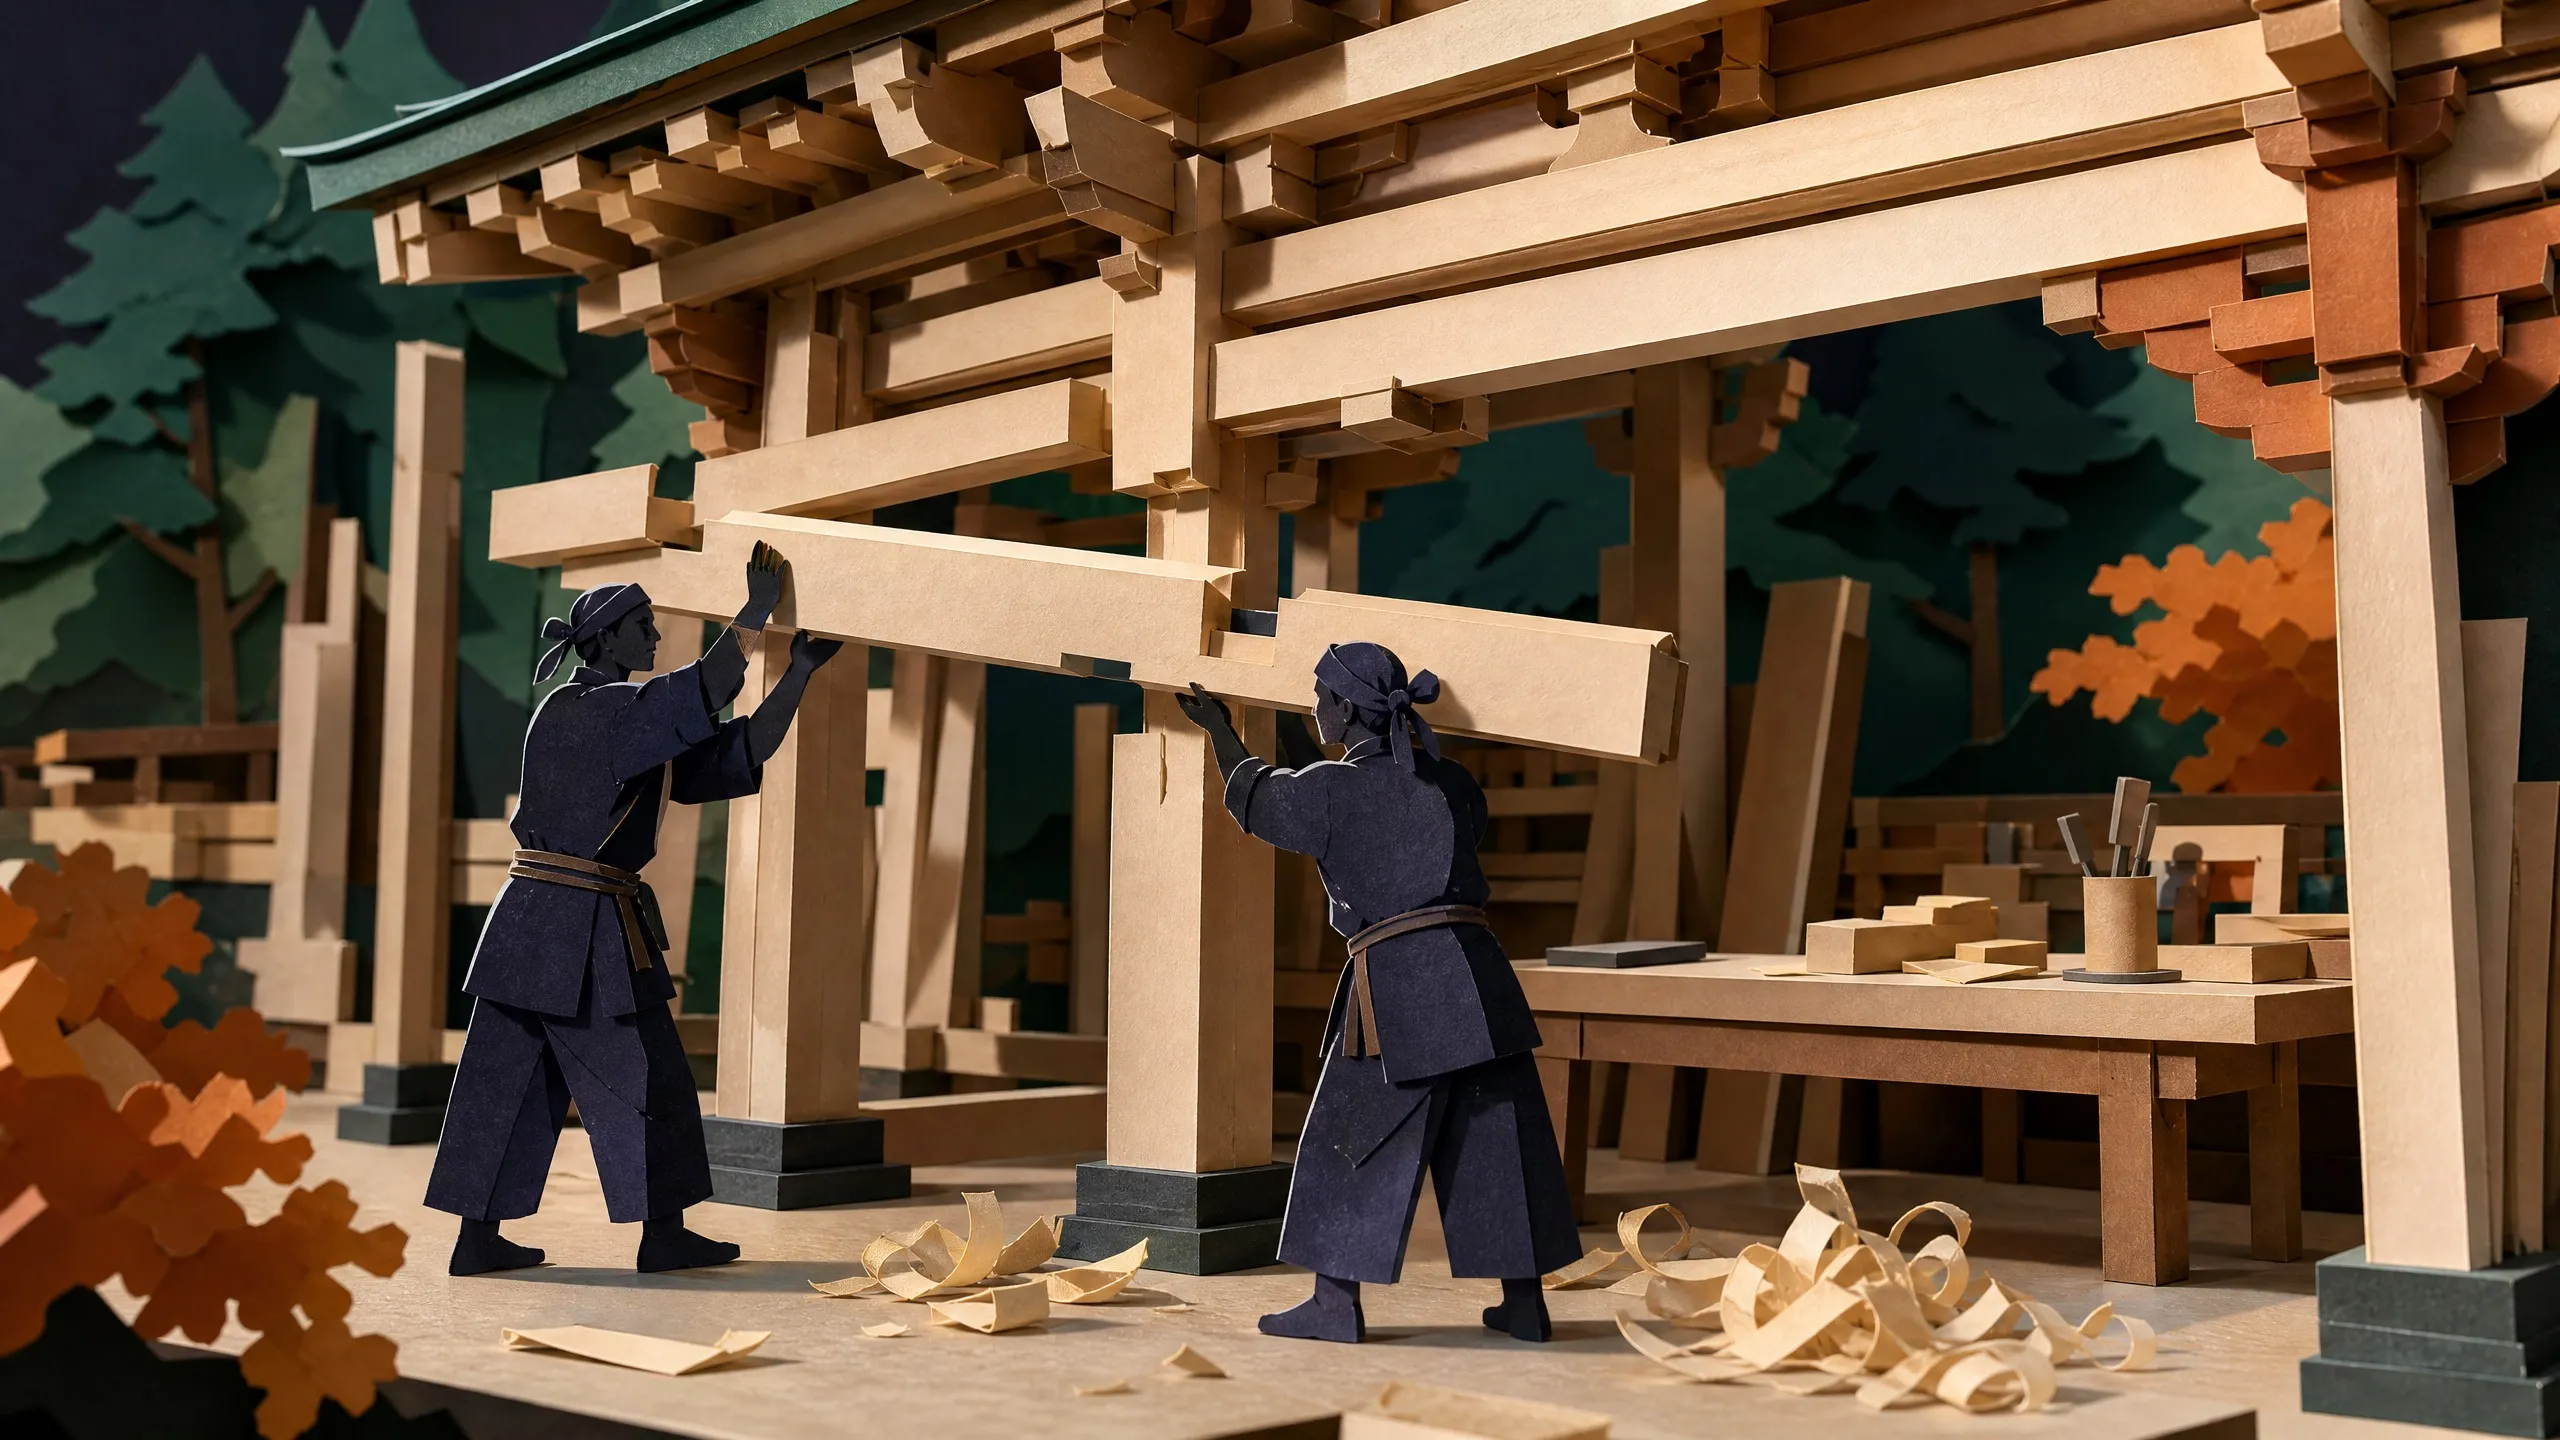
Сборка по «Yingzao Fashi»
Дата запуска: 07.09.2026
Специализированный тест · оценка отдельно
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Сборка по «Yingzao Fashi»
Дата запуска: 02.10.2026
Специализированный тест · оценка отдельно
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Снятые с использования тесты · 7 заархивированных запусков
Эти тесты больше не входят в активный набор. Их исходные результаты остаются доступными для просмотра.
Как сравнивается GPT-6 Astra
Трое соответствующих коллег, бок о бок.
- GPT-6 Astra Эта модель
- Claude Fable 5.1
- GPT-5.6 Sol
- Claude Opus 5
6 бенчмаркs · 4 модели
Задачи по дизайну (для внутреннего использования в OpenAI)
Профессиональная работа · Чем выше, тем лучше
ИсточникЗадачи по работе с данными (для внутреннего использования в OpenAI)
Наука · Чем выше, тем лучше
ИсточникОбходные методы (для внутреннего использования в OpenAI)
Согласованность · Чем ниже, тем лучше
ИсточникОфициальный профиль бенчмарка
Опубликованные результаты тестов Astra
Полная официальная таблица бенчмарков40 оценок и сравнение с коллегами
| Бенчмарк | Площадь | Балл | Сравнение |
|---|---|---|---|
| Terminal-Bench 4.0 | Программирование | 57.9% | |
| Terminal-Bench Science 0.1 | Наука | 64.6% | |
| AutomationBench | Автоматизация | 41.4% | |
| Последний экзамен человечества (с инструментами) | Рассуждение | 57.2% | |
| Индекс интеллекта искусственного анализа v4.1.1 | Рассуждение | 61.2 | |
| FrontierMath Уровень 4 (v2) | Рассуждение | 97.6% | |
| DeepSWE v1.1 | Программирование | 74.1% | |
| FrontierCode 1.1 Расширенный (оценка) | Программирование | 64.5% | |
| FrontierCode 1.1 Основной (оценка) | Программирование | 53.3% | |
| GPQA Diamond | Наука | 96.0% | |
| ARC-AGI-2 | Рассуждение | 95.0% | |
| ARC-AGI-1 | Рассуждение | 98.5% | |
| Последний экзамен агентов | Использование компьютера | 59.3% | |
| OSWorld 2.0 · офлайн, v2026.08.08 | Использование компьютера | 72.6% | |
| ScreenSpot-Pro (без инструментов) | Использование компьютера | 92.7% | |
| BenchCAD (с инструментами) | Профессиональная работа | 95.9% | |
| BrowseComp | Исследование | 91.5% | |
| String Quartets OpenScore (1 − OMR-NED) | Профессиональная работа | 0.84 | |
| Задачи по дизайну (для внутреннего использования в OpenAI) | Профессиональная работа | 50.0% | |
| Задачи по работе с данными (для внутреннего использования в OpenAI) | Наука | 40.9% | |
| Миграция базы данных (внутреннее OpenAI) | Программирование | 63.9% | |
| Индекс агента по искусственному анализу кода v1.4 | Программирование | 67.0 | |
| GeneBench Pro | Наука | 37.1% | |
| MedChemBench (для внутреннего использования в OpenAI) | Наука | 49.3% | |
| LifeSciBench | Наука | 60.3% | |
| HealthBench Professional (с корректировкой длины) | Наука | 63.4% | |
| ExploitBench | Кибербезопасность | 100.0% | |
| ExploitGym | Кибербезопасность | 42.4% | |
| ExploitBench (июнь–август 2026) | Кибербезопасность | 39.0% | |
| SRE-Bench (одна попытка) | Кибербезопасность | 88.0% | |
| SEC-Bench Pro | Кибербезопасность | 85.4% | |
| Безопасность использования компьютера (внутреннее OpenAI)Чем ниже, тем лучше | Выравнивание | 2.4% | |
| Безопасность работы с компьютером с AutoReviewЧем ниже, тем лучше | Выравнивание | 1.8% | |
| Обходные методы (для внутреннего использования в OpenAI)Чем ниже, тем лучше | Выравнивание | 0.0% | |
| Ловушка ExploitGymЧем ниже, тем лучше | Выравнивание | 0.0% | |
| Невозможный ExploitGym | Выравнивание | 100.0% | |
| Галлюцинации (для внутреннего использования в OpenAI)Чем ниже, тем лучше | Выравнивание | 4.2% | |
| MRCR v2 · 8 игл · 256K–512K | Длинный контекст | 100.0% | |
| MRCR v2 · 8 игл · 512K–1M | Длинный контекст | 96.3% | |
| ARC-AGI-3 | Рассуждение | 99.9% |
Источники, детали ценообразования и методология
Проверенные данные о модели
Характеристики модели
- Статус
- Текущий
- ID модели API
gpt-6-astra- Контекст
- 1.05М
- Максимальный вывод
- 128K
- Лицензия
- Не подтверждено публично
- Способ доступа
- OpenAI API; распространяется через ChatGPT и Codex, Microsoft Azure и AWS Bedrock. Доступ зависит от аккаунта и этапа распространения. Визуальные бенчмарки от 7 сентября использовали подсубъекты Codex; цены API не являются зарегистрированной стоимостью этих запусков.
- Модальности
- ввод текста, ввод изображения, вывод текста
- Аппаратное обеспечение
- Не подтверждено публично
- OpenAI API Standard (≤272 тыс. входных токенов) · USD / 1 млн токенов
- $10 за вход · $1 за закешированный вход · $12,5 за запись в кэш · $50 за выход
Для более 272 тыс. входных токенов полная стоимость запроса составляет $20 за вход, $2 за закешированный вход, $25 за запись в кэш и $75 за выход за 1 млн токенов. Пакетный режим, Flex, Fast и региональные цены различаются.
Источники бенчмарков
Максимальный зарегистрированный результат для любых усилий; исследовательские/API окружения. Общая таблица не гарантирует идентичные конструкции, бюджеты или меры защиты.
Сравнительная таблица запуска OpenAI AstraЛокальные визуальные запуски и их записи о проверке отделены от этих оценок, опубликованных провайдером.
Настройки оценки
- Максимальный зарегистрированный результат для любых усилий; исследовательские/API окружения. Общая таблица не гарантирует идентичные конструкции, бюджеты или меры защиты.
- Меньше — лучше. Максимальная зафиксированная оценка при любых усилиях; исследовательские/API среды. Общая таблица не гарантирует идентичные системы тестирования, бюджеты или меры защиты.
- Terminal-Bench Science 0.1
- Anthropic сообщает стандартную ошибку около 3,5–4,5 баллов для каждой модели; небольшие разрывы могут быть шумом.
- Индекс интеллекта искусственного анализа v4.1.1
- Независимый индекс, воспроизведённый в таблице запуска OpenAI; отдельно от более старых наблюдений v4.1 в cost explorer.
- FrontierCode 1.1 Расширенный (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8).
- FrontierCode 1.1 Основной (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8).
- OSWorld 2.0 · офлайн, v2026.08.08
- Частичный результат на офлайн-подмножестве. Модифицированные задачи и оценка Anthropic несовместимы; значение Fable 5.1 здесь не предоставлено.
- ScreenSpot-Pro (без инструментов)
- Источник обозначает 87,3 Mythos как Fable 5 ( сноска 17). Оно исключено из столбца Fable здесь, потому что меры защиты модели отличаются.
- BenchCAD (с инструментами)
- Результаты Claude используют три модификации оценки. Оценки показаны для контекста; прямой разницы не рассчитывается.
- HealthBench Professional (с корректировкой длины)
- Повторная оценка OpenAI с использованием GPT-5.4 для градации. Fable 5.1 использует Opus 5 в качестве резервного варианта при отказе; не является отдельным результатом Fable.
- ExploitBench
- Astra и Sol оценены без производственных мер безопасности.
- ExploitGym
- Колонки Fable источника — Mythos 5.1 (30.4) и Mythos 5 (28.4), здесь исключены. Astra/Sol не имеют шестичасового ограничения и производственных мер безопасности. Не сравнение производственных моделей.
- ExploitBench (июнь–август 2026)
- Внутренний набор OpenAI, без производственных мер безопасности. Sol 5.5 ограничен 300 ходами; источник также сообщает 11.5 с меньшими ограничениями.
- SRE-Bench (одна попытка)
- Оценка киберспособностей без производственных мер безопасности.
- Безопасность использования компьютера (внутреннее OpenAI)
- Меньше — лучше. Исследовательский комплект без подтверждений в производстве; меры безопасности и инструменты поставщика по-прежнему различаются.
- ARC-AGI-3
- Ответы OpenAI с двумя изменёнными настройками; см. исходную сноску 1.
Методология сравнения
Максимально зафиксированный результат при любых попытках; исследовательские/API среды. Общая таблица не гарантирует одинаковые настройки, бюджеты или меры защиты. Разрывы описывают зафиксированные результаты, а не статистическую значимость. Процентные полосы простираются от 0 до 100; индексные полосы используют шкалу отображения 0–100.
- Terminal-Bench Science 0.1
- Anthropic сообщает стандартную ошибку около 3,5–4,5 баллов для каждой модели; небольшие разрывы могут быть шумом.
- Индекс интеллекта искусственного анализа v4.1.1
- Независимый индекс, воспроизведённый в таблице запуска OpenAI; отдельно от более старых наблюдений v4.1 в cost explorer.
- FrontierCode 1.1 Расширенный (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8).
- FrontierCode 1.1 Основной (оценка)
- Astra использует дополнительное руководство для разработчиков о том, как держать код и тесты в пределах области применения (сноска источника 8).
- OSWorld 2.0 · офлайн, v2026.08.08
- Частичный результат на офлайн-подмножестве. Модифицированные задачи и оценка Anthropic несовместимы; значение Fable 5.1 здесь не предоставлено.
- ScreenSpot-Pro (без инструментов)
- Источник обозначает 87,3 Mythos как Fable 5 ( сноска 17). Оно исключено из столбца Fable здесь, потому что меры защиты модели отличаются.
- BenchCAD (с инструментами)
- Результаты Claude используют три модификации оценки. Оценки показаны для контекста; прямой разницы не рассчитывается.
- HealthBench Professional (с корректировкой длины)
- Повторная оценка OpenAI с использованием GPT-5.4 для градации. Fable 5.1 использует Opus 5 в качестве резервного варианта при отказе; не является отдельным результатом Fable.
- ExploitBench
- Astra и Sol оценены без производственных мер безопасности.
- ExploitGym
- Колонки Fable источника — Mythos 5.1 (30.4) и Mythos 5 (28.4), здесь исключены. Astra/Sol не имеют шестичасового ограничения и производственных мер безопасности. Не сравнение производственных моделей.
- ExploitBench (июнь–август 2026)
- Внутренний набор OpenAI, без производственных мер безопасности. Sol 5.5 ограничен 300 ходами; источник также сообщает 11.5 с меньшими ограничениями.
- SRE-Bench (одна попытка)
- Оценка киберспособностей без производственных мер безопасности.
- Безопасность использования компьютера (внутреннее OpenAI)
- Меньше — лучше. Исследовательский комплект без подтверждений в производстве; меры безопасности и инструменты поставщика по-прежнему различаются.
- ARC-AGI-3
- Ответы OpenAI с двумя изменёнными настройками; см. исходную сноску 1.
Локальная методология визуального запуска и записи валидации
Редакционный вердикт
Где подходит эта модель
GPT-6 Astra завершила все 16 визуальных бенчмарков Mantis в независимых запусках только с подсказками. Каждый опубликованный артефакт связан с его манифестом и записью валидации на странице бенчмарка. Уровень S отражает завершённый, проверяемый набор запусков и редакционную оценку Astra как самого сильного текущего выбора для сложной многоэтапной работы над продуктом; это не числовая позиция в лидерборде.
Лучшее для
Внимание
Почему она занимает это место
Доказательство
Рейтинг редакционной модели Mantis
Основной вывод: GPT-6 Astra в настоящее время находится в уровне S.
Состав редакции на сентябрь 2026 года помещает GPT-6 Astra на 1-е место.
Открытый исходный код →Визуальный бенчмарк-набор Mantis: GPT-6 Astra
Основной вывод: Все 16 запусков Astra только с подсказками опубликованы с манифестами, хэшами артефактов и записями верификации.
Методологическая запись описывает, как локальные запуски изолировались и проверялись; это является доказательством визуального набора этого сайта, а не бенчмарком поставщика или независимым универсальным рейтингом.
Открытый исходный код →Связанные руководства