
Z.ai
GLM 5.3
Строитель класса B с полным набором визуальных бенчмарков, который по-прежнему выигрывает от тщательного обзора.
Цены на API
USD за миллион токенов · Z.ai API- Ввод
- $1.4
- Вывод
- $4.4
- Кэшированный ввод
- $0.26
- Контекстное окно
- 1М
Попробовать активные визуальные тесты
Откройте сгенерированную сцену для тестирования или сравните этот промпт с другой моделью.
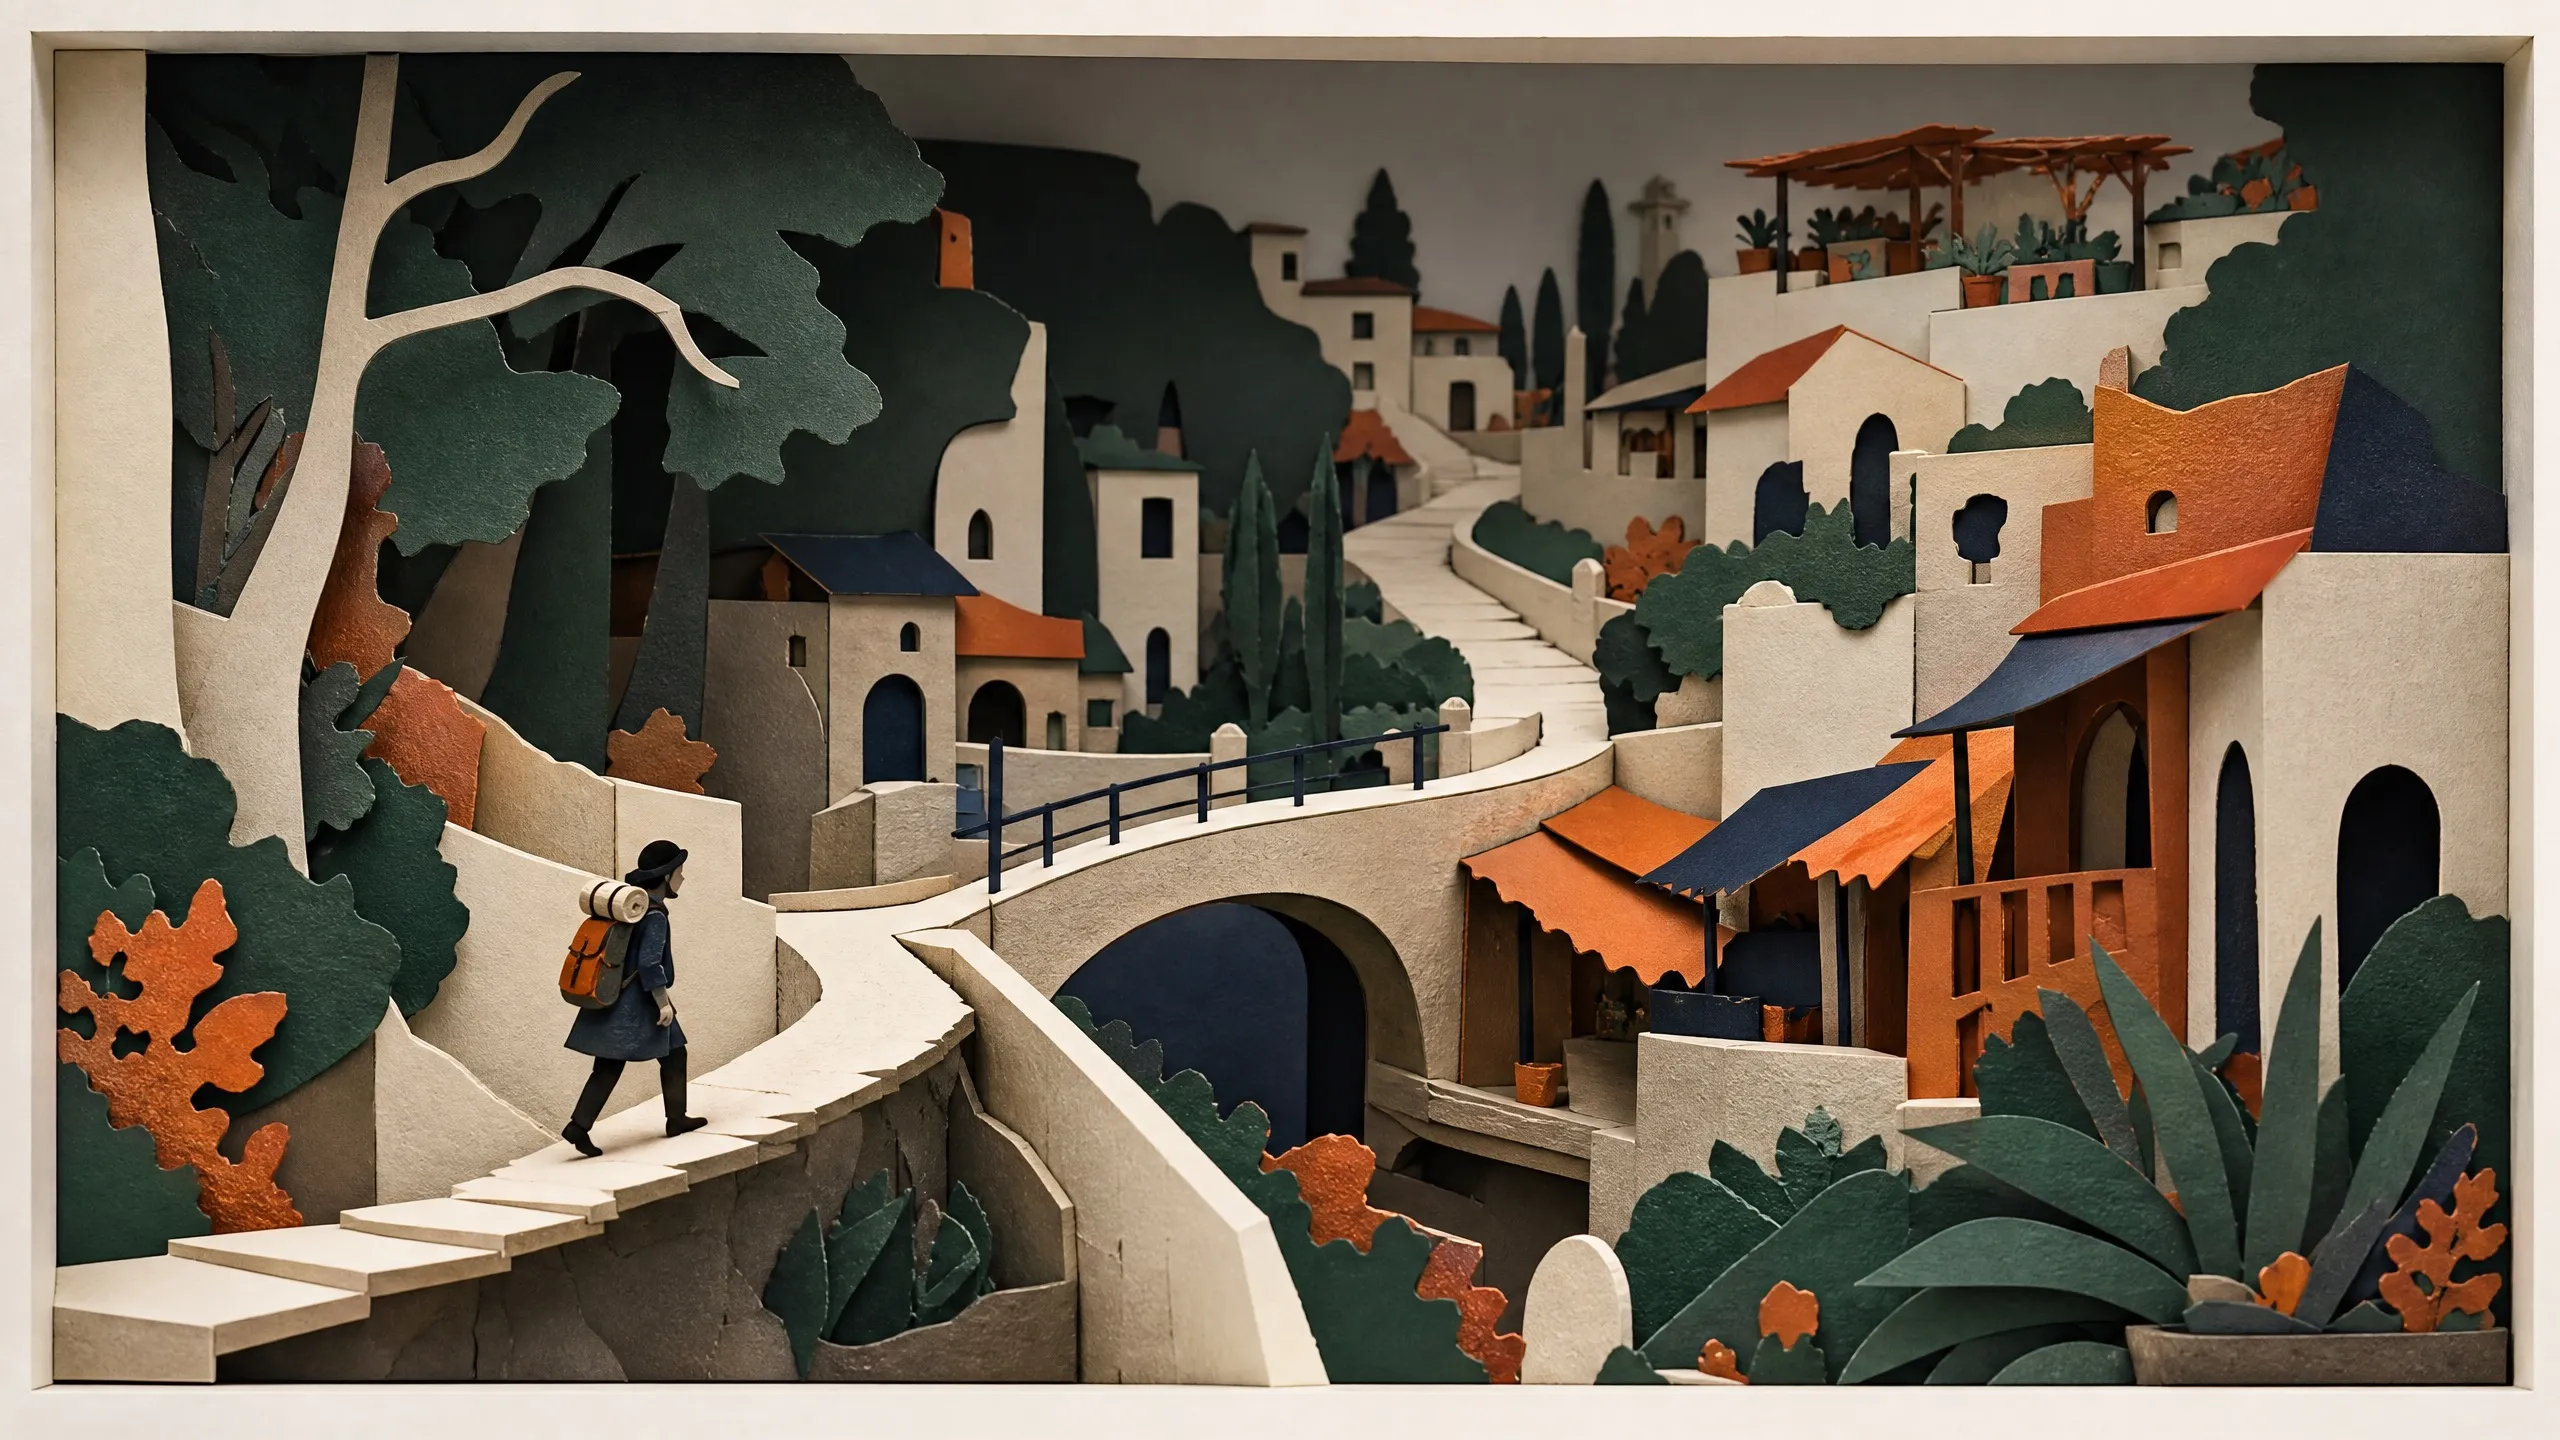
Городское путешествие по прокрутке
Дата запуска: 2026-08-17
Специализированный тест · оценка отдельно
Кинематографическое путешествие по прокрутке, тестирующее непрерывность сцен, сгенерированных ИИ, движение камеры при прокрутке и художественно оформленные посадочные аппараты.
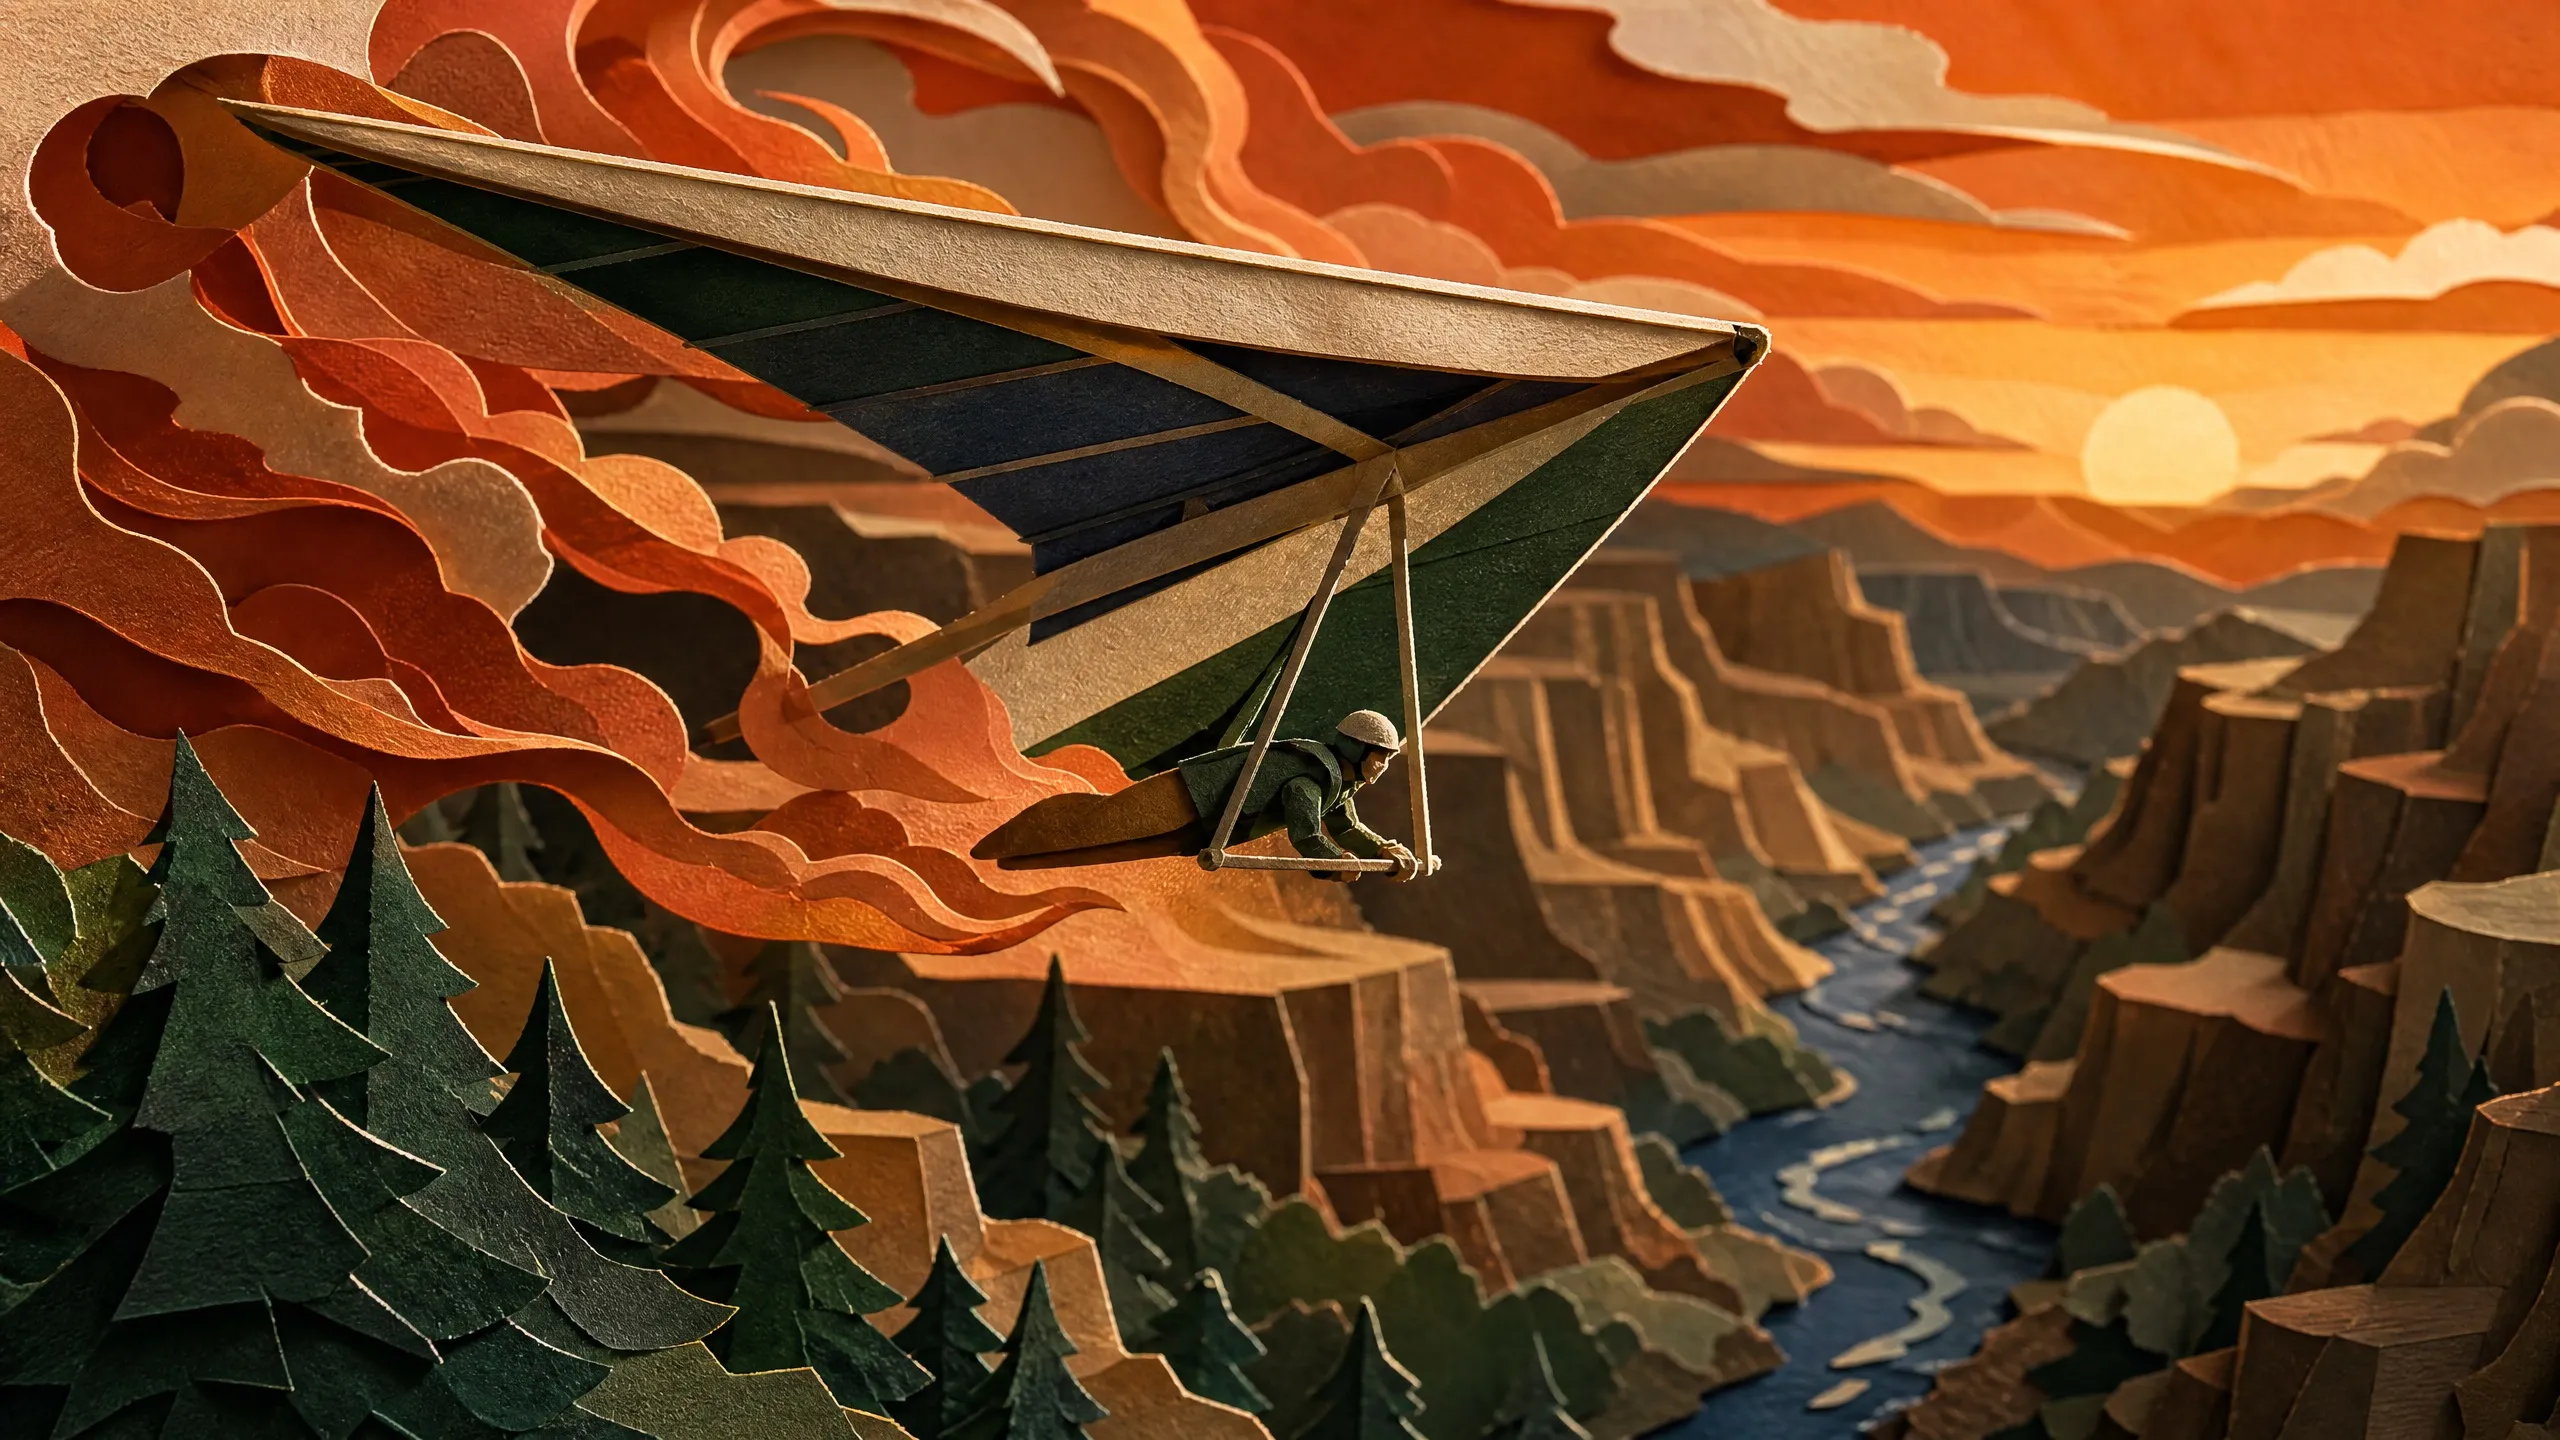
Ember Glider
Дата запуска: 2026-08-17
Закатное скользящее путешествие: тестирование управления энергией полета, потока контрольных точек и художественного оформления атмосферы.
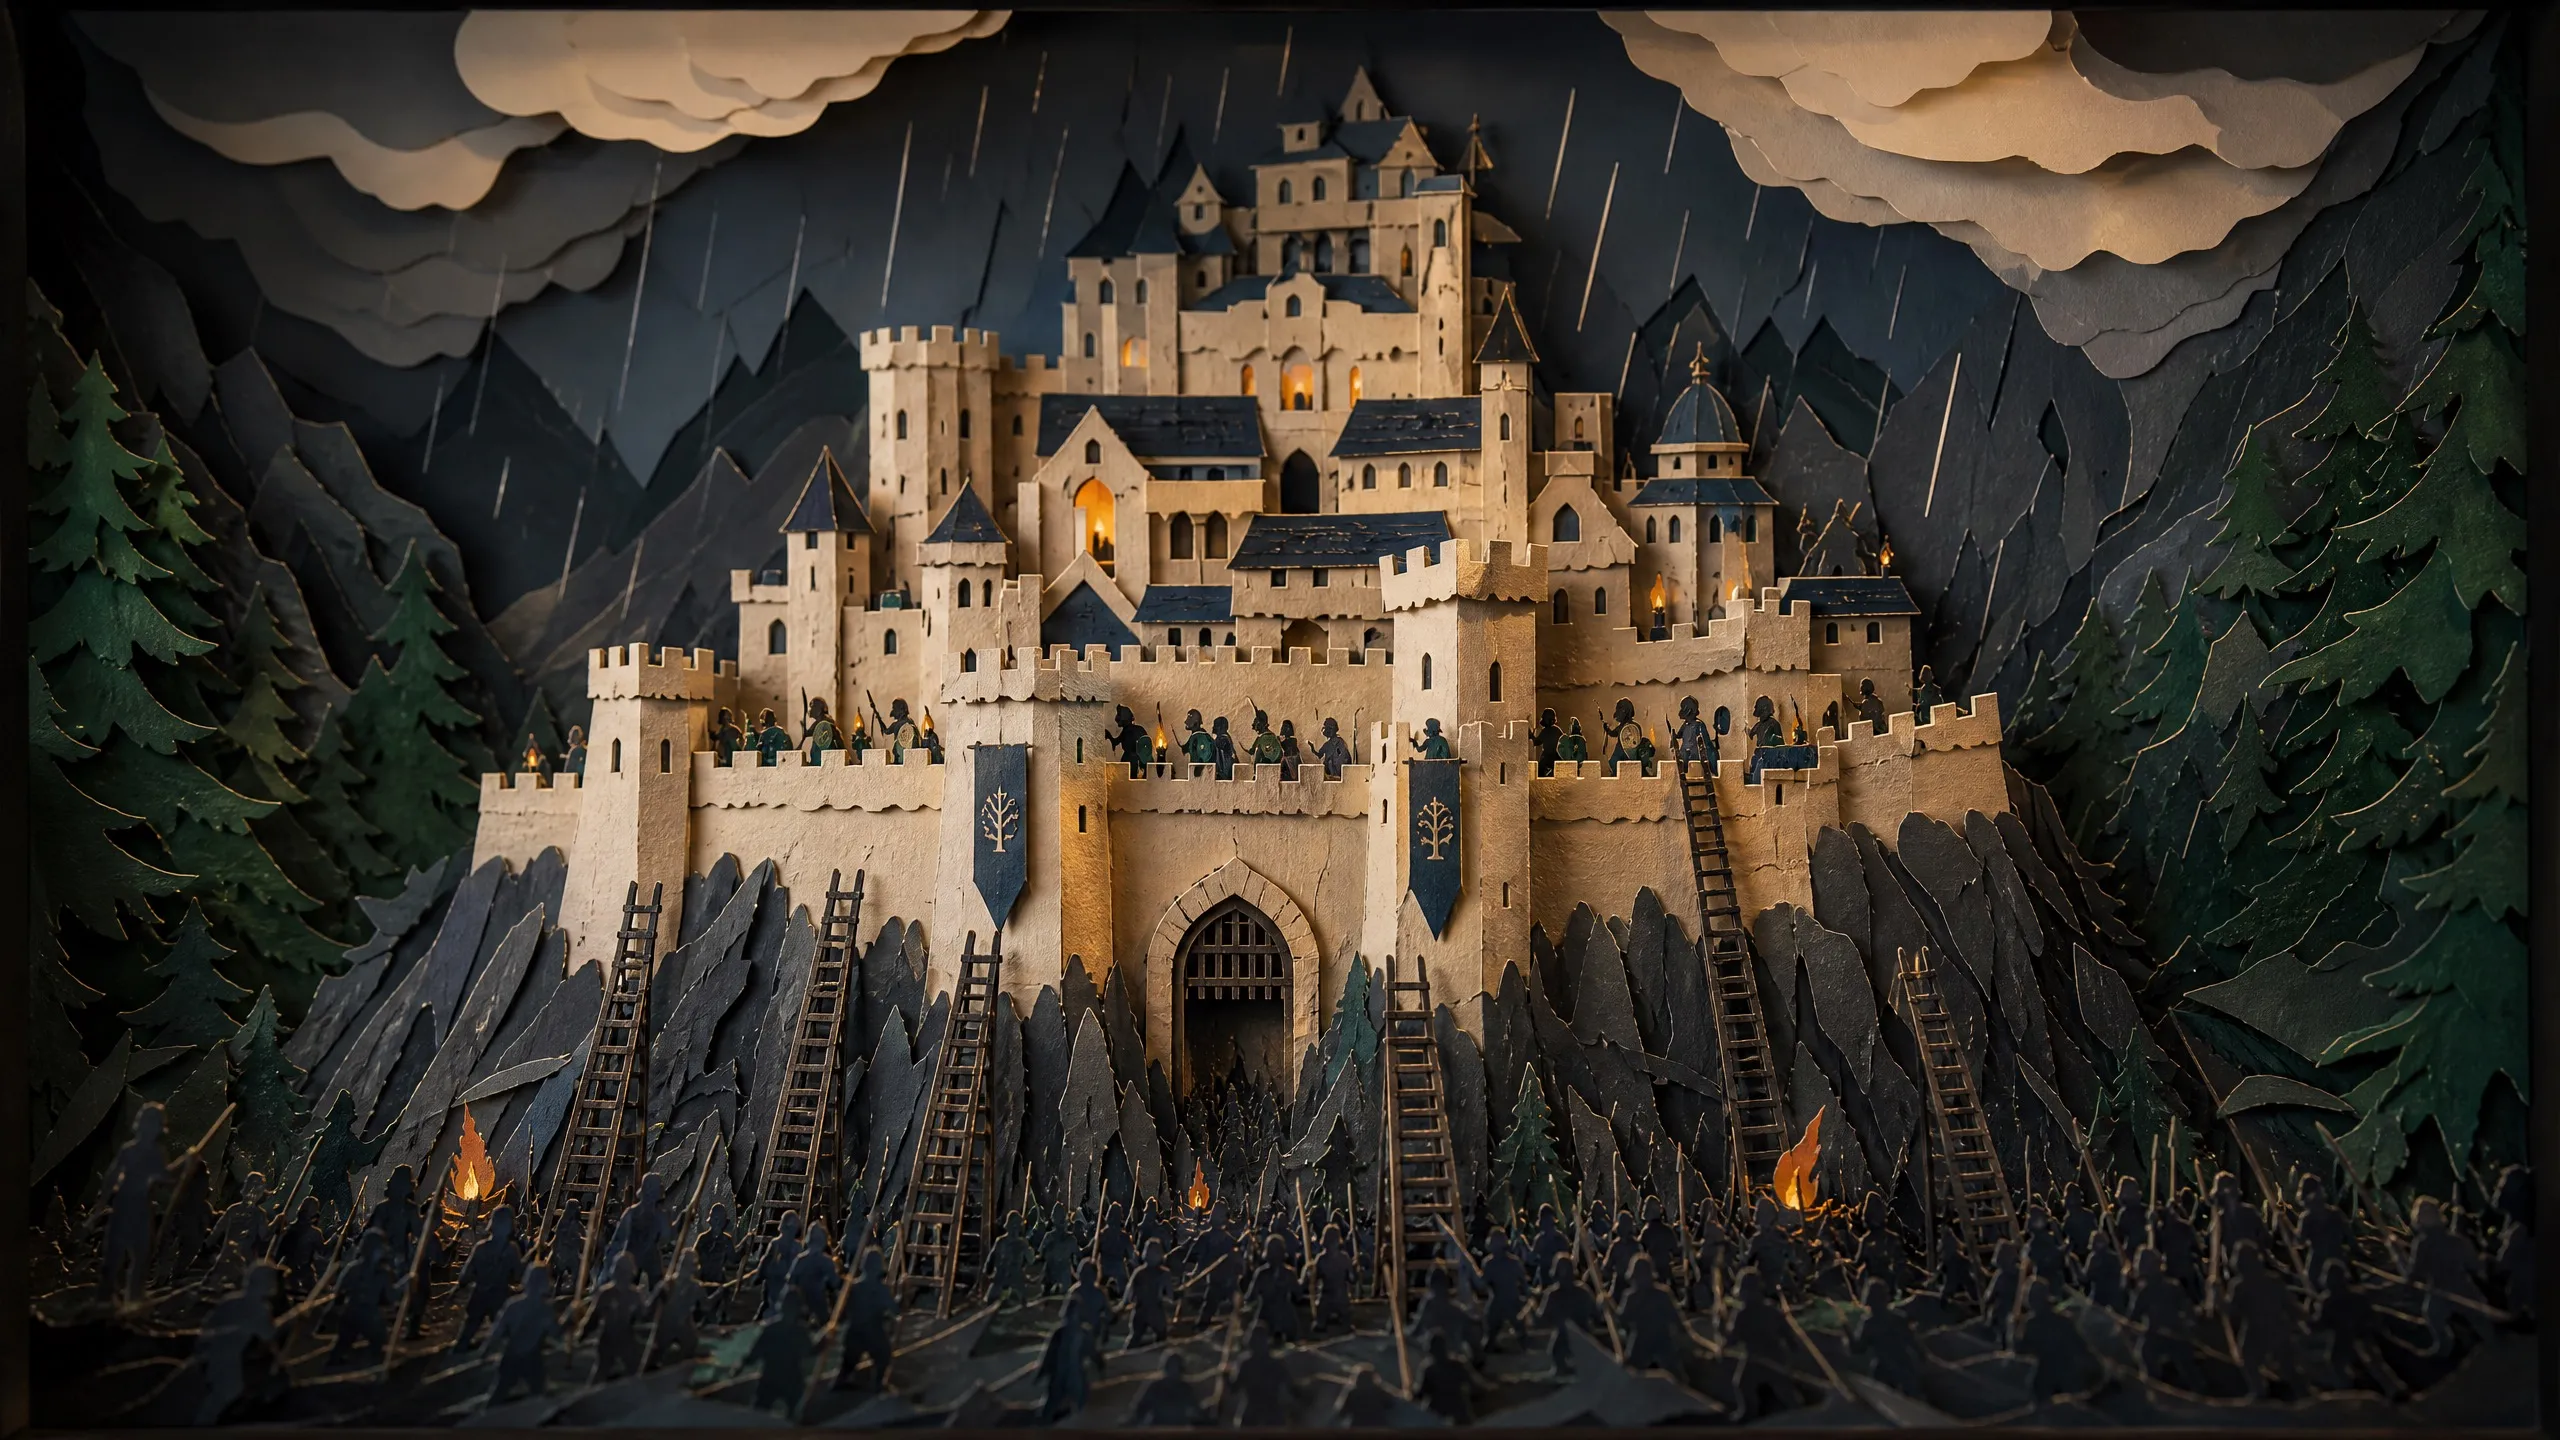
Роханская крепость
Дата запуска: 2026-08-17
Тестирование сцены осады крепости: масштаб, освещение, архитектура и кинематографическая атмосфера.
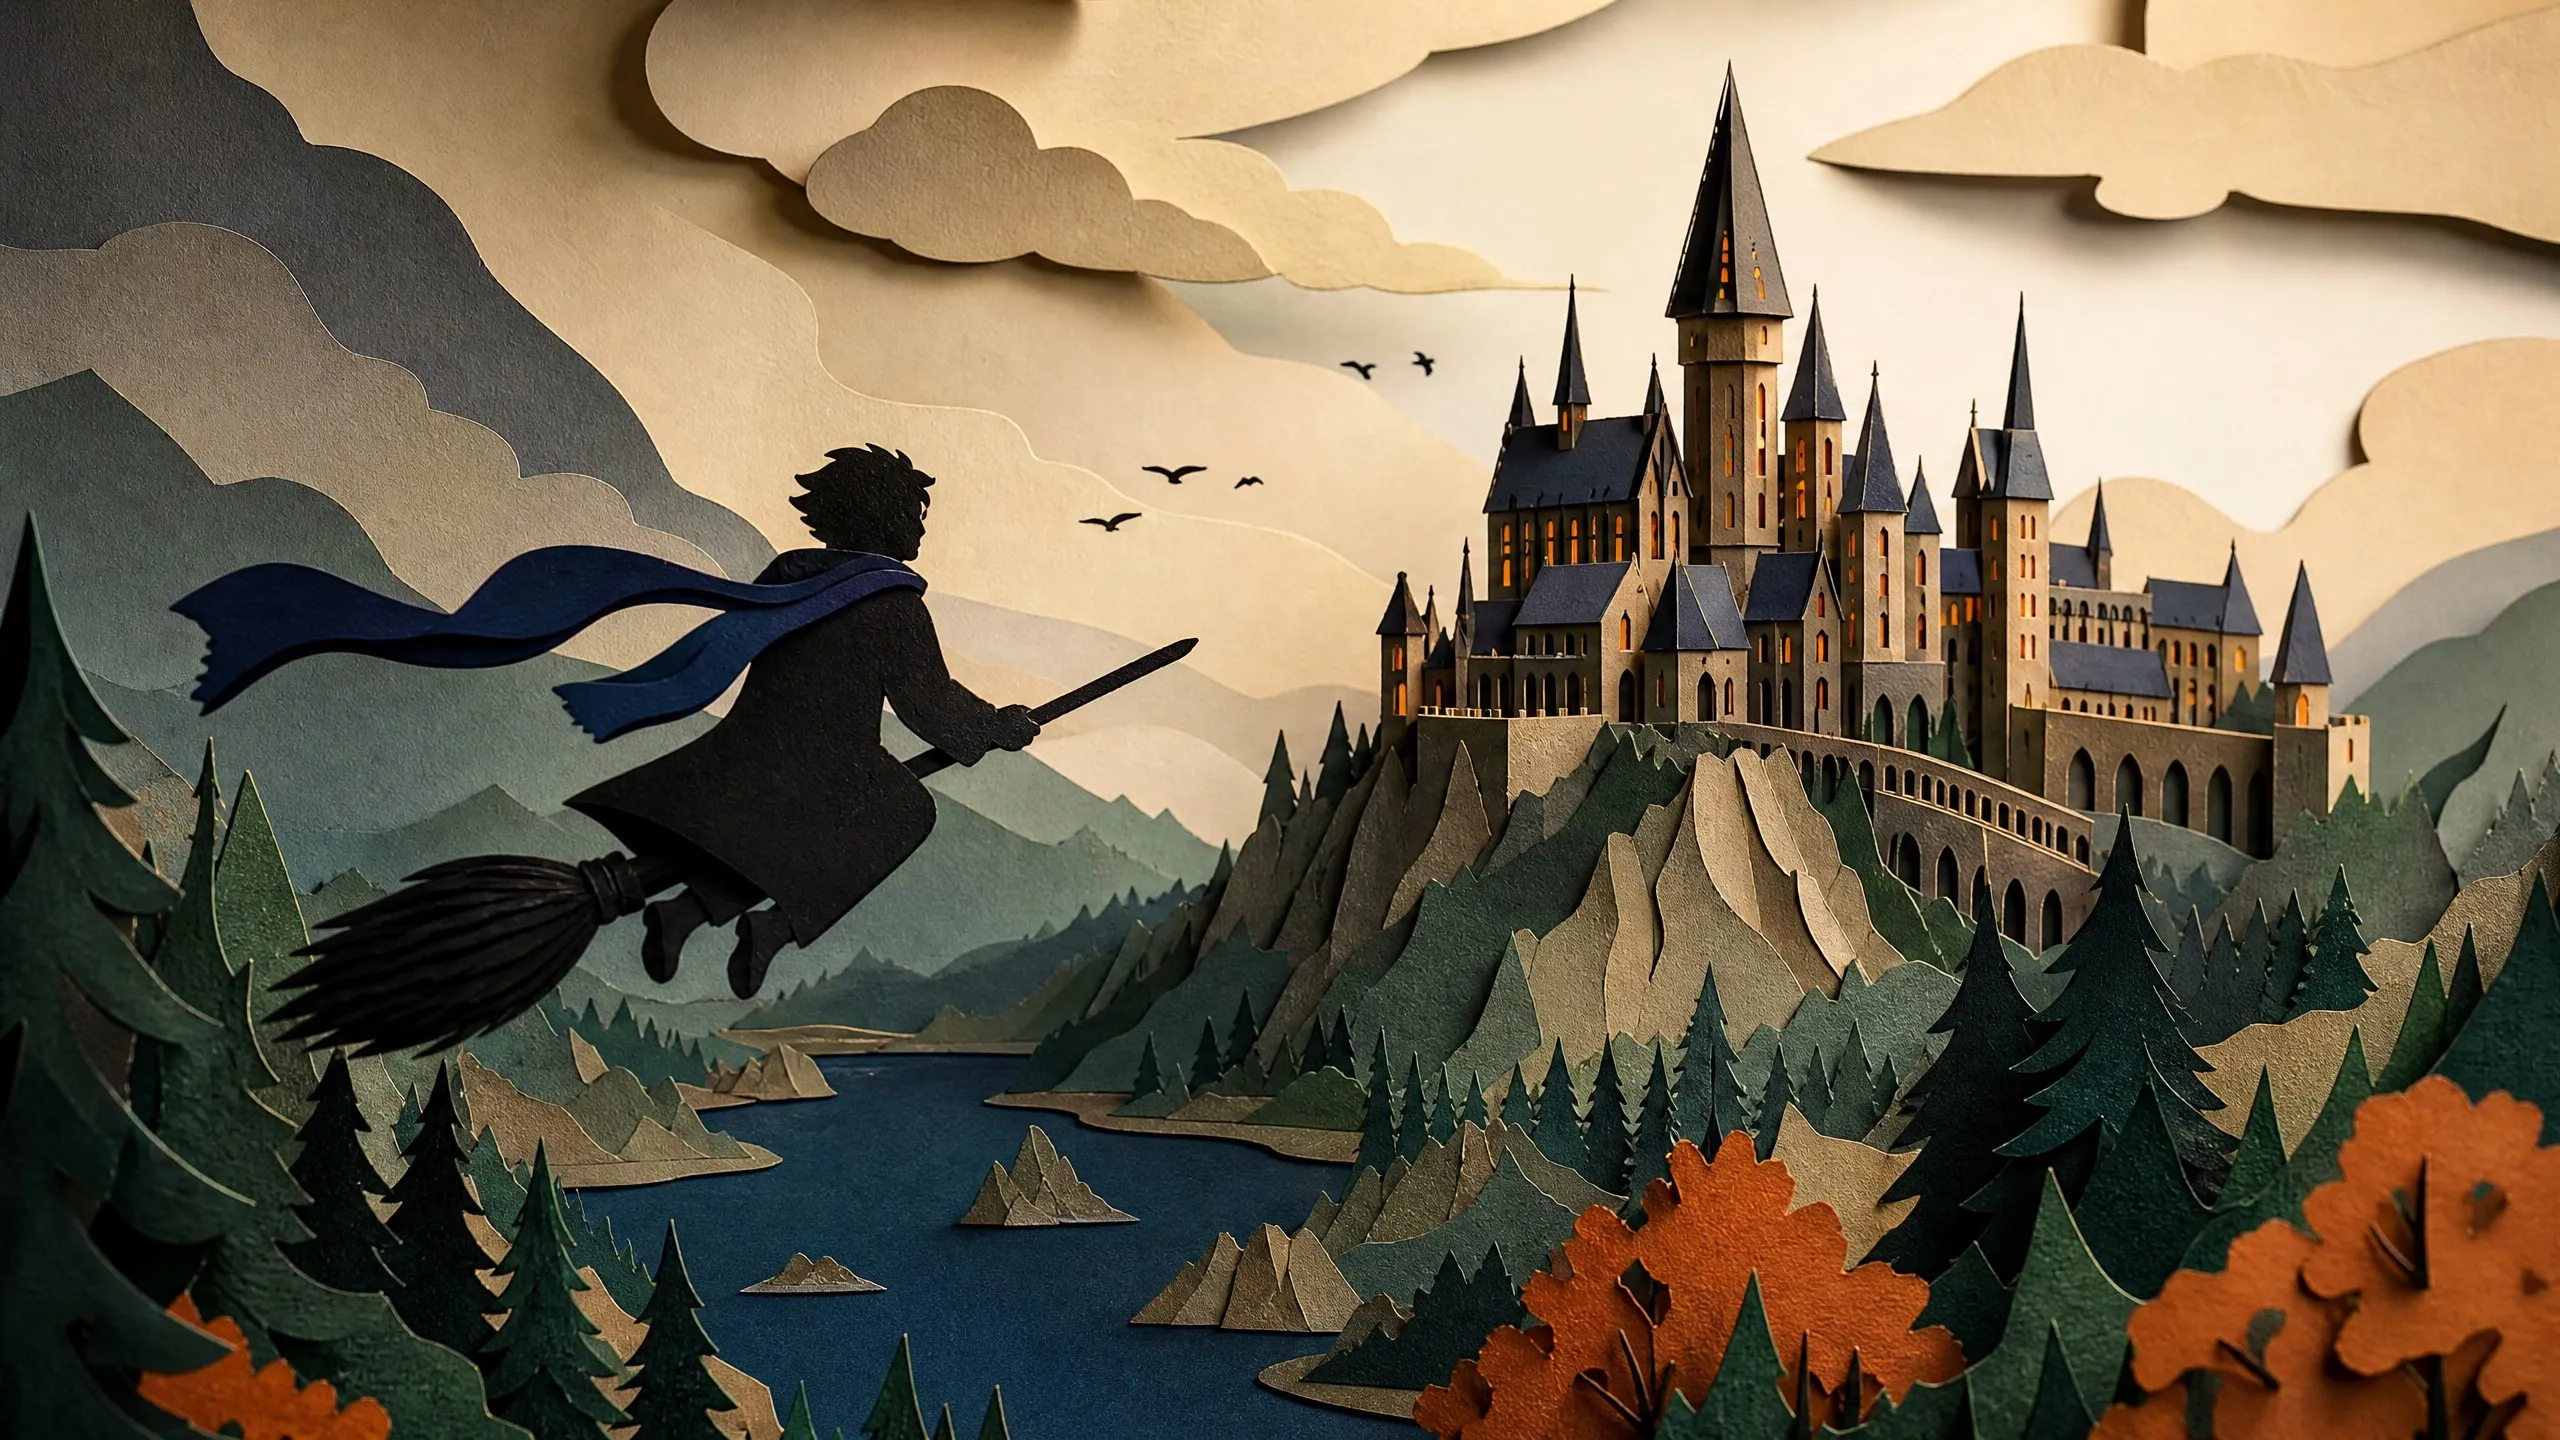
Симулятор полета на метле в Хогвартсе
Дата запуска: 2026-08-17
Тестирование сцены полета на метле: глубина, визуальные подсказки движения, масштаб замка и фантастическое настроение.
Low-Poly Tower Defense
Дата запуска: 2026-08-17
Оборона башни диорамы: тестирование баланса экономики, дизайна волн, правил расстановки и читаемости боя.
Симулятор механических часов
Дата запуска: 2026-08-17
Интерактивное тестирование часов: механическая читаемость, точное относительное движение и управление в 3D в реальном времени.
Neon Drift
Дата запуска: 2026-08-17
Гоночные соревнования синтвейва на время: тестирование физики заносов, времени кругов, повтора привидений и прогрессии разблокировок.
Арена Звездопада
Дата запуска: 2026-08-17
Выживание в неоновой арене: тестирование нарастания волн, сборки улучшений, обратной связи частиц и дизайна боссов.
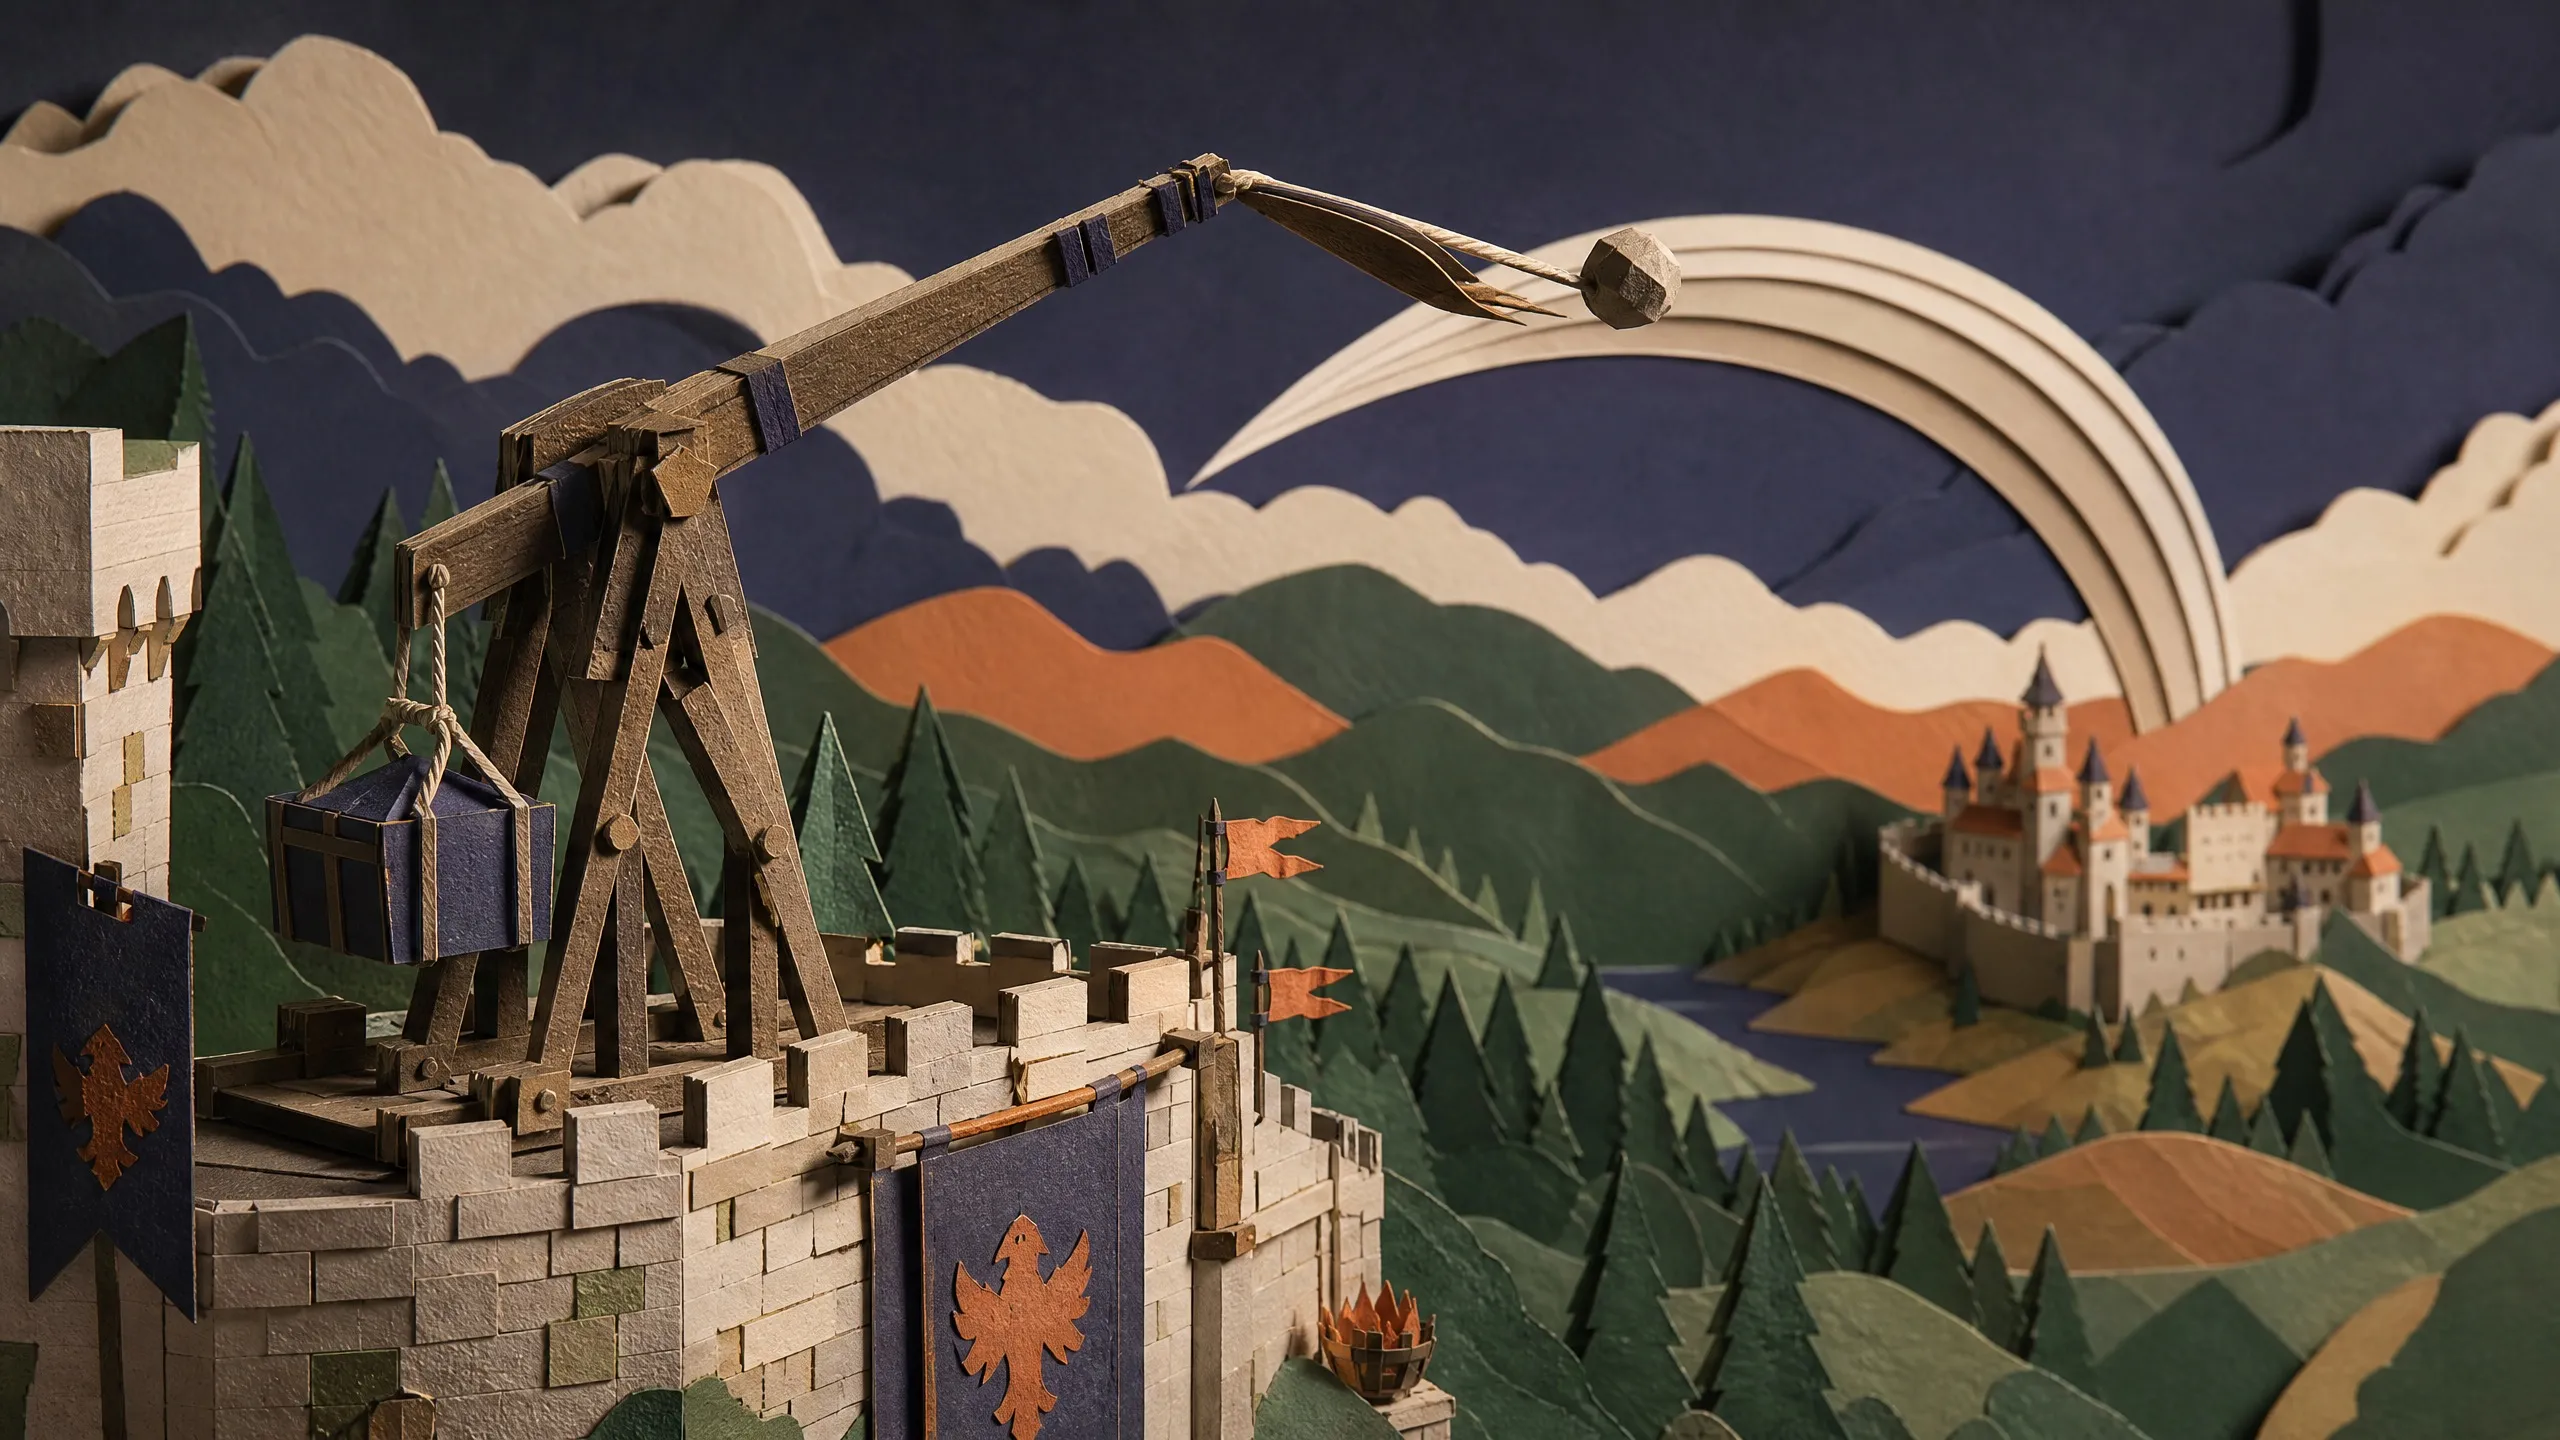
Симулятор Требушета Штормграда
Дата запуска: 2026-08-17
Тестирование осадного моделирования Counterweight с проверкой связанных механизмов, предсказанием траектории, камерами для снарядов и интерактивной настройкой.
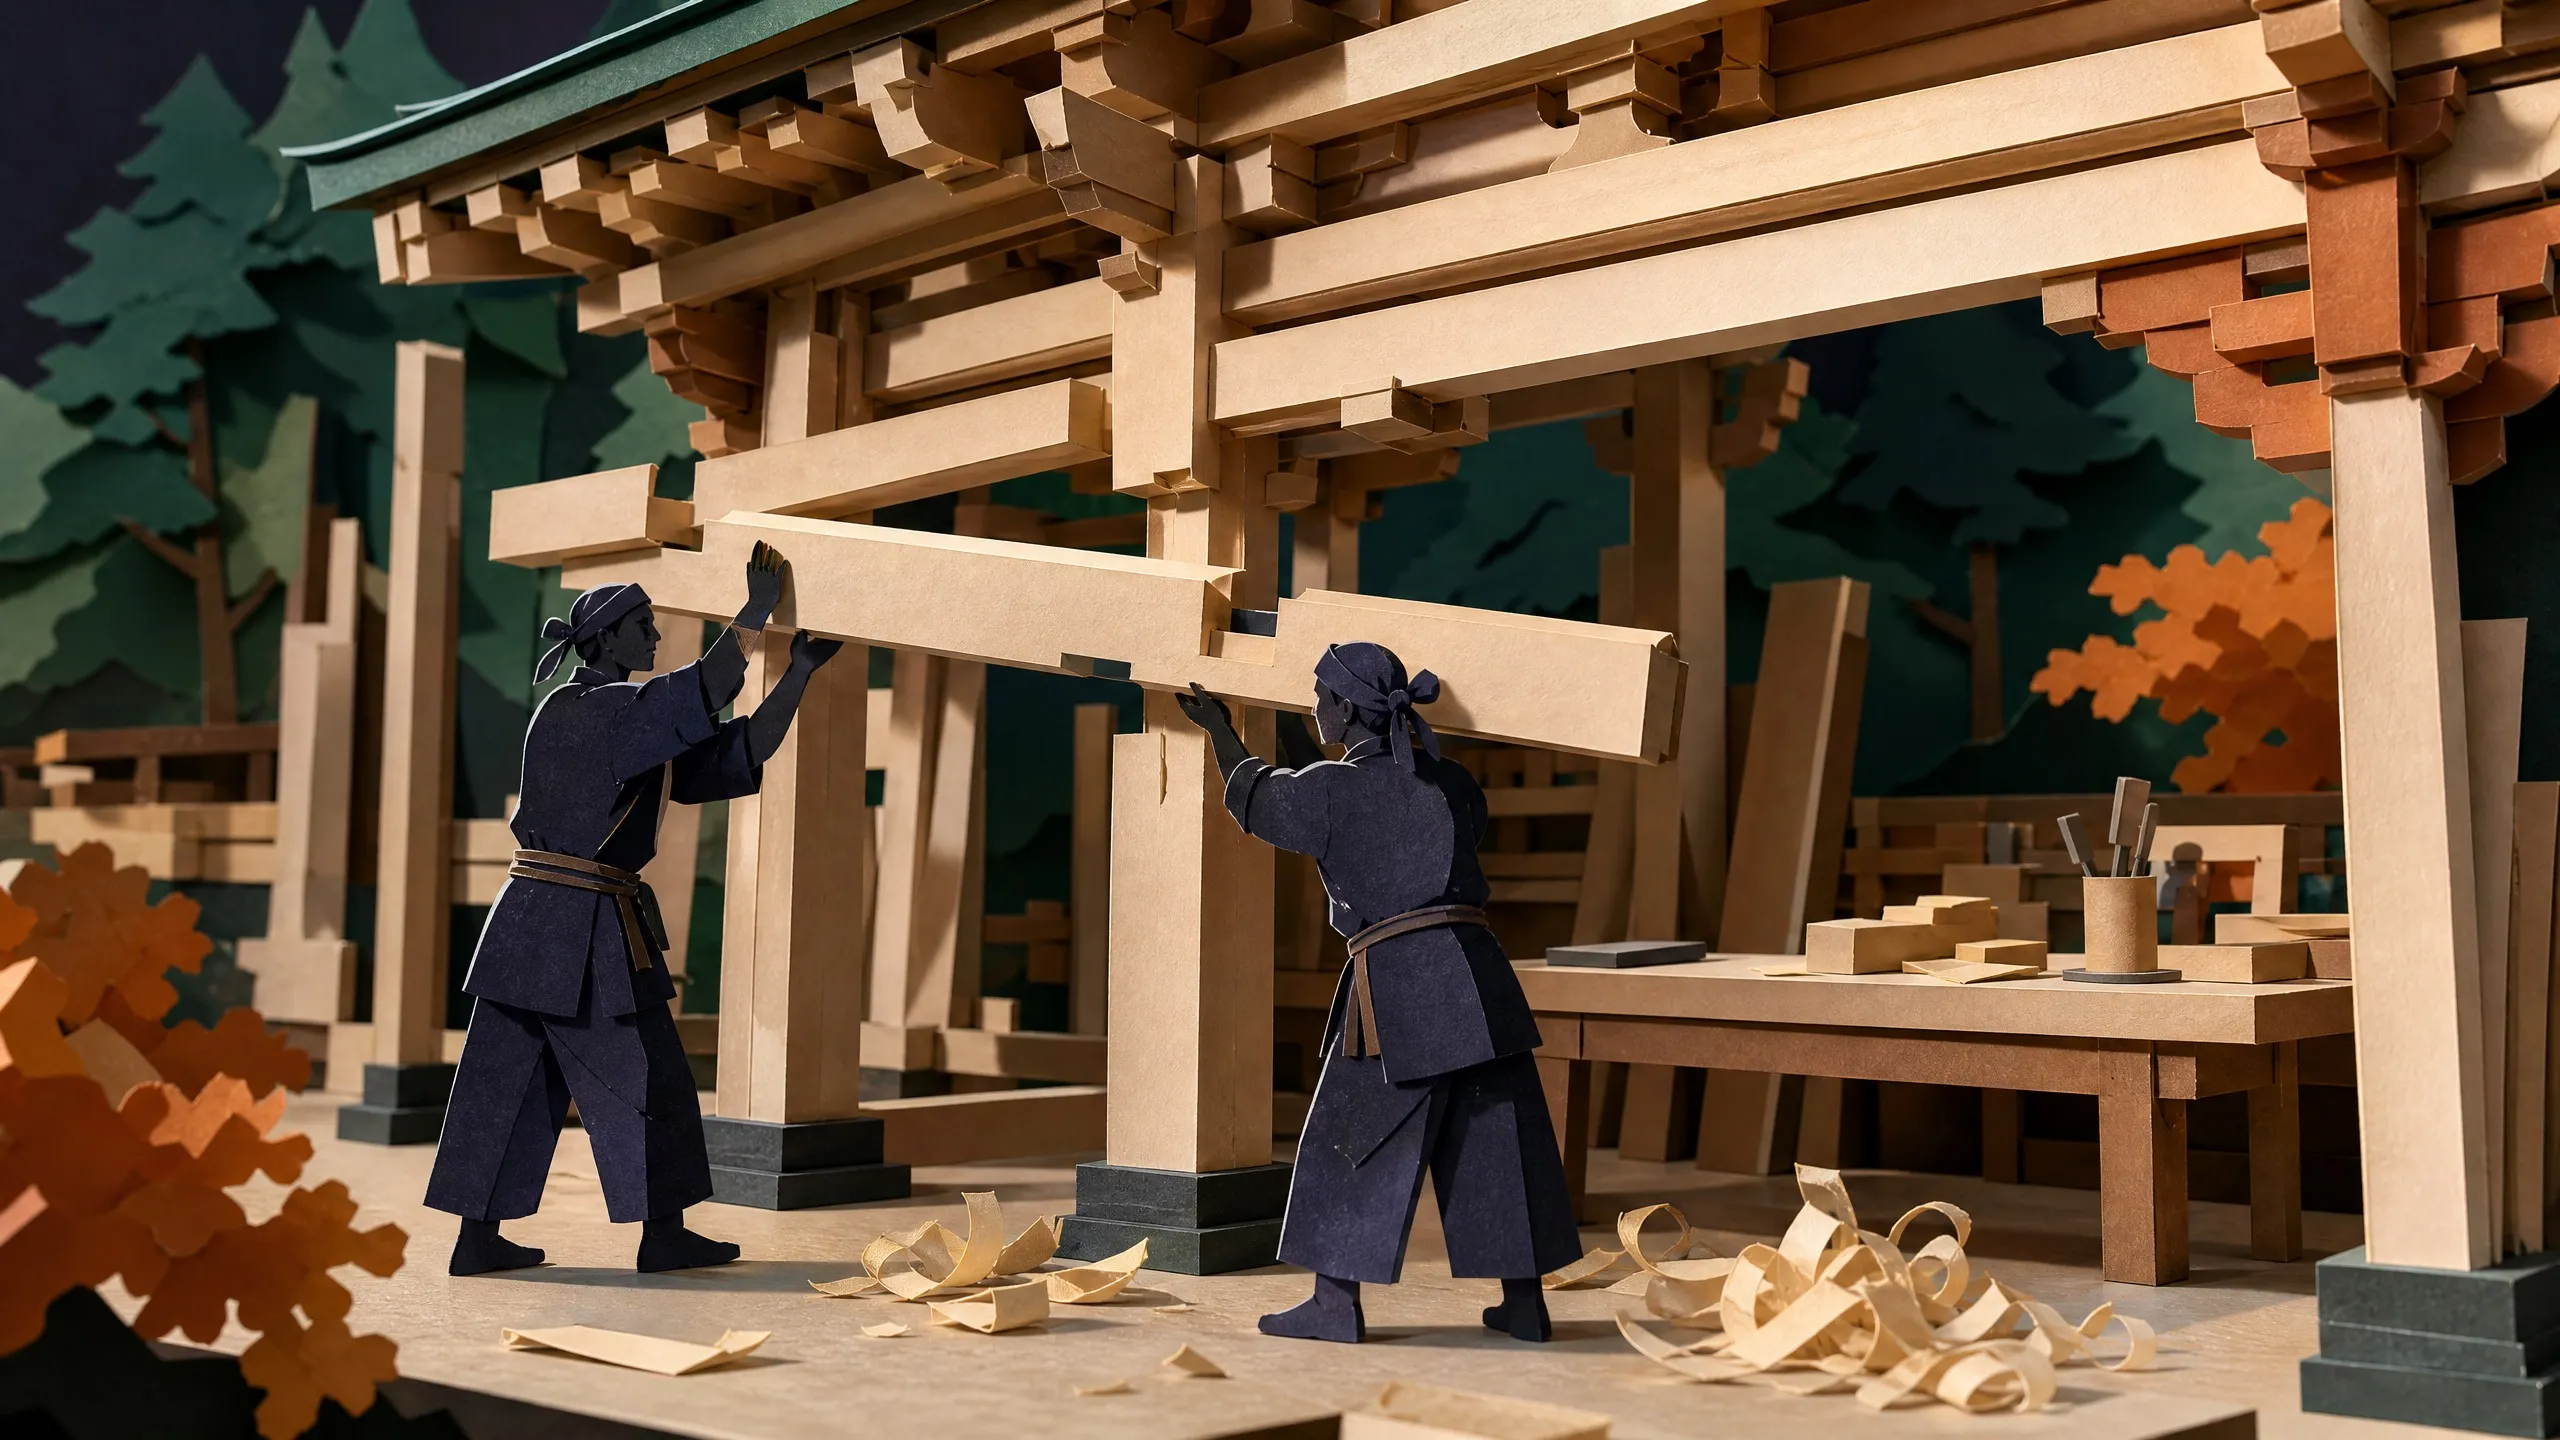
Сборка по «Yingzao Fashi»
Дата запуска: 2026-08-17
Специализированный тест · оценка отдельно
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Снятые с эксплуатации тесты · 6 заархивированных запусков
Эти тесты больше не входят в активный набор. Их исходные результаты остаются доступными для просмотра.
Сравнение GLM 5.3
2 конкурента с опубликованными сравнительными оценками.
- GLM 5.3 Эта модель
- Claude Mythos 5
- GPT-5.6 Sol
1 эталон · 3 модели
Официальный профиль бенчмарка
Результаты GLM-5.3 в кодировании, агентских задачах и кибербезопасности.
Terminal-Bench 3.0
28.3%DeepSWE v1.1
66.9%Последний экзамен агентов (CLI)
28.5%Полная официальная таблица бенчмарков6 оценок и сравнение с коллегами
| Бенчмарк | Площадь | Балл | Сравнение |
|---|---|---|---|
| Terminal-Bench 3.0 | Агентное кодирование | 28.3% | |
| DeepSWE v1.1 | Программирование | 66.9% | |
| Последний экзамен агентов (CLI) | Терминальные агенты | 28.5% | |
| GDPval-AA v2 | Профессиональная работа | 1769 Эло | |
| CyberGym | Кибербезопасность | 84.5% | |
| ExploitBench | Кибербезопасность | 54.4% |
Источники, детали ценообразования и методология
Проверенные данные о модели
Характеристики модели
- Статус
- Предварительный просмотр / ограниченный доступ
- ID модели API
- Не подтверждено публично
- Контекст
- 1М
- Максимум выходных токенов
- 128K
- Лицензия
- Не подтверждено публично
- Способ доступа
- Не подтверждено публично
- Модальности
- Не подтверждено публично
- Аппаратное обеспечение
- Не подтверждено публично
- Z.ai API · USD / 1 млн токенов
- $1.4 ввод · $0.26 кэшированный ввод · $4.4 вывод
Хранение кэшированного ввода в настоящее время бесплатно на ограниченное время.
Источники бенчмарков
Z.ai сообщает о больших успехах по сравнению с GLM-5.2 в оценках по программированию, терминальным агентам и кибербезопасности. Это результаты, представленные поставщиком при запуске; общедоступный API GLM-5.3 пока отмечен как скоро появится.
Представляем GLM-5.3GLM-5.3 доступен пользователям плана GLM Coding. Z.ai сообщает, что прямой доступ к API появится скоро.
Настройки оценки
- Результат запуска Z.ai; GLM-5.2 набрал 4,6% в том же сравнении.
- Результат запуска Z.ai; GLM-5.2 набрал 46,2% в том же сравнении.
- Результат запуска Z.ai; GLM-5.2 набрал 23,8% в том же сравнении.
- Результат Z.ai по анализу искусственного интеллекта в профессиональной работе.
- Результат запуска Z.ai.
- Результат запуска Z.ai; GLM-5.2 набрал 24,4% в том же сравнении.
Редакционный вердикт
Где подходит эта модель
GLM 5.3 завершил все 16 визуальных бенчмарков Mantis за одну локальную сессию; каждый артефакт проходит проверку и запускается. Первая попытка застопорилась, когда аккаунт достиг лимита использования, но повторный запуск с меньшей конкуренцией завершил весь набор. Класс B отражает полезное покрытие сборки вместе с учётом затрат и доступа команды; только проверка не является оценкой качества.
Лучшее для
Внимание
Почему она занимает это место
Доказательство
Рейтинг редакционной модели Mantis
Основной вывод: GLM 5.3 в настоящее время находится в категории B.
Редакционный список на сентябрь 2026 года ставит GLM 5.3 на 12-е место.
Открыть источник →Представляем GLM 5.3
Основной вывод: Используйте GLM 5.3 для кодирования с учётом экономии после проверки результата.
Модель в настоящее время доступна через план кодирования Z.ai; проверьте общую доступность API перед построением прямой интеграции.
Открыть источник →Связанные руководства