OpenAI
GPT-5.6 Sol
Надежный строитель команды: достаточно умный, практичный и готовый довести дело до конца.
Проверенные данные о модели
Основные сведения, ограничения и цены
- Статус
- Текущий
- ID модели API
gpt-5.6-sol- Контекст
- 1.05М
- Максимум выходных токенов
- 128K
- Лицензия
- Не подтверждено публично
- Способ доступа
- Не подтверждено публично
- Модальности
- Не подтверждено публично
- Аппаратное обеспечение
- Не подтверждено публично
- Рекламное ценообразование GitHub Copilot (стандартный тариф, ≤272 тыс. входных токенов) / 1 млн токенов
- $2 вход · $0.2 кэшированный вход · $2.5 запись в кэш · $10 вывод
GitHub Copilot: 50% скидка на стандартные тарифы до 3 сентября 2026 года. Длительный контекст (>272 тыс. входных токенов): $4 вход, $0.40 кэшированный вход, $5 запись в кэш и $15 вывод за 1 млн токенов. Тарифы GitHub Copilot после акции в этой таблице не публикуются; не делайте выводов. Это не цена OpenAI API.
Визуальные тесты на одном промпте
Посмотреть реальные прогоны
Откройте сгенерированную сцену для тестирования или сравните этот промпт с другой моделью.
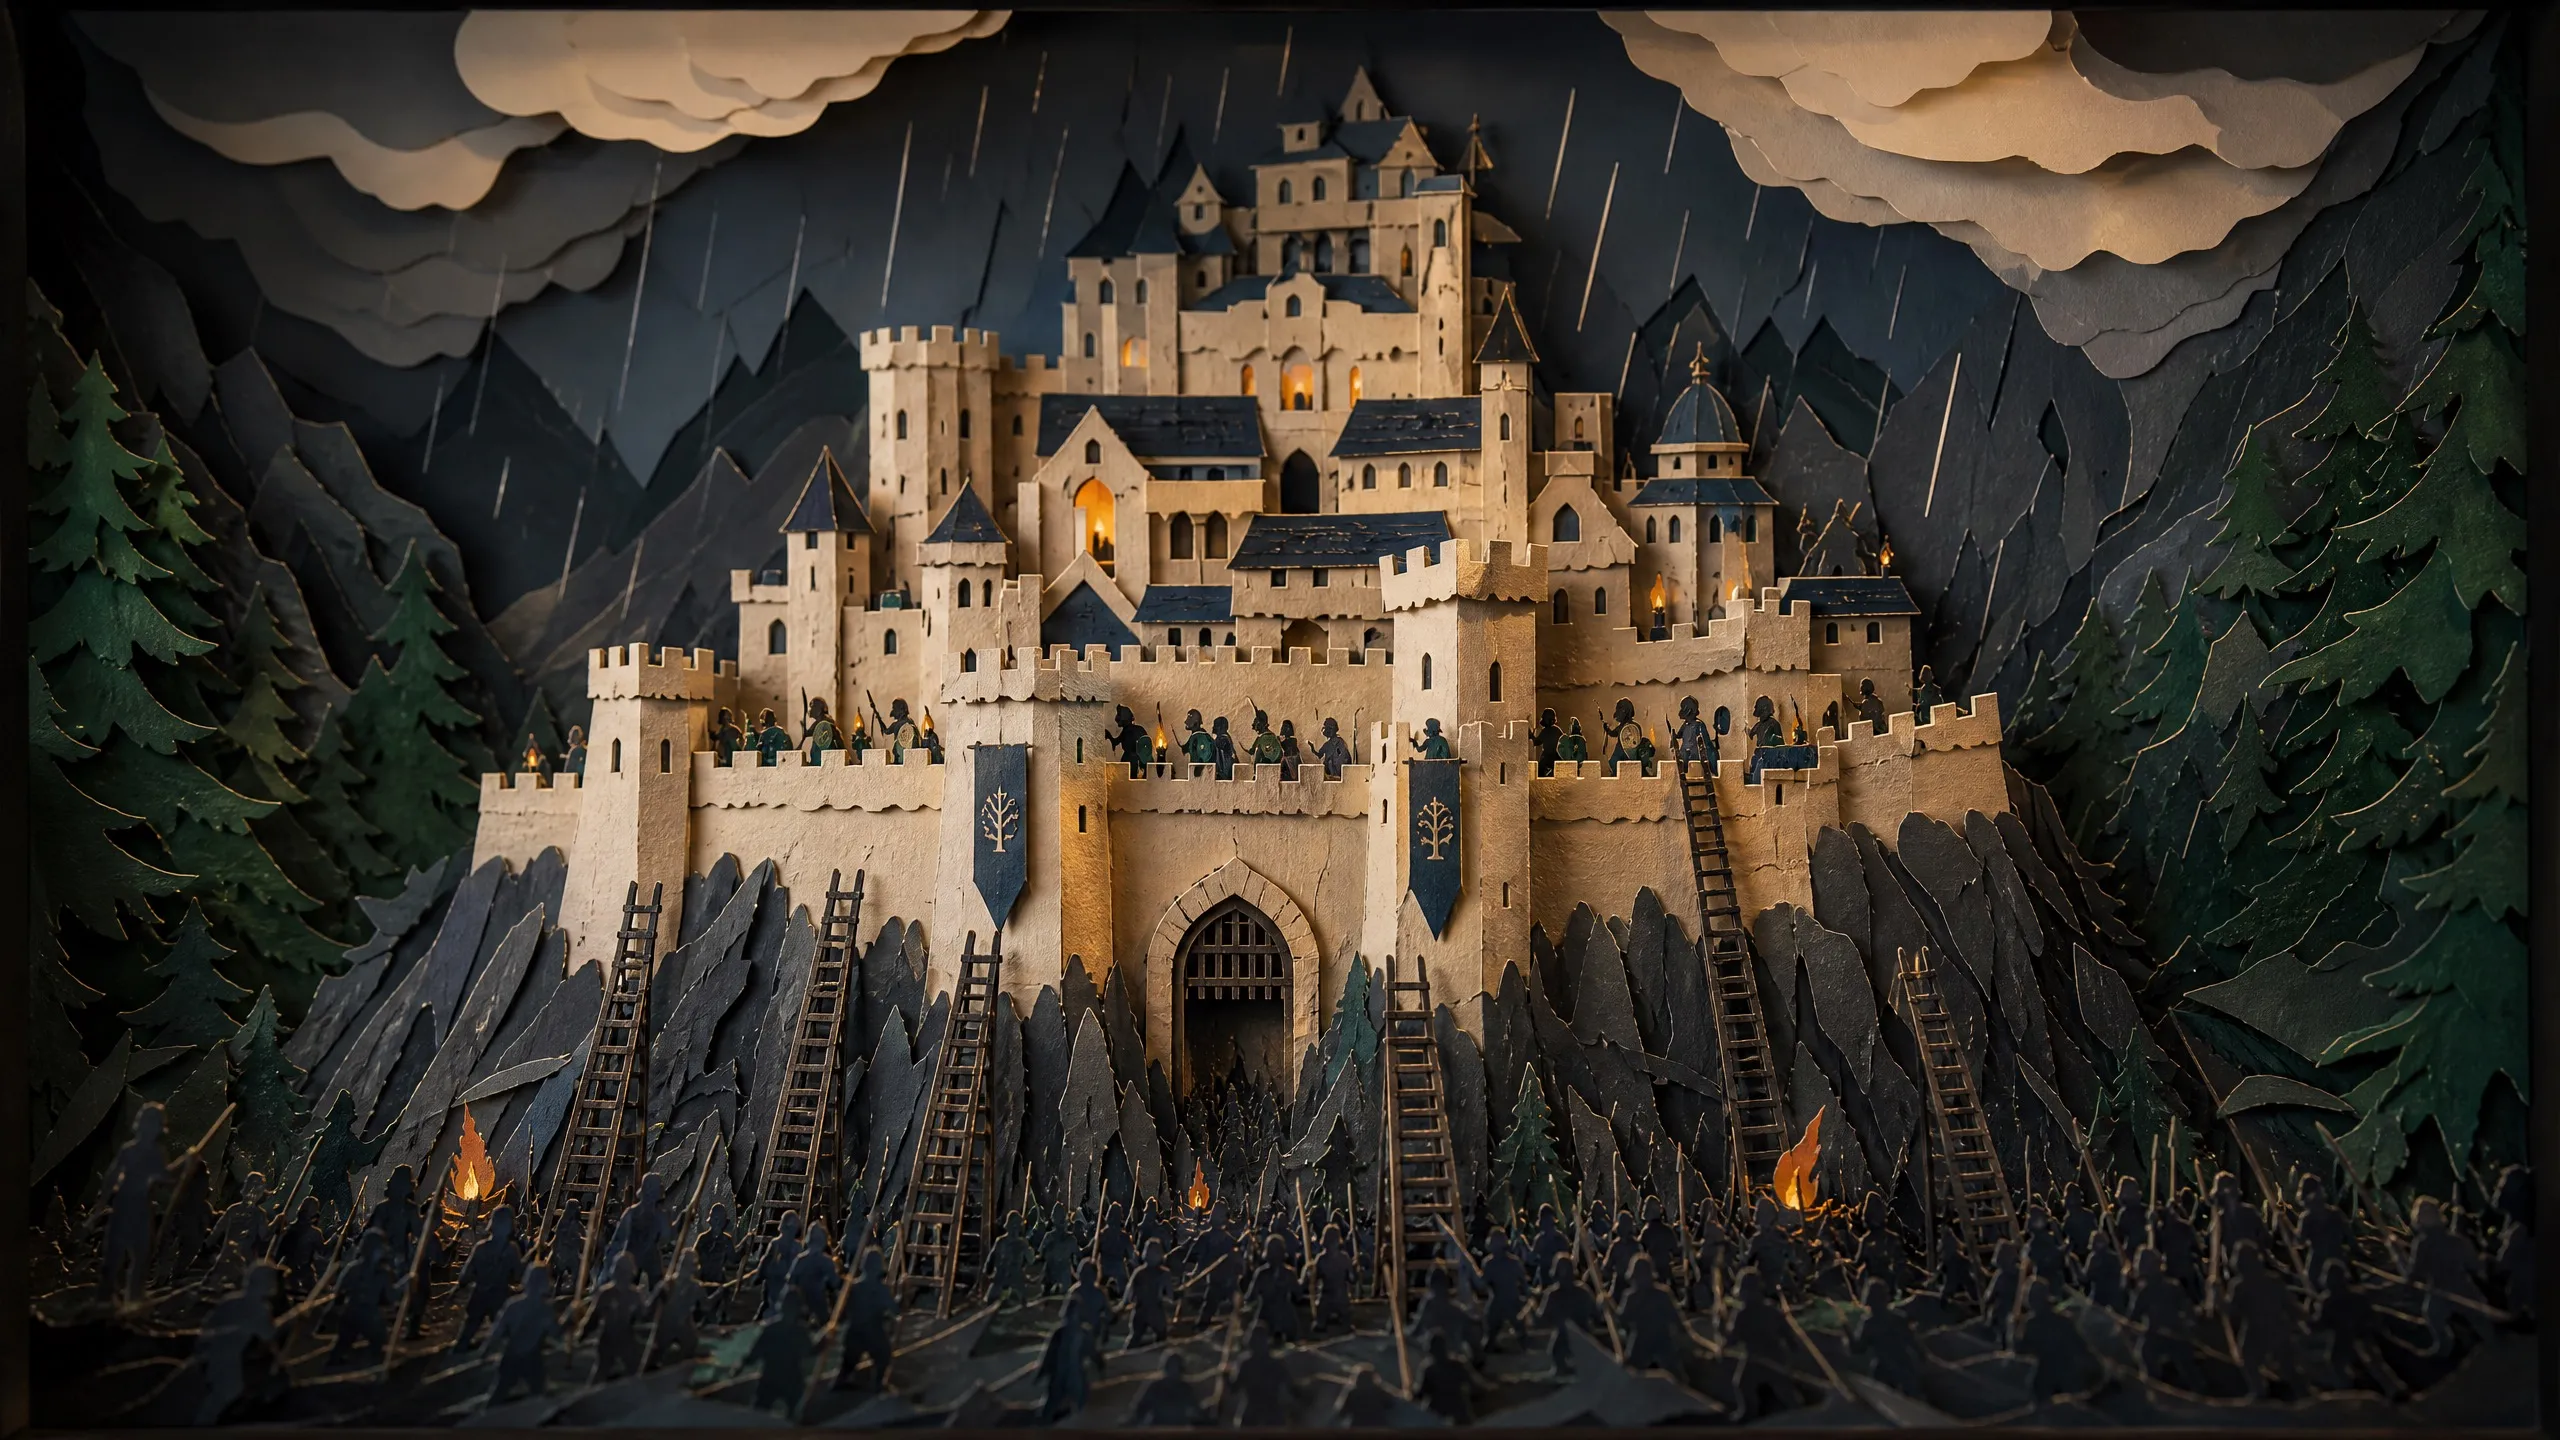
Роханская крепость
Тестирование сцены осады крепости: масштаб, освещение, архитектура и кинематографическая атмосфера.
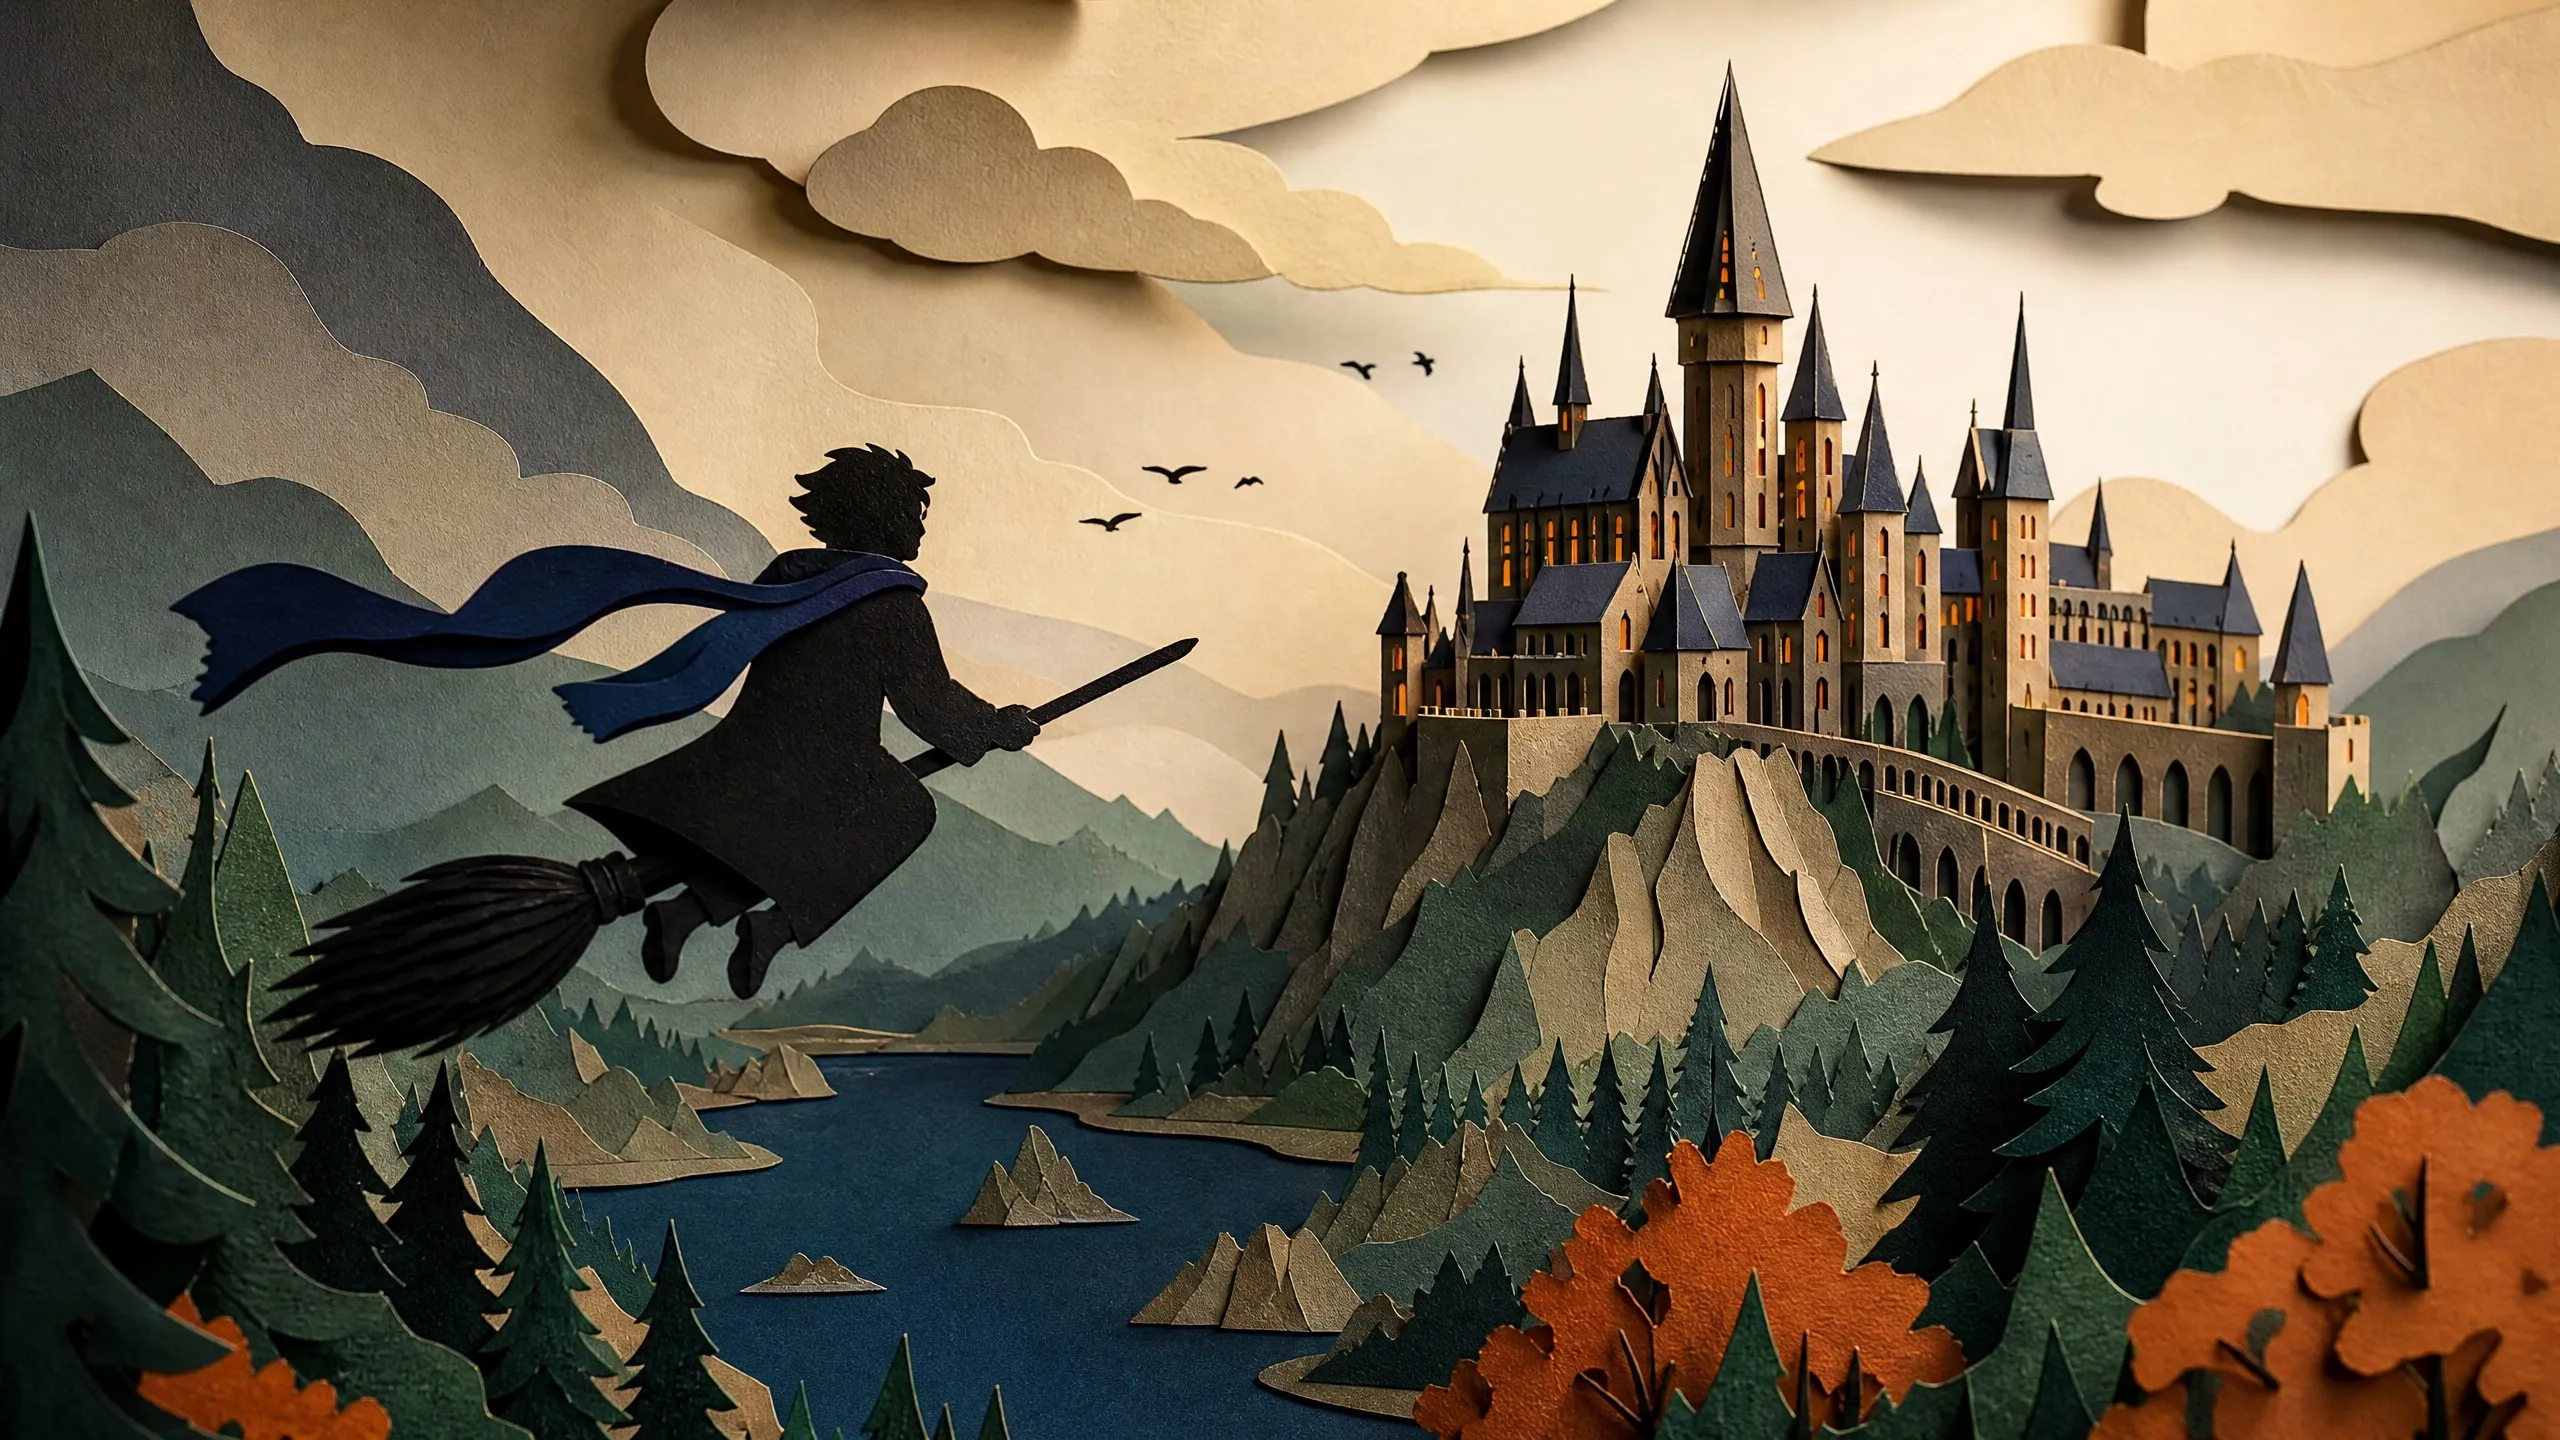
Симулятор полета на метле в Хогвартсе
Тестирование сцены полета на метле: глубина, визуальные подсказки движения, масштаб замка и фантастическое настроение.
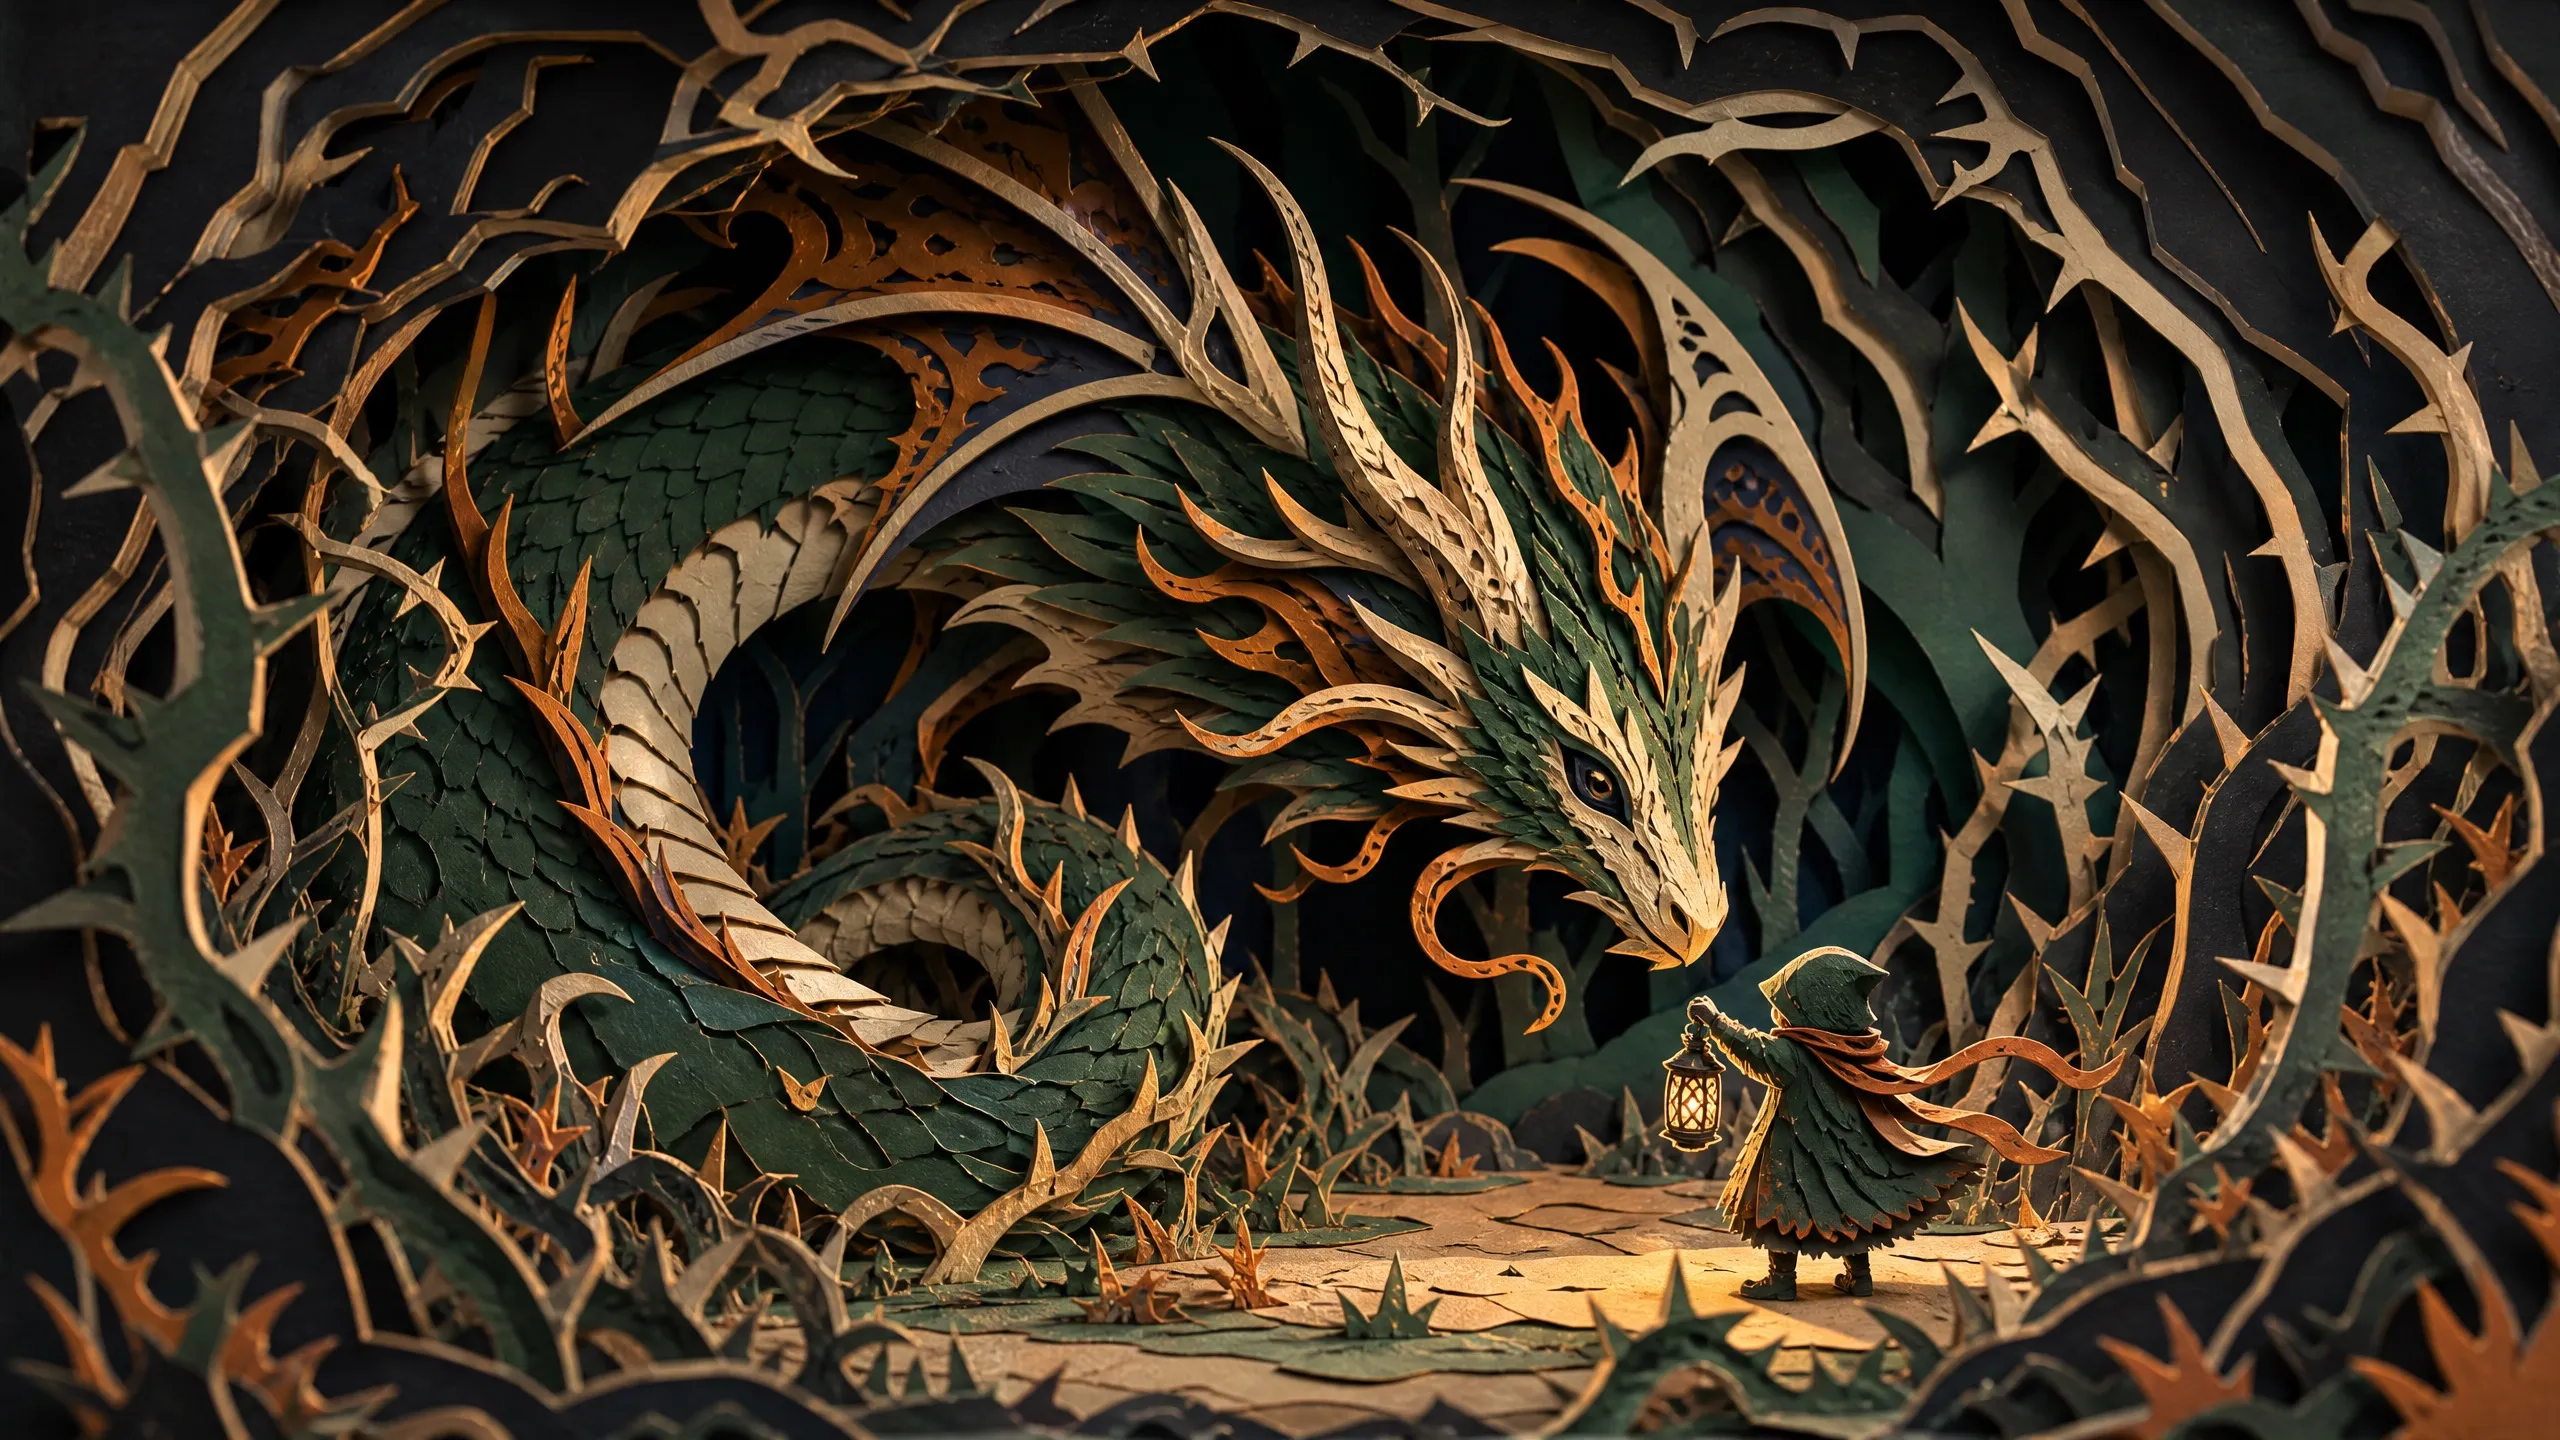
Джаббервок
Тестирование встречи в стиле тёмного фэнтези: дизайн существ, настроение леса и постановка повествования.
Низкополигональный мир
Стилизованная островная сцена для тестирования композиции, цвета и низкополигонального миростроения.
Офисная жизнь
Офисная виньетка для тестирования логики повседневной сцены, объектов и достоверных офисных деталей.
Петри
Микроскопическая экосистема для тестирования органических форм, научной ясности и клеточных деталей.
Симулятор Требушета Штормграда
Тестирование осадного моделирования Counterweight с проверкой связанных механизмов, предсказанием траектории, камерами для снарядов и интерактивной настройкой.
Симулятор вселенной
Космическая система для тестирования орбитальной структуры, светящихся тел, масштаба и читаемости симуляции.
Вайс Сити
Неоновый прибрежный город для тестирования транспортных средств, архитектуры, атмосферы и плотной городской планировки.
Сборка по «Yingzao Fashi»
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Официальный профиль бенчмарка
Опубликованные результаты за пределами наших визуальных тестов
OpenAI представляет Sol как флагманскую модель GPT-5.6. Эти строки используют общую сравнительную таблицу GPT-5.6, чтобы результаты можно было напрямую сравнить с Terra, Luna, GPT-5.5, Claude и Gemini, где они опубликованы.
SWE-bench Pro
64.6%Terminal-Bench 2.1
88.8%OSWorld 2.0
62.6%Полная официальная таблица бенчмарков9 строк с исходными настройками и графиками коллег
| Бенчмарк | Площадь | Балл | Настройка / сравнение |
|---|---|---|---|
| SWE-bench Pro | Программирование | 64.6% | Общая сравнительная таблица OpenAI GPT-5.6. |
| Terminal-Bench 2.1 | Агентное кодирование | 88.8% | Общая сравнительная таблица OpenAI GPT-5.6. |
| OSWorld 2.0 | Использование компьютера | 62.6% | Сравнительная таблица производительности при высокой нагрузке на компьютер. |
| BrowseComp | Использование инструментов | 90.4% | Балл за высокие нагрузки; OpenAI отдельно сообщает о Sol Ultra со значением 92,2%. |
| BenchCAD | Компьютерное проектирование | 70.6% | Результат Vision2Code без инструмента Python. |
| BenchCAD с Python-инструментом | Использование инструментов | 83.4% | Результат Vision2Code с инструментом Python. |
| GPQA Diamond | Академическое рассуждение | 94.6% | Общая таблица бенчмарков для рассуждений. |
| FrontierMath Уровень 1-3 v2 | Математика | 89.0% | Общая таблица бенчмарков для рассуждений. |
| FrontierMath Уровень 4 v2 | Математика | 83.0% | Общая таблица бенчмарков для рассуждений. |
Редакционный вердикт
Где подходит эта модель
GPT-5.6 Sol является ежедневным выбором команды уровня S для сложной работы по кодированию и продуктовой разработки. Возможно, он не кажется таким же блестящим в разговоре, как Fable 5, но надежно выполняет работу и использовался для реальных сборок и миграций приложений.
Лучшее для
Внимание
Почему она занимает это место
Доказательство
Рейтинг редакционной модели Mantis
Основной вывод: GPT-5.6 Sol в настоящее время отнесён к уровню S.
Редакционный список августа 2026 года ставит GPT-5.6 Sol на 2-е место.
Открыть источник →Связанные руководства