SpaceXAI
Grok 4.7
Кандидат с высоким соотношением цена-качество для длительного программирования и работы с знаниями, с полной опубликованной визуальной системой Mantis.
Цены на API
USD за миллион токенов · xAI API (<200K токенов запроса)- Ввод
- $2
- Вывод
- $6
- Кэшированный ввод
- $0.5
- Контекстное окно
- 500K
Попробовать активные визуальные тесты
Откройте сгенерированную сцену для тестирования или сравните этот промпт с другой моделью.
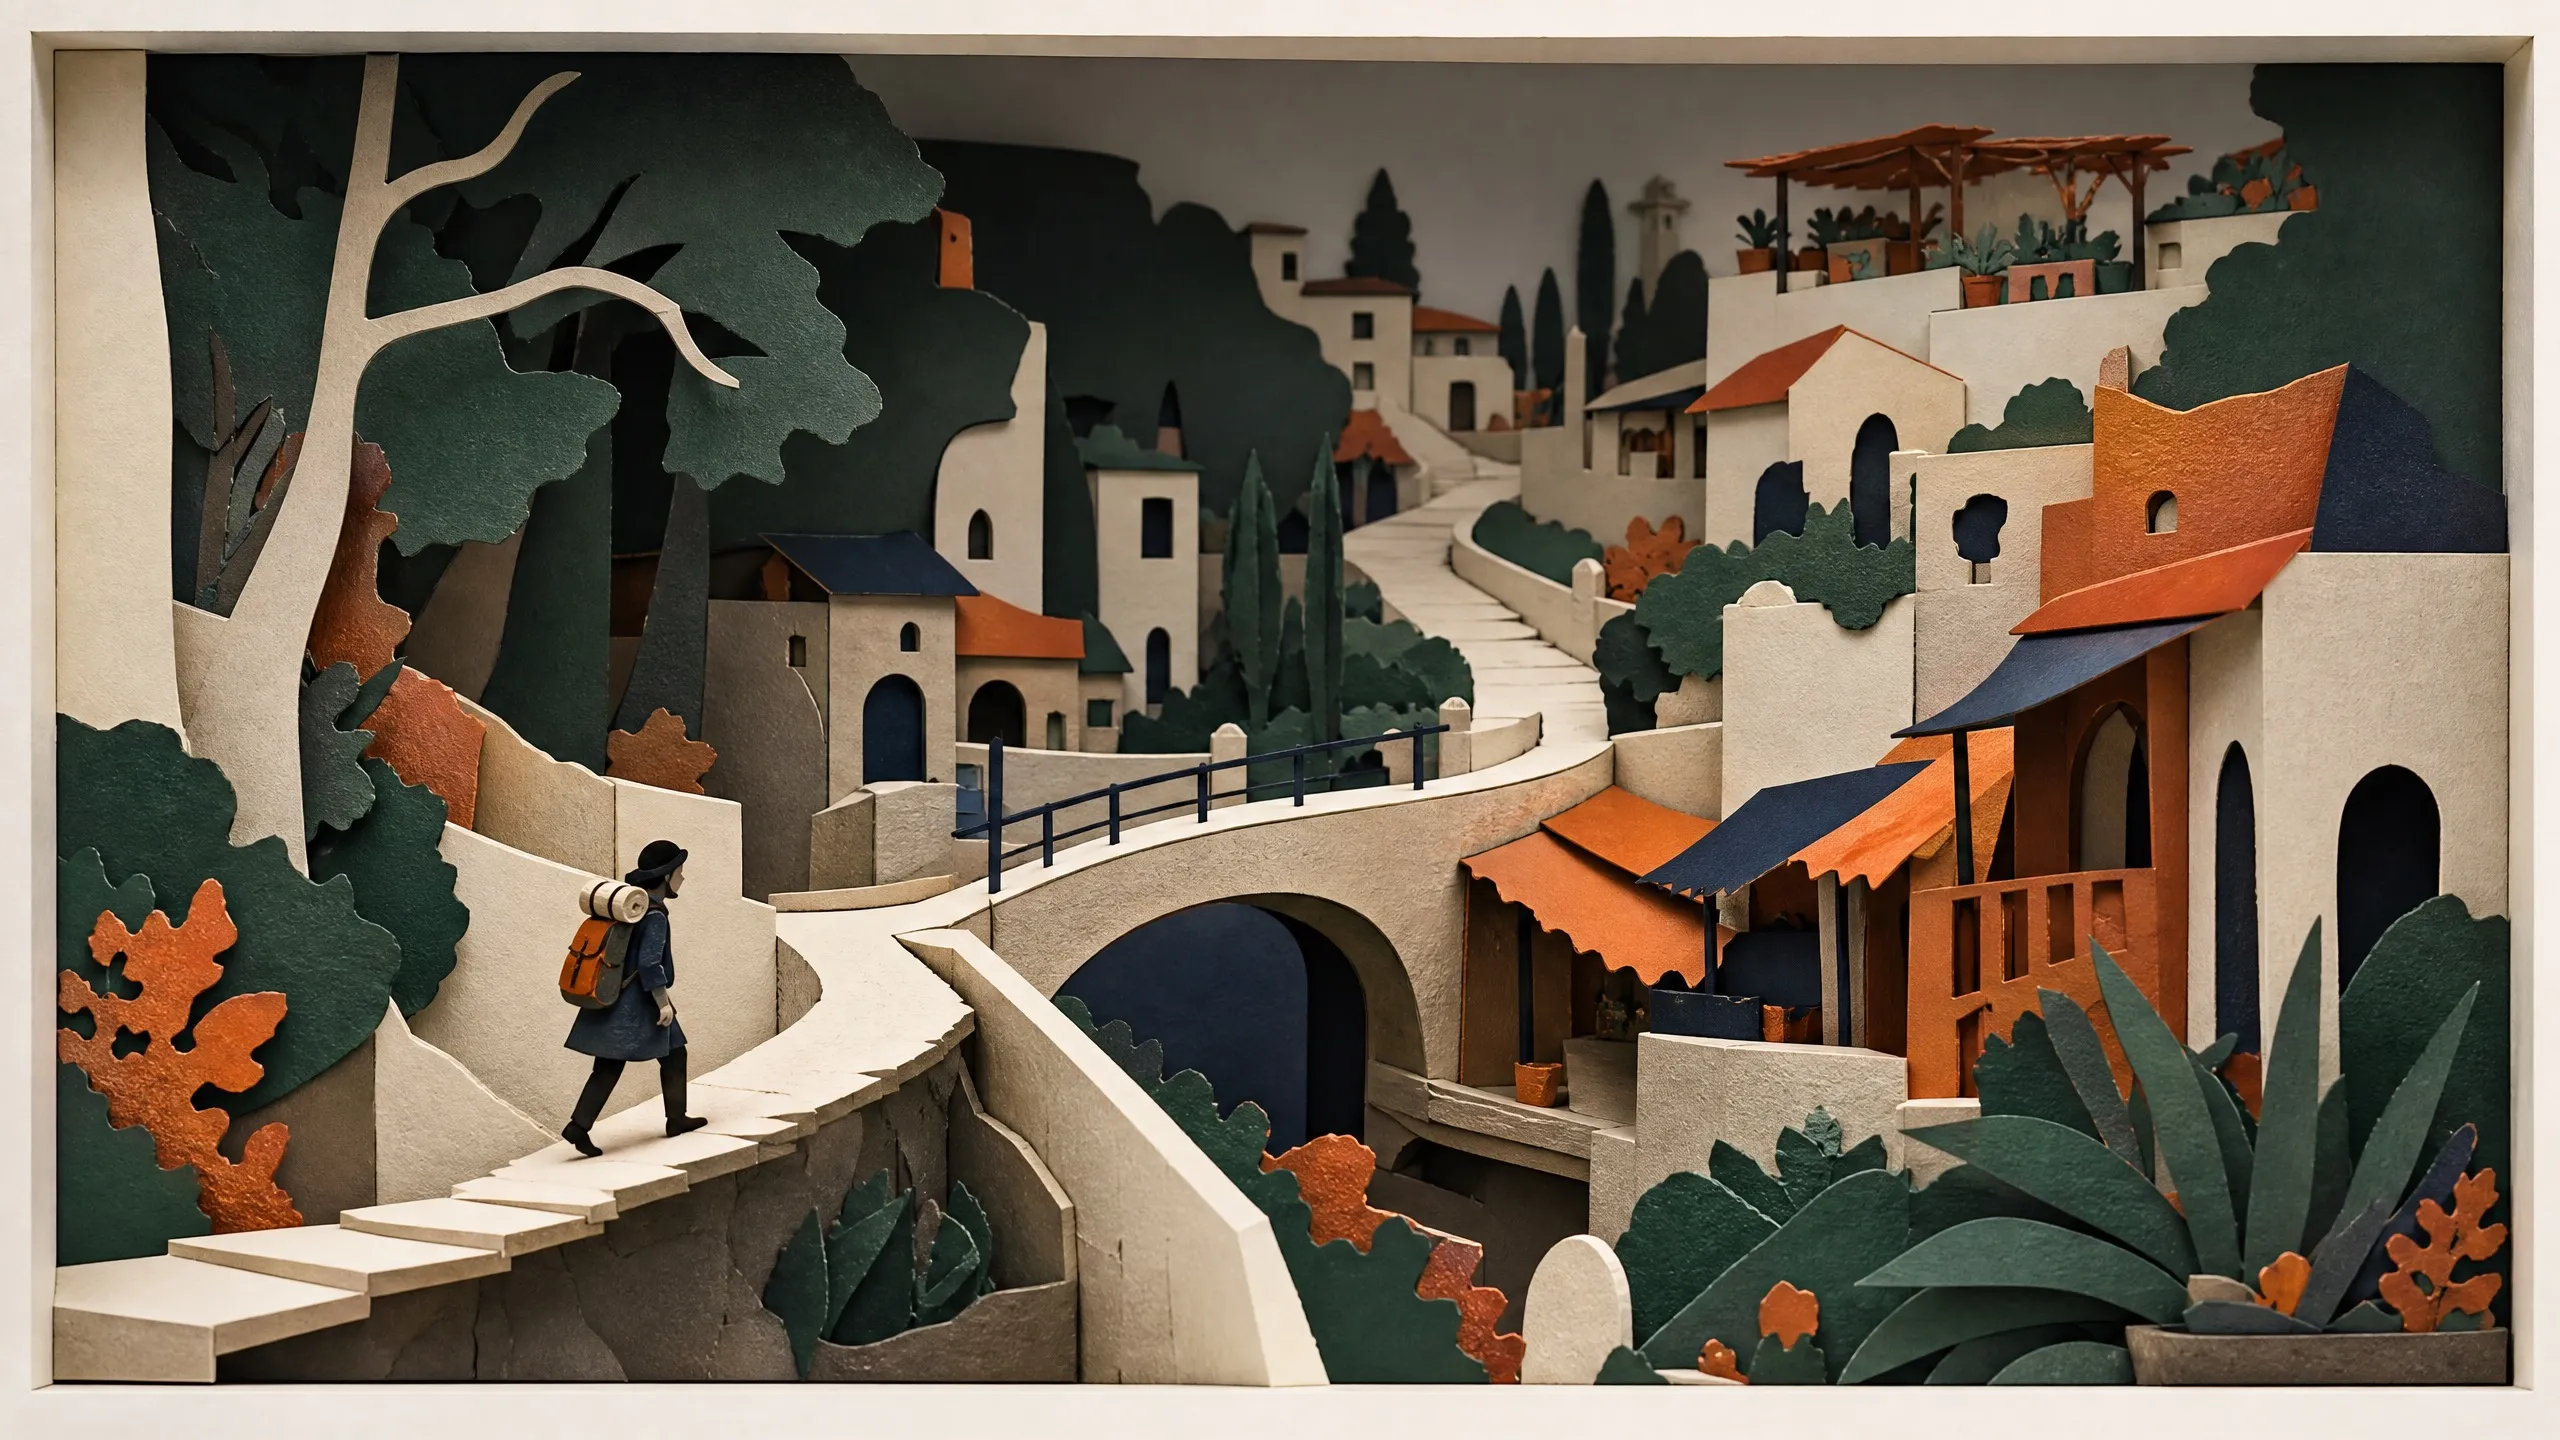
Городское путешествие по прокрутке
Дата запуска: 2026-09-22
Специализированный тест · оценка отдельно
Кинематографическое путешествие по прокрутке, тестирующее непрерывность сцен, сгенерированных ИИ, движение камеры при прокрутке и художественно оформленные посадочные аппараты.
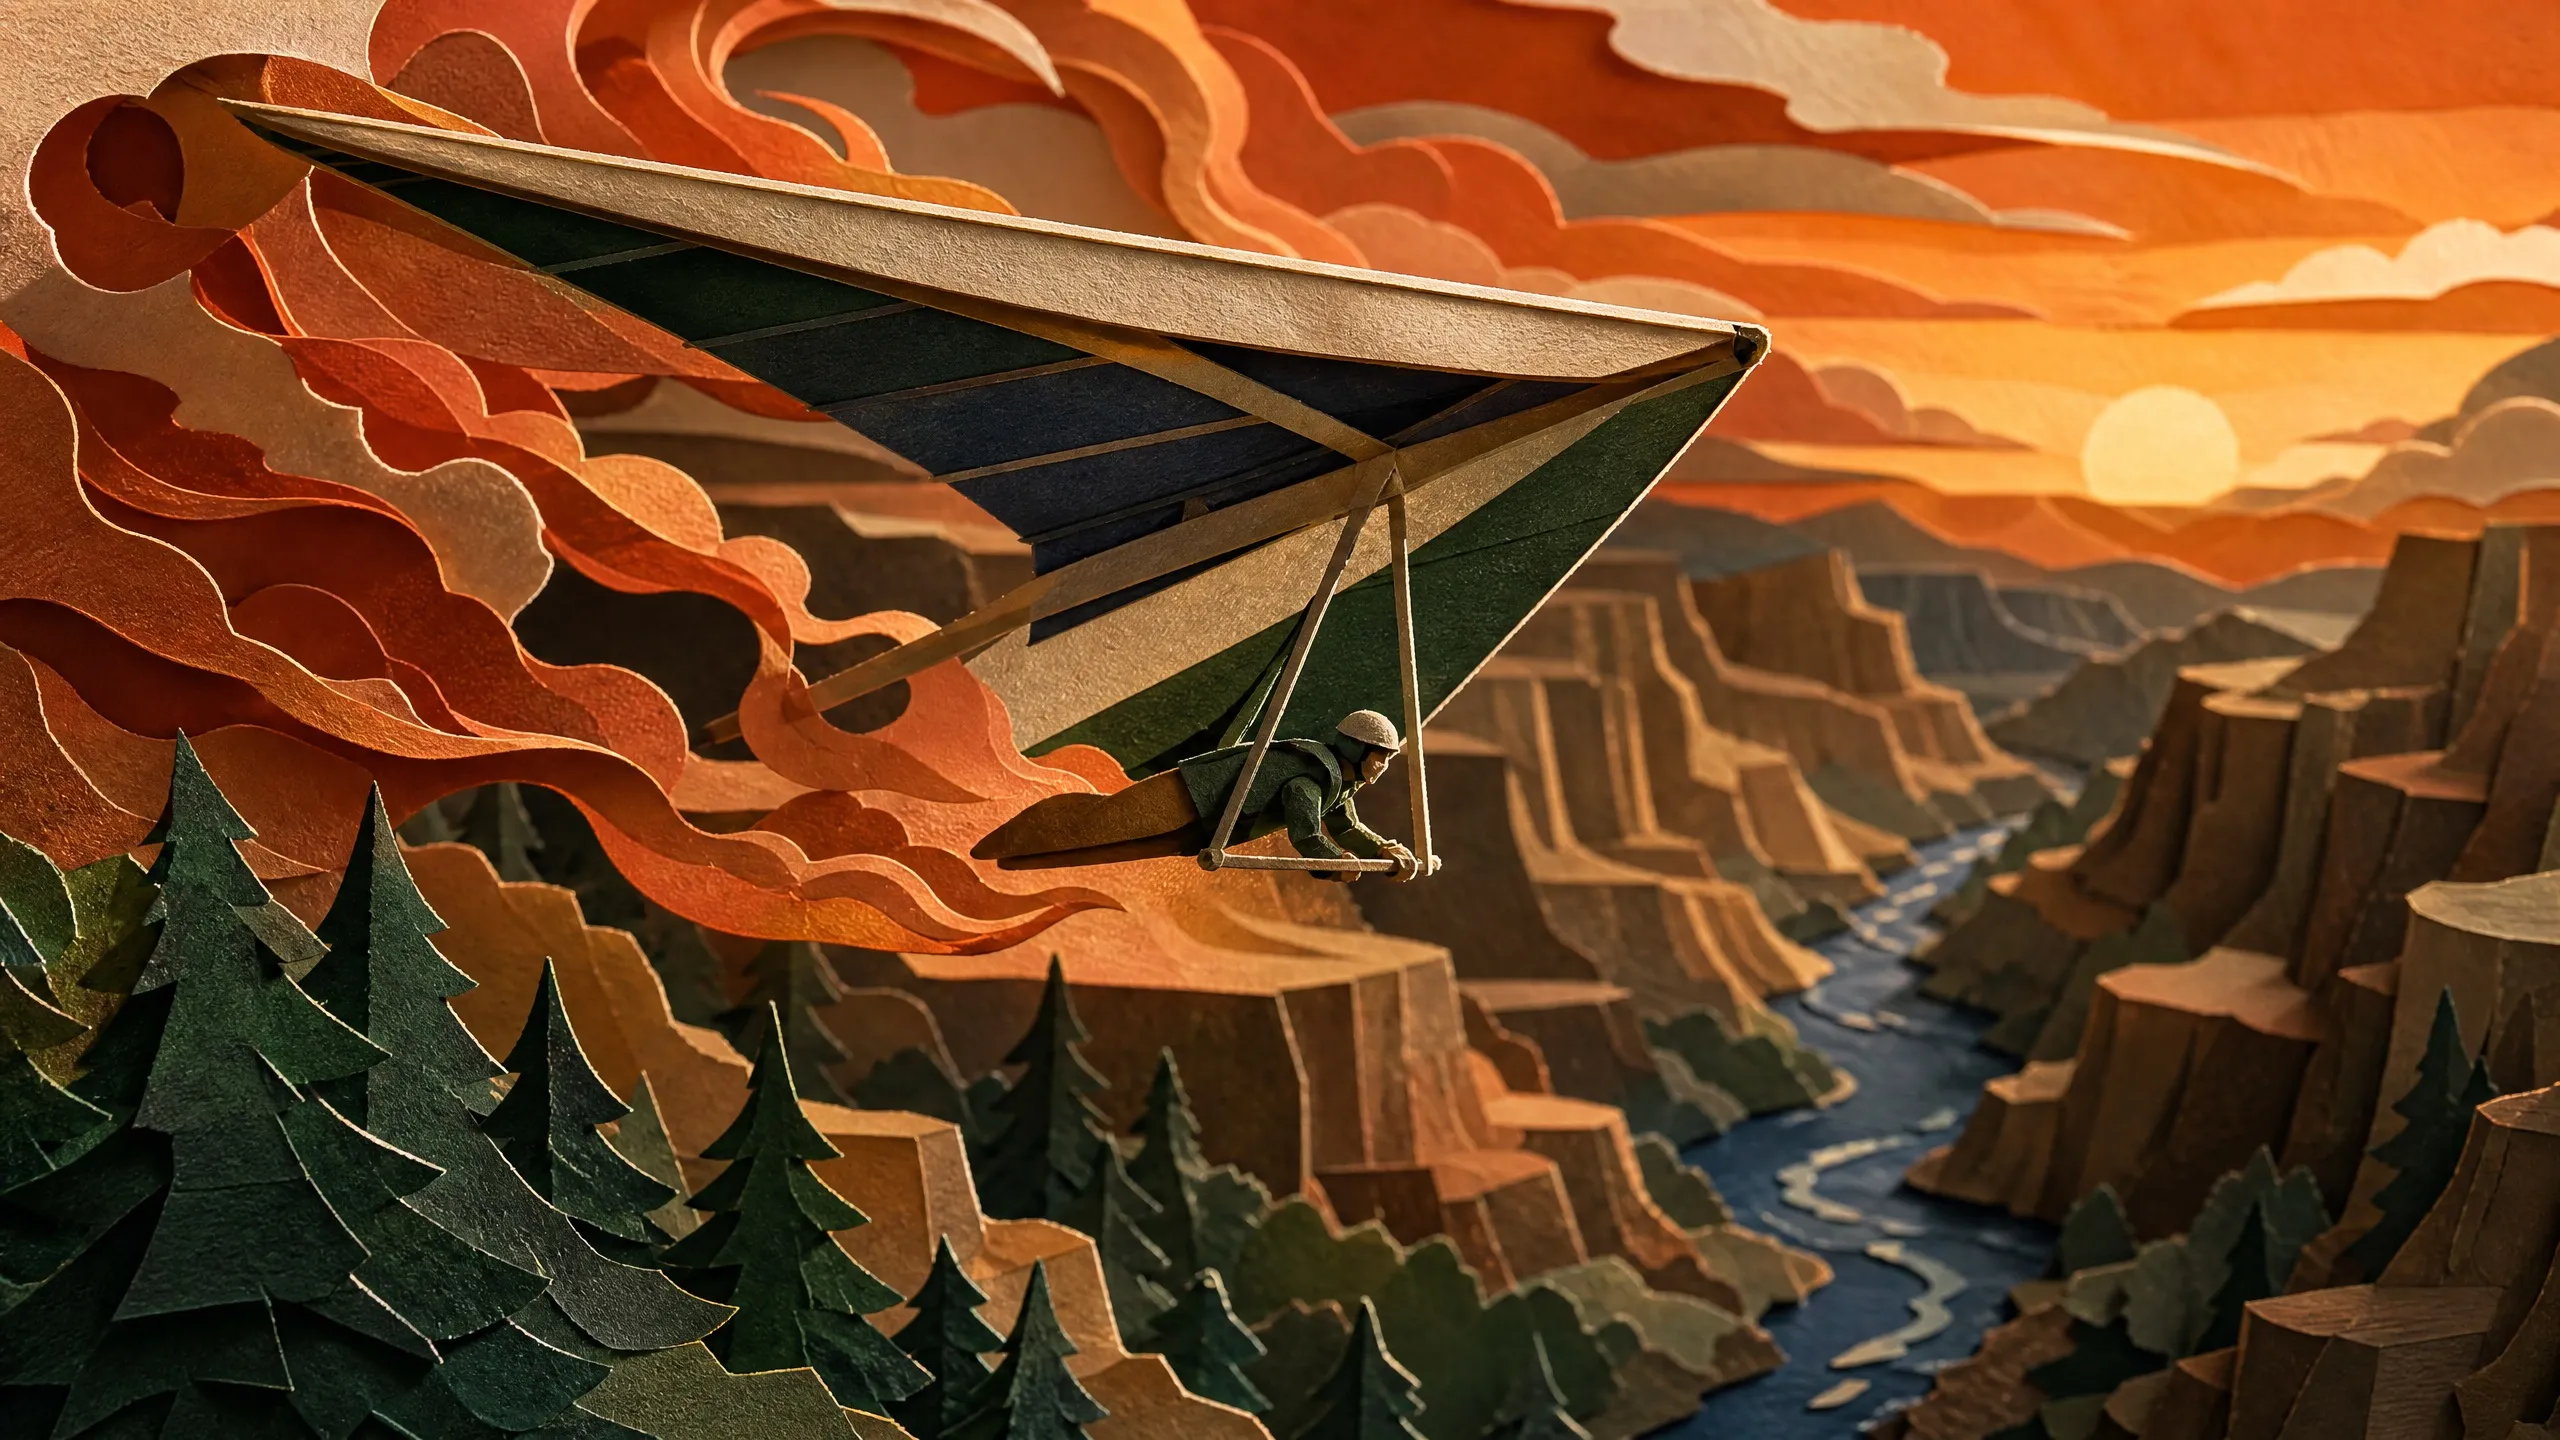
Ember Glider
Дата запуска: 2026-09-22
Закатное скользящее путешествие: тестирование управления энергией полета, потока контрольных точек и художественного оформления атмосферы.
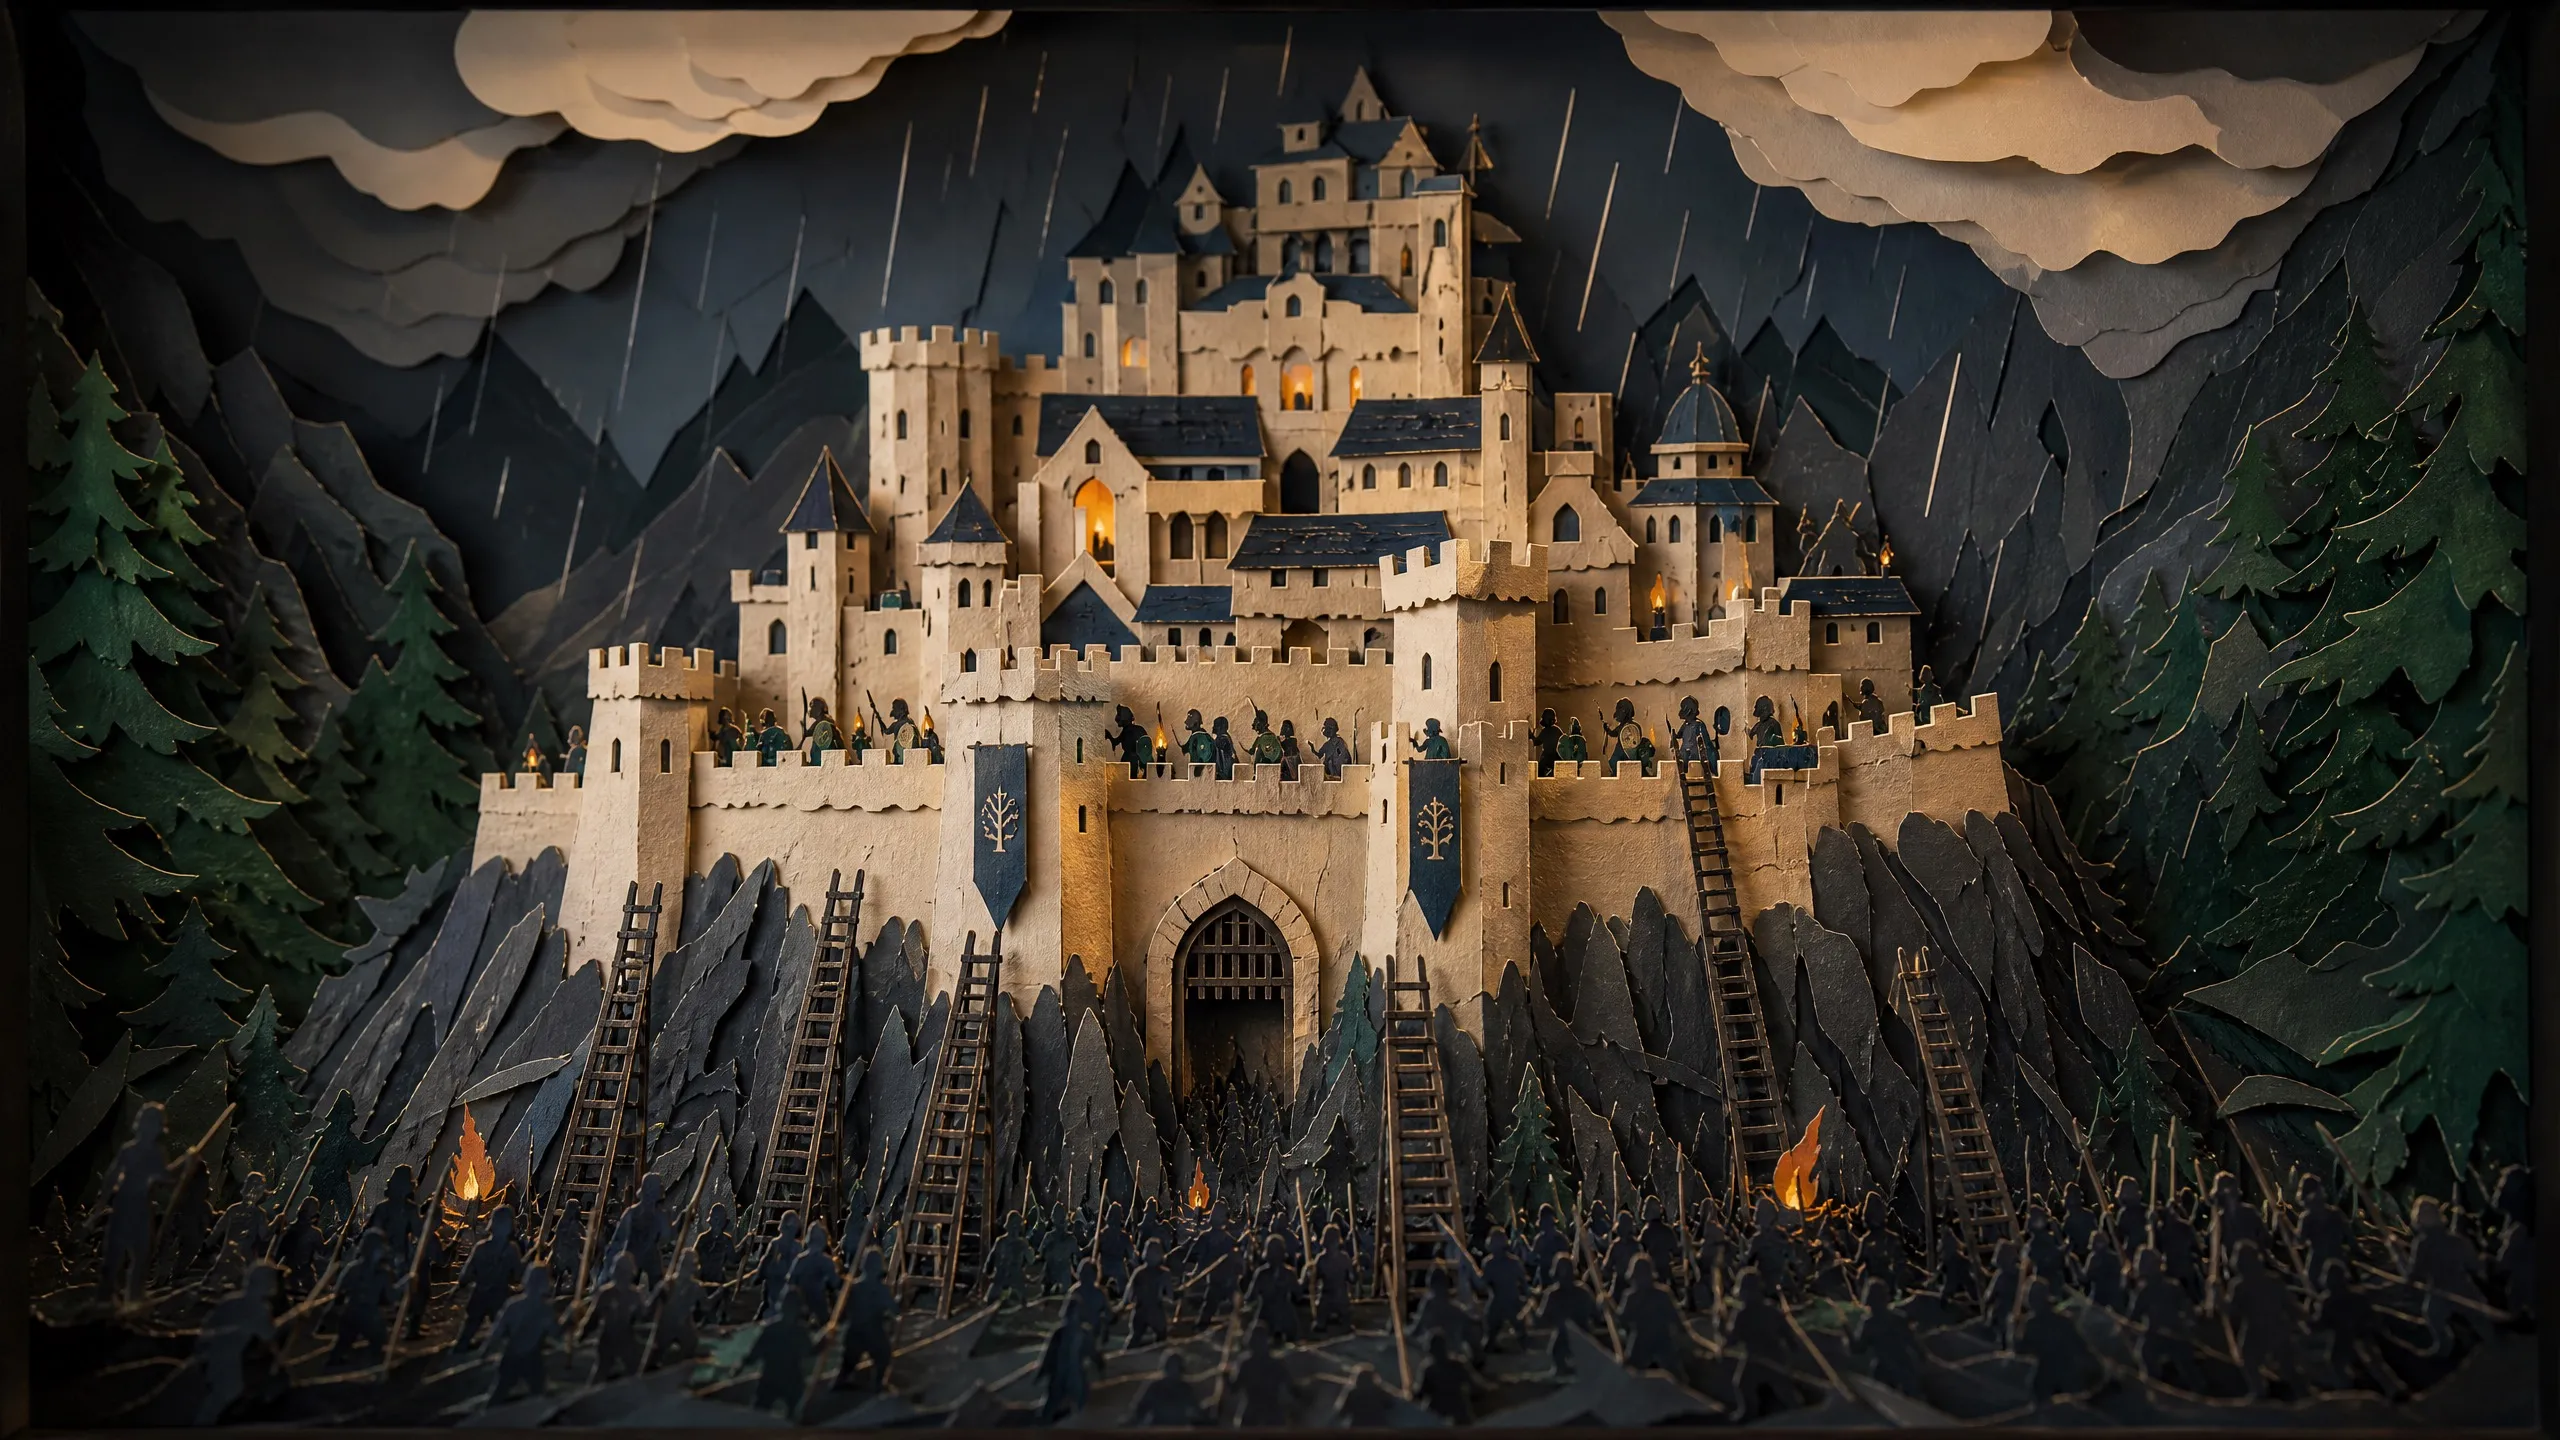
Роханская крепость
Дата запуска: 2026-09-22
Тестирование сцены осады крепости: масштаб, освещение, архитектура и кинематографическая атмосфера.
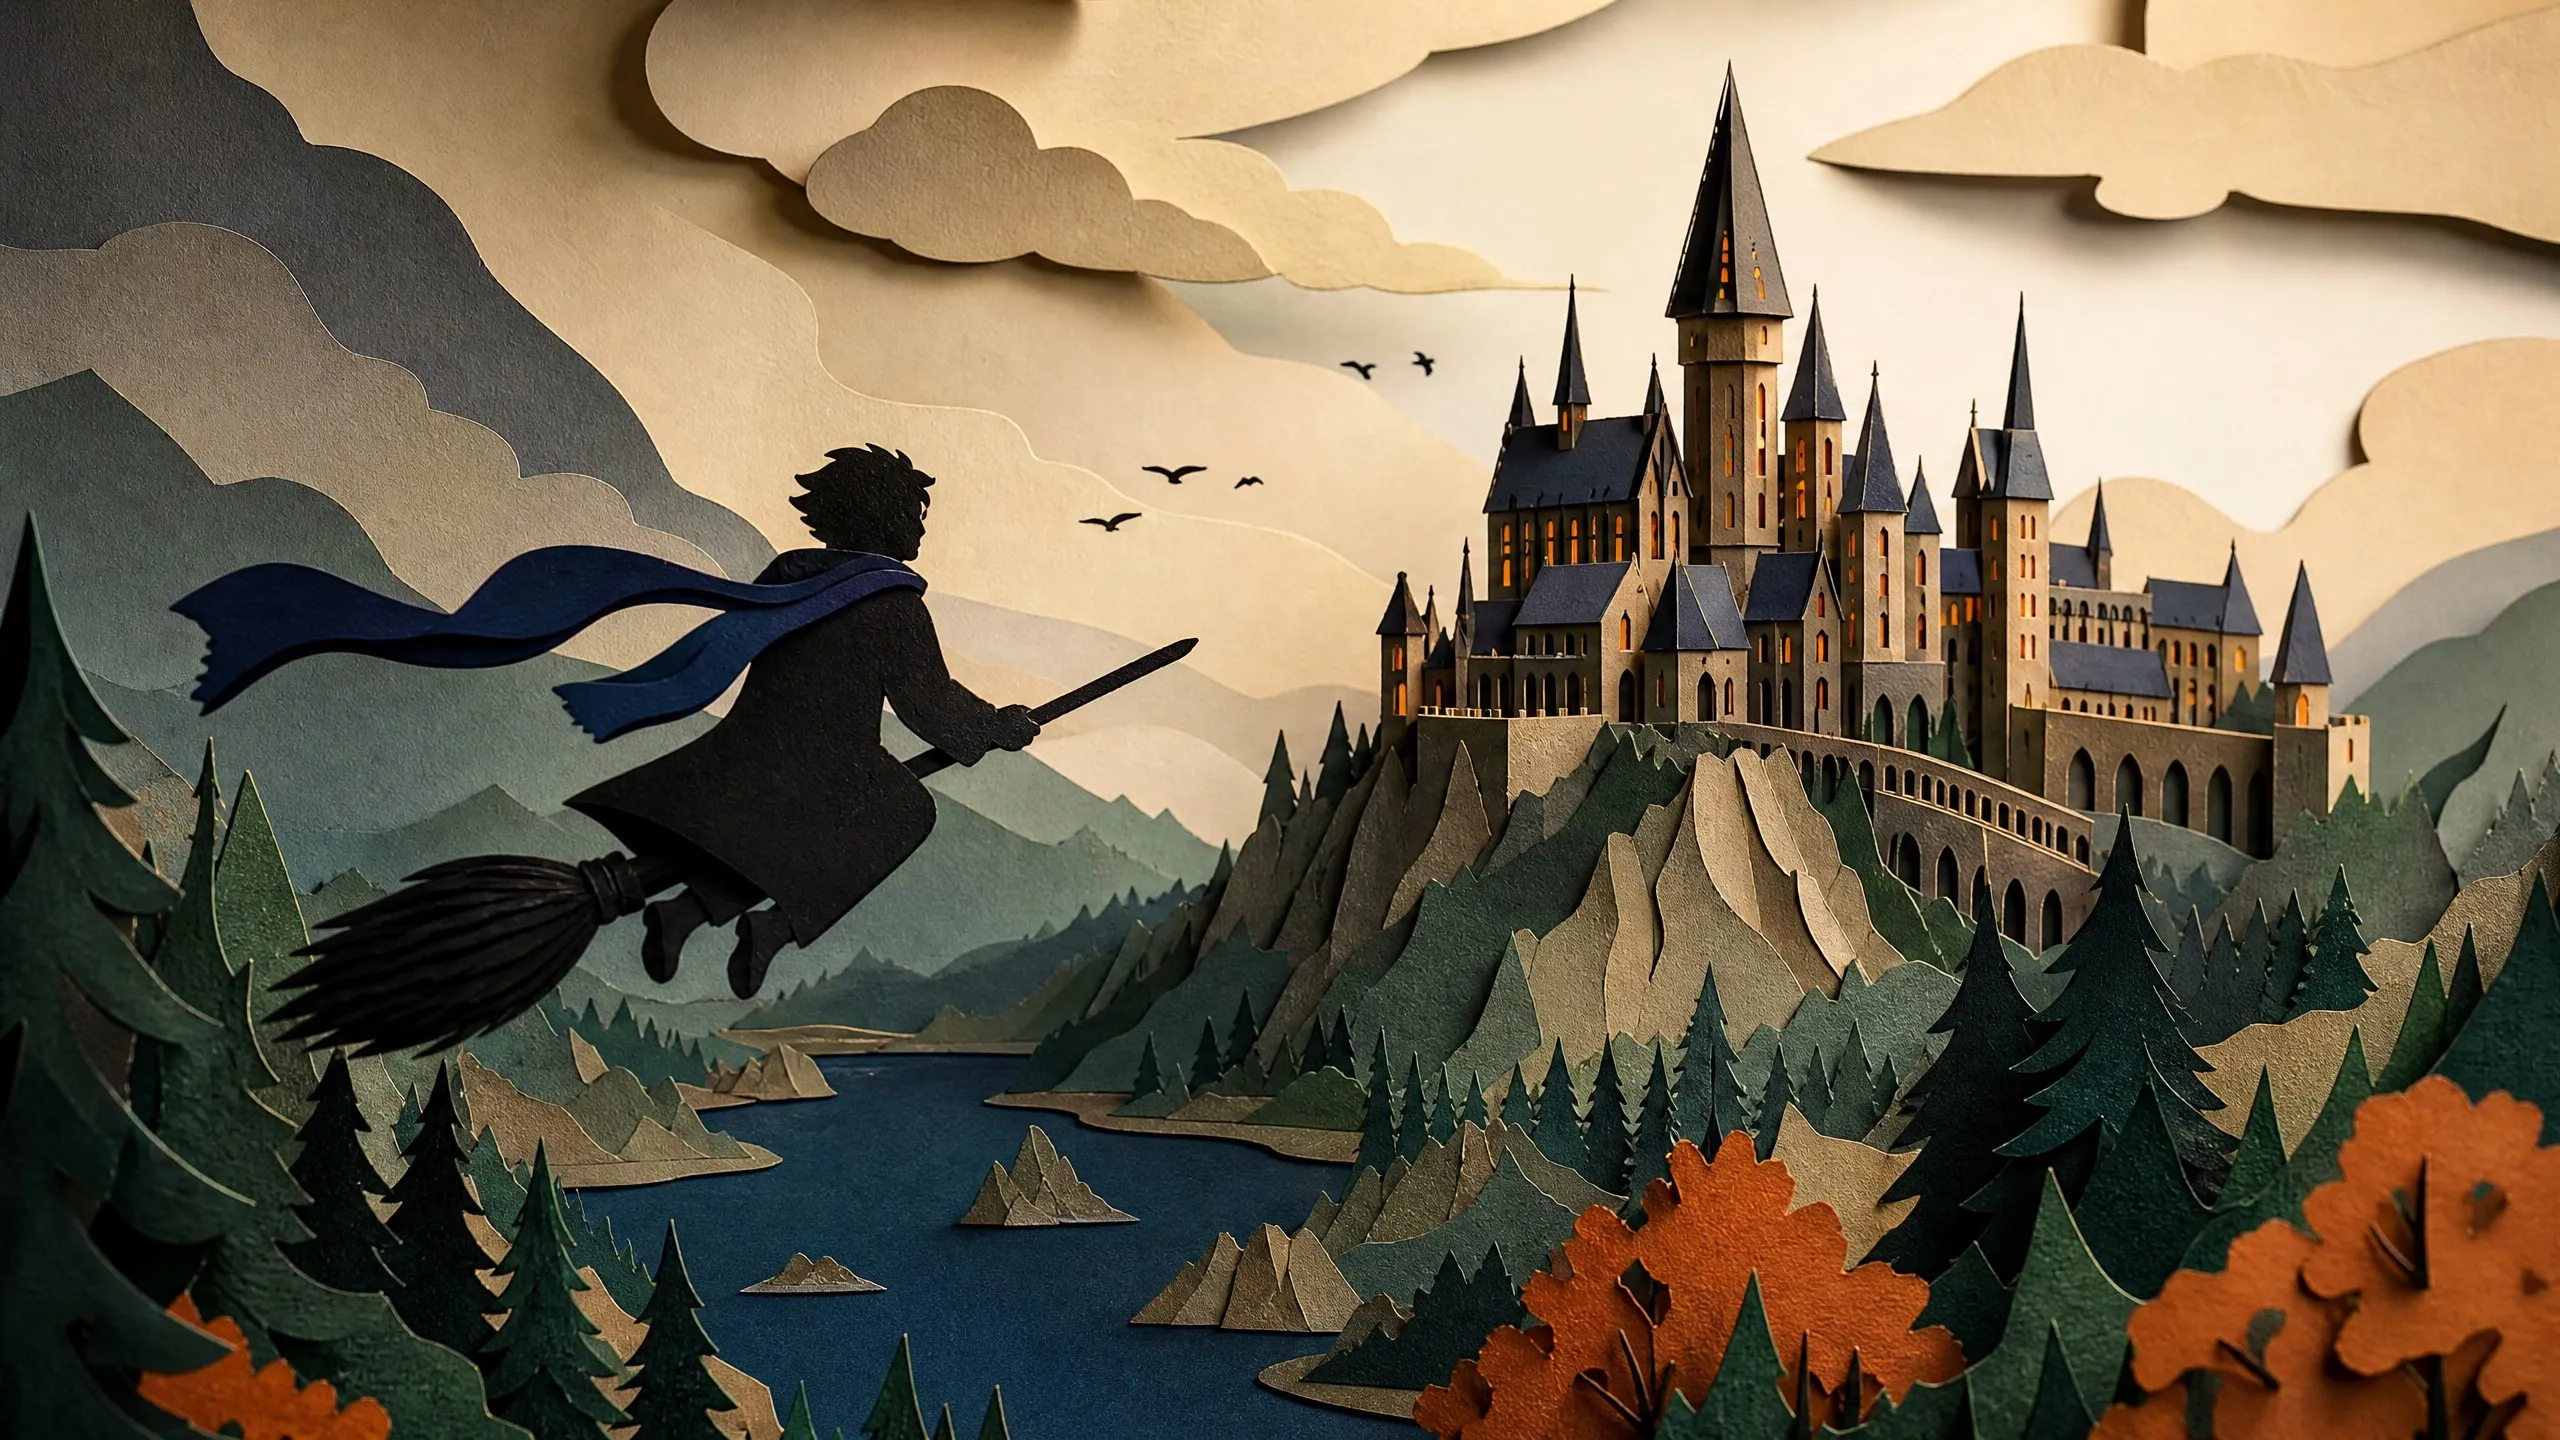
Симулятор полета на метле в Хогвартсе
Дата запуска: 2026-09-22
Тестирование сцены полета на метле: глубина, визуальные подсказки движения, масштаб замка и фантастическое настроение.
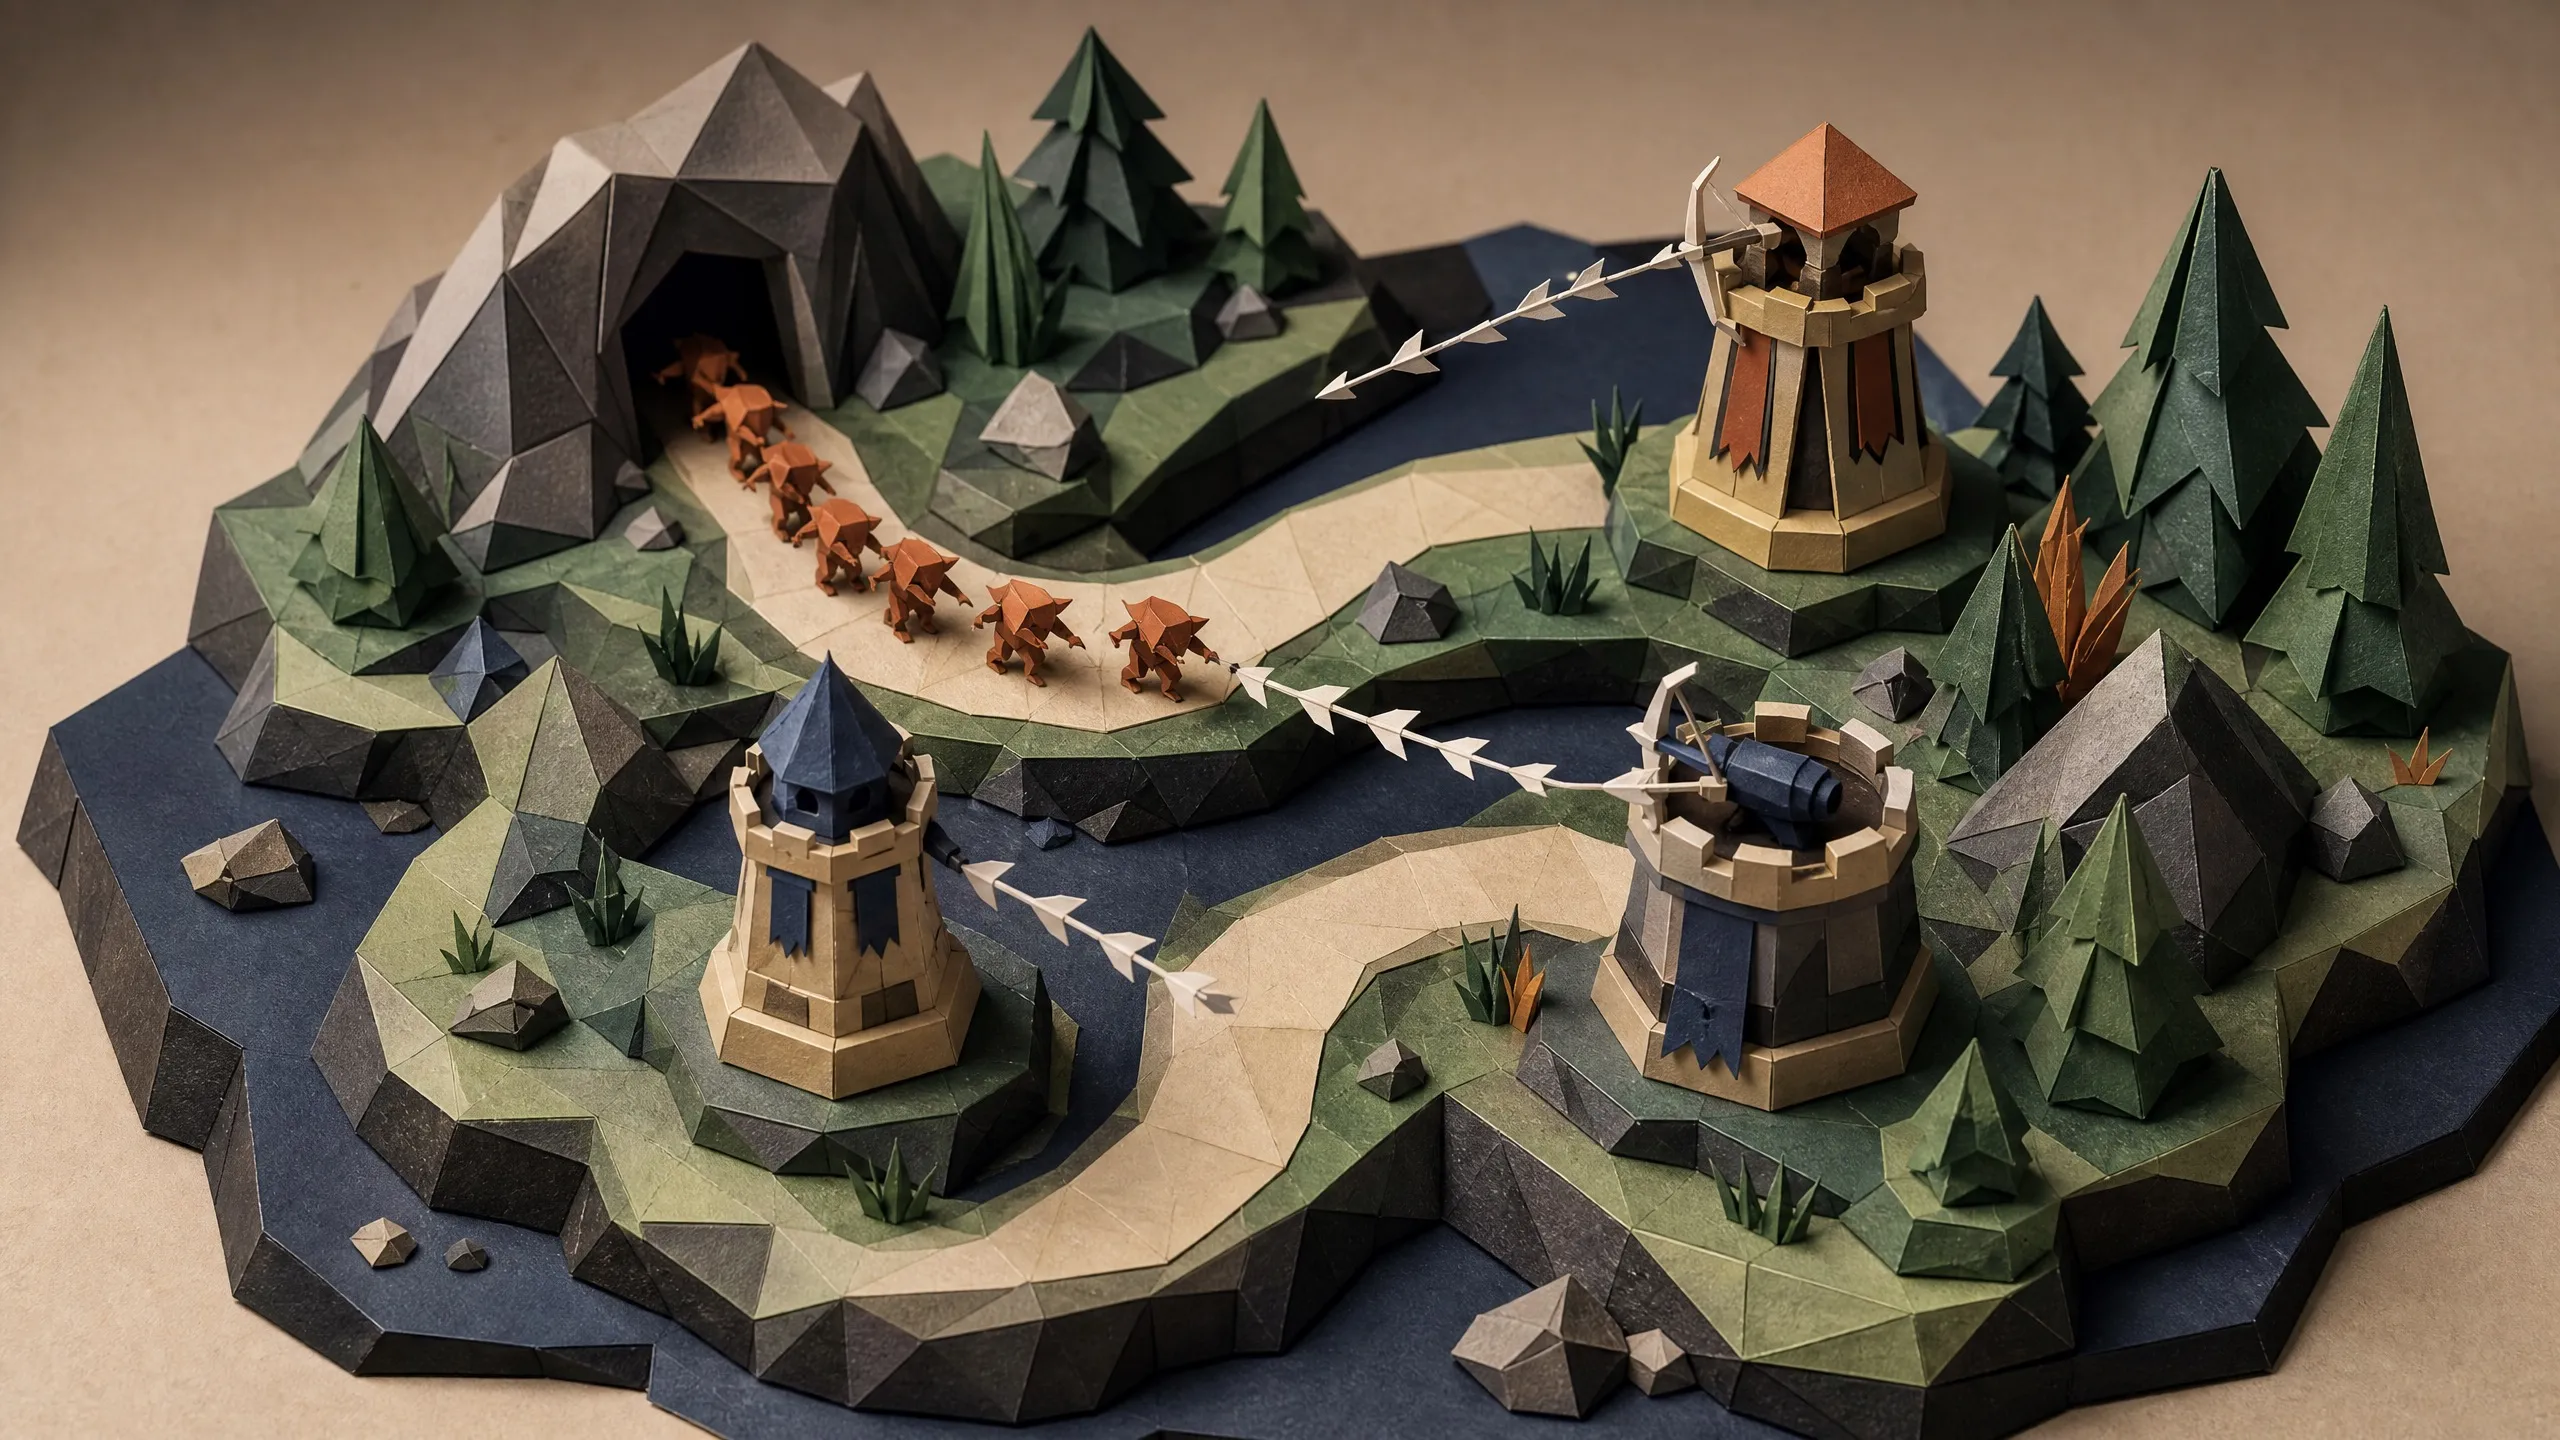
Low-Poly Tower Defense
Дата запуска: 2026-09-22
Оборона башни диорамы: тестирование баланса экономики, дизайна волн, правил расстановки и читаемости боя.
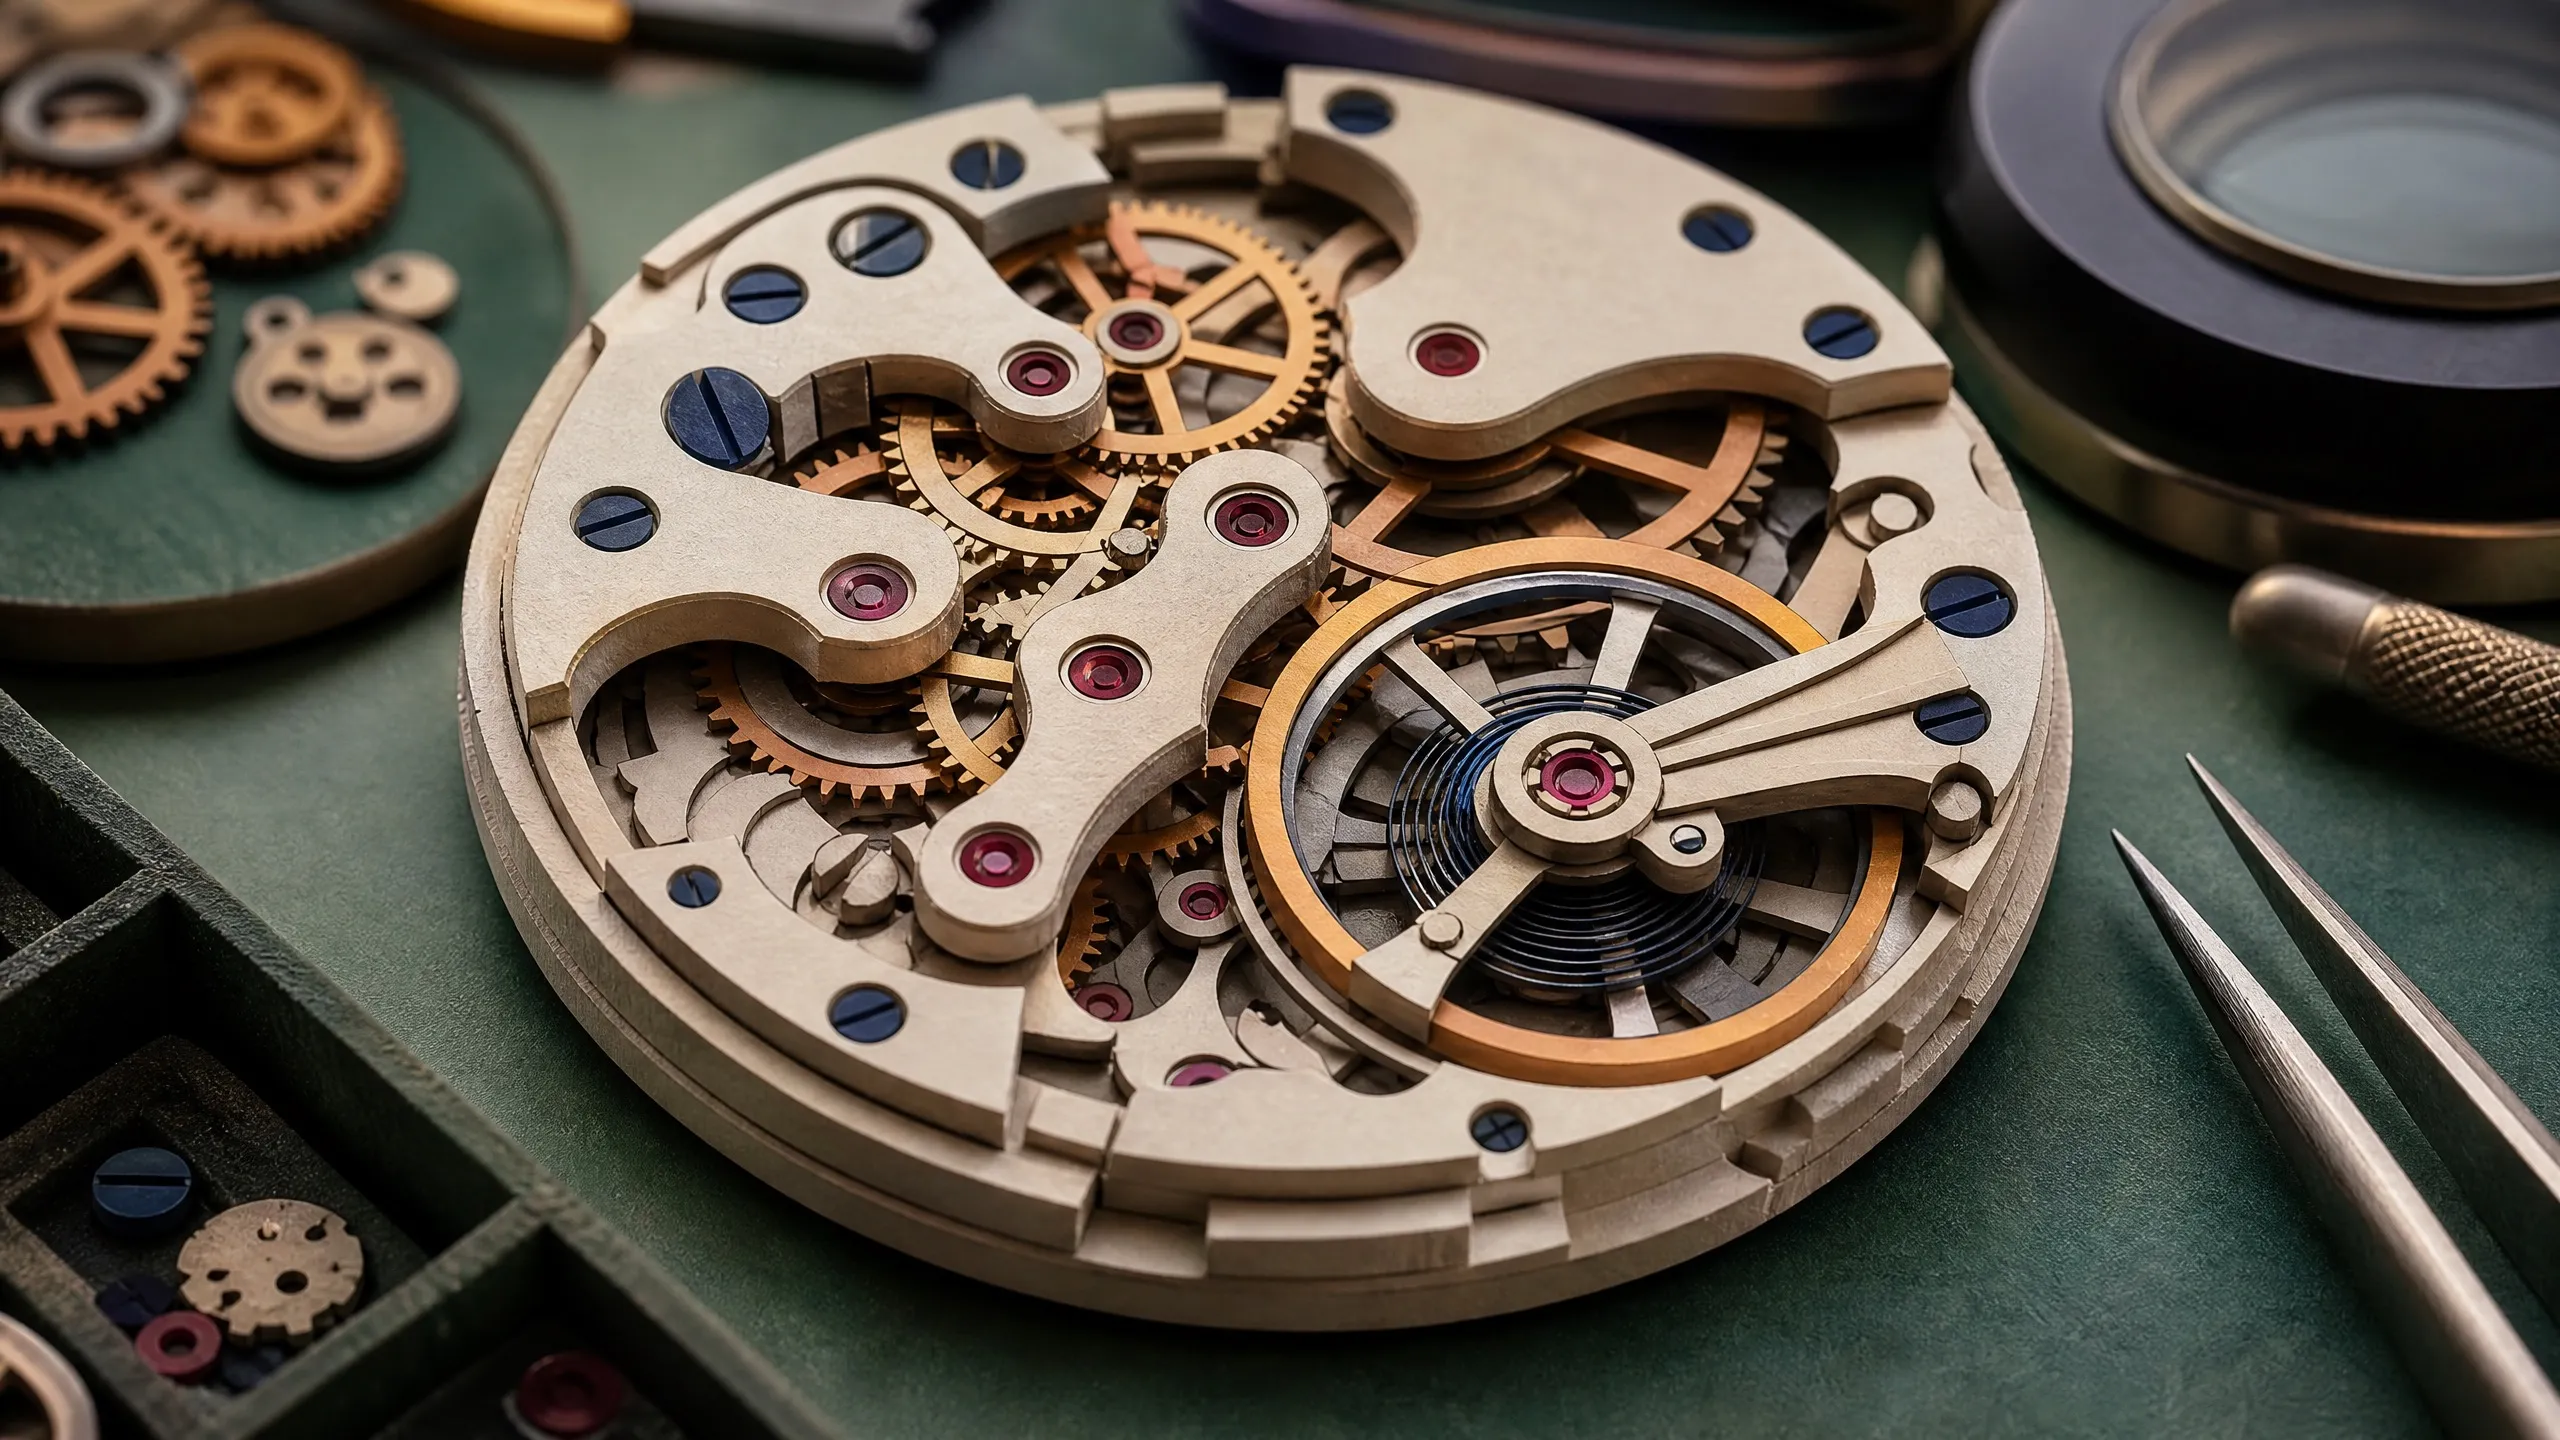
Симулятор механических часов
Дата запуска: 2026-09-22
Интерактивное тестирование часов: механическая читаемость, точное относительное движение и управление в 3D в реальном времени.
Neon Drift
Дата запуска: 2026-09-22
Гоночные соревнования синтвейва на время: тестирование физики заносов, времени кругов, повтора привидений и прогрессии разблокировок.
Арена Звездопада
Дата запуска: 2026-09-22
Выживание в неоновой арене: тестирование нарастания волн, сборки улучшений, обратной связи частиц и дизайна боссов.
Симулятор Требушета Штормграда
Дата запуска: 2026-09-22
Тестирование осадного моделирования Counterweight с проверкой связанных механизмов, предсказанием траектории, камерами для снарядов и интерактивной настройкой.
Сборка по «Yingzao Fashi»
Дата запуска: 2026-09-22
Специализированный тест · оценка отдельно
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Снятые с эксплуатации тесты · 6 заархивированных запусков
Эти тесты больше не входят в активный набор. Их исходные результаты остаются доступными для просмотра.
Сравнение Grok 4.7
Трое соответствующих коллег, бок о бок.
- Grok 4.7 Эта модель
- Fable 5.1 максимальный
- GPT-5.6 Sol макс
- Grok 4.6 высокий
6 бенчмаркs · 4 модели
Официальный профиль бенчмарка
Опубликованные результаты Grok 4.7 по долговременному кодированию и интеллектуальной работе
CursorBench 4.0
46.3%DeepSWE v1.1
71.0%EEBench
64.0%Полная официальная таблица бенчмарков9 оценок и сравнение с коллегами
| Бенчмарк | Площадь | Балл | Сравнение |
|---|---|---|---|
| CursorBench 4.0 | Разработка программного обеспечения | 46.3% | |
| DeepSWE v1.1 | Разработка программного обеспечения | 71.0% | |
| EEBench | Электротехника | 64.0% | |
| AA Briefcase v1.1 | Многочасовая офисная работа | 1,657 | |
| Terminal-Bench 4.0 | Многочасовая работа в терминале | 38.0% | |
| Эталонный показатель юридического агента Harvey | Юридическая работа | 19.6% | |
| Профессиональный HealthBench | Клиническое рассуждение | 56.7% | |
| Эталон биобезопасности LatchBio | Биобезопасность | 62.4% | |
| HackerBench v0.3 с разрешением рискованных запросовЧем ниже, тем лучше | Кибербезопасность | 3.3% |
Источники, детали ценообразования и методология
Проверенные данные о модели
Характеристики модели
- Статус
- Текущий
- ID модели API
grok-4.7- Контекст
- 500K
- Максимальный вывод
- Не подтверждено публично
- Лицензия
- Не подтверждено публично
- Способ доступа
- Публичный xAI API, Grok Build, Cursor и поддерживаемые шлюзы моделей. Grok 4.7 Fast — это та же модель, но с более быстрой обработкой при вдвое большей скорости токенов; доступна только в Cursor и Grok Build, не через публичный xAI API.
- Модальности
- ввод текста, ввод изображения, вывод текста
- Аппаратное обеспечение
- Не подтверждено публично
- xAI API (<200K токенов запроса) · USD / 1M токенов
- $2 за вход · $0.5 за кэшированный вход · $6 за вывод
При 200K токенов запроса или более, все токены в запросе используют $4 за вход, $1 за кэшированный вход и $12 за вывод на 1M токенов. Grok 4.7 Fast стоит вдвое дороже стандартных тарифов и недоступен через публичный xAI API. Американский региональный эндпоинт добавляет премию 10%.
Источники бенчмарков
SpaceXAI оценивает Grok 4.7 на семи тестах по программированию, терминалу, профессиональной работе, здравоохранению и инженерии. Mantis сохраняет результаты этих поставщиков отдельно от опубликованных визуальных запусков с одинаковыми запросами.
Представляем Grok 4.7Это значения таблицы запусков от первого лица. Grok 4.7 использует очень высокие усилия, за исключением отмеченного результата DeepSWE v1.1, который использует высокие усилия; конфигурации участников сохраняются в метках сравнения.
Настройки оценки
- Результат таблицы запусков SpaceXAI; Grok 4.7 очень высокие усилия.
- Результат таблицы запусков SpaceXAI; Grok 4.7 высокие, а не очень высокие усилия.
- Оценка таблицы запусков SpaceXAI; Grok 4.7 очень высокие усилия; выше — лучше.
- Результат запуска, сообщенный SpaceXAI, для безвредного использования и безопасного отказа.
- Результат запуска, сообщенный SpaceXAI; ниже — лучше для рискованных или вредоносных разрешенных запросов.
- DeepSWE v1.1
- В таблице запусков только этот результат Grok 4.7 отмечен звездочкой за высокие усилия.
Локальная методология визуального запуска и записи валидации
Редакционный вердикт
Где подходит эта модель
Grok 4.7 — флагман SpaceXAI сентября для программирования, агентских задач и работы с знаниями. Данные запуска показывают значительные улучшения по сравнению с 4.6 при длительном программировании, работе в терминале, инженерных заданиях и профессиональной работе при той же стандартной цене API. Все 16 запусков визуальной Mantis с одинаковыми запросами опубликованы и остаются отдельными от этих внутренних показателей.
Лучшее для
Внимание
Почему она занимает это место
Доказательство
Рейтинг редакционной модели Mantis
Основной вывод: Grok 4.7 в настоящее время отнесен к уровню A.
Редакционный список на сентябрь 2026 года ставит Grok 4.7 на 4-е место.
Открытый исходный код →Представляем Grok 4.7
Основной вывод: Grok 4.7 заменяет 4.6 в текущем редакционном списке, при этом его оценки первой стороны хранятся отдельно от визуального набора тестов.
SpaceXAI публикует конфигурацию запуска и таблицу сверстников. Визуальные прогонки Mantis являются отдельным слоем доказательств с тем же запросом.
Открытый исходный код →Связанные руководства