Moonshot AI
Kimi K3
Выбор Late-A с сильной способностью работать на длинных горизонтах, сдерживаемый затратами и лимитами квоты.
Цены на API
USD за миллион токенов · API Kimi- Ввод
- $3
- Вывод
- $15
- Кэшированный ввод
- $0.3
- Контекстное окно
- 1.05М
Рекомендуется для этого руководства
Кими
Используйте ту же семью Kimi, что тестировалась на этой странице. Проверьте текущий план и доступность модели перед подпиской.
Лучшее для: Настройки Claude Code и работа с учётом стоимости модели
Проверить планы KimiПартнерская ссылка. Она поддерживает Mantis без дополнительных затрат для вас.Попробовать активные визуальные тесты
Откройте сгенерированную сцену для тестирования или сравните этот промпт с другой моделью.
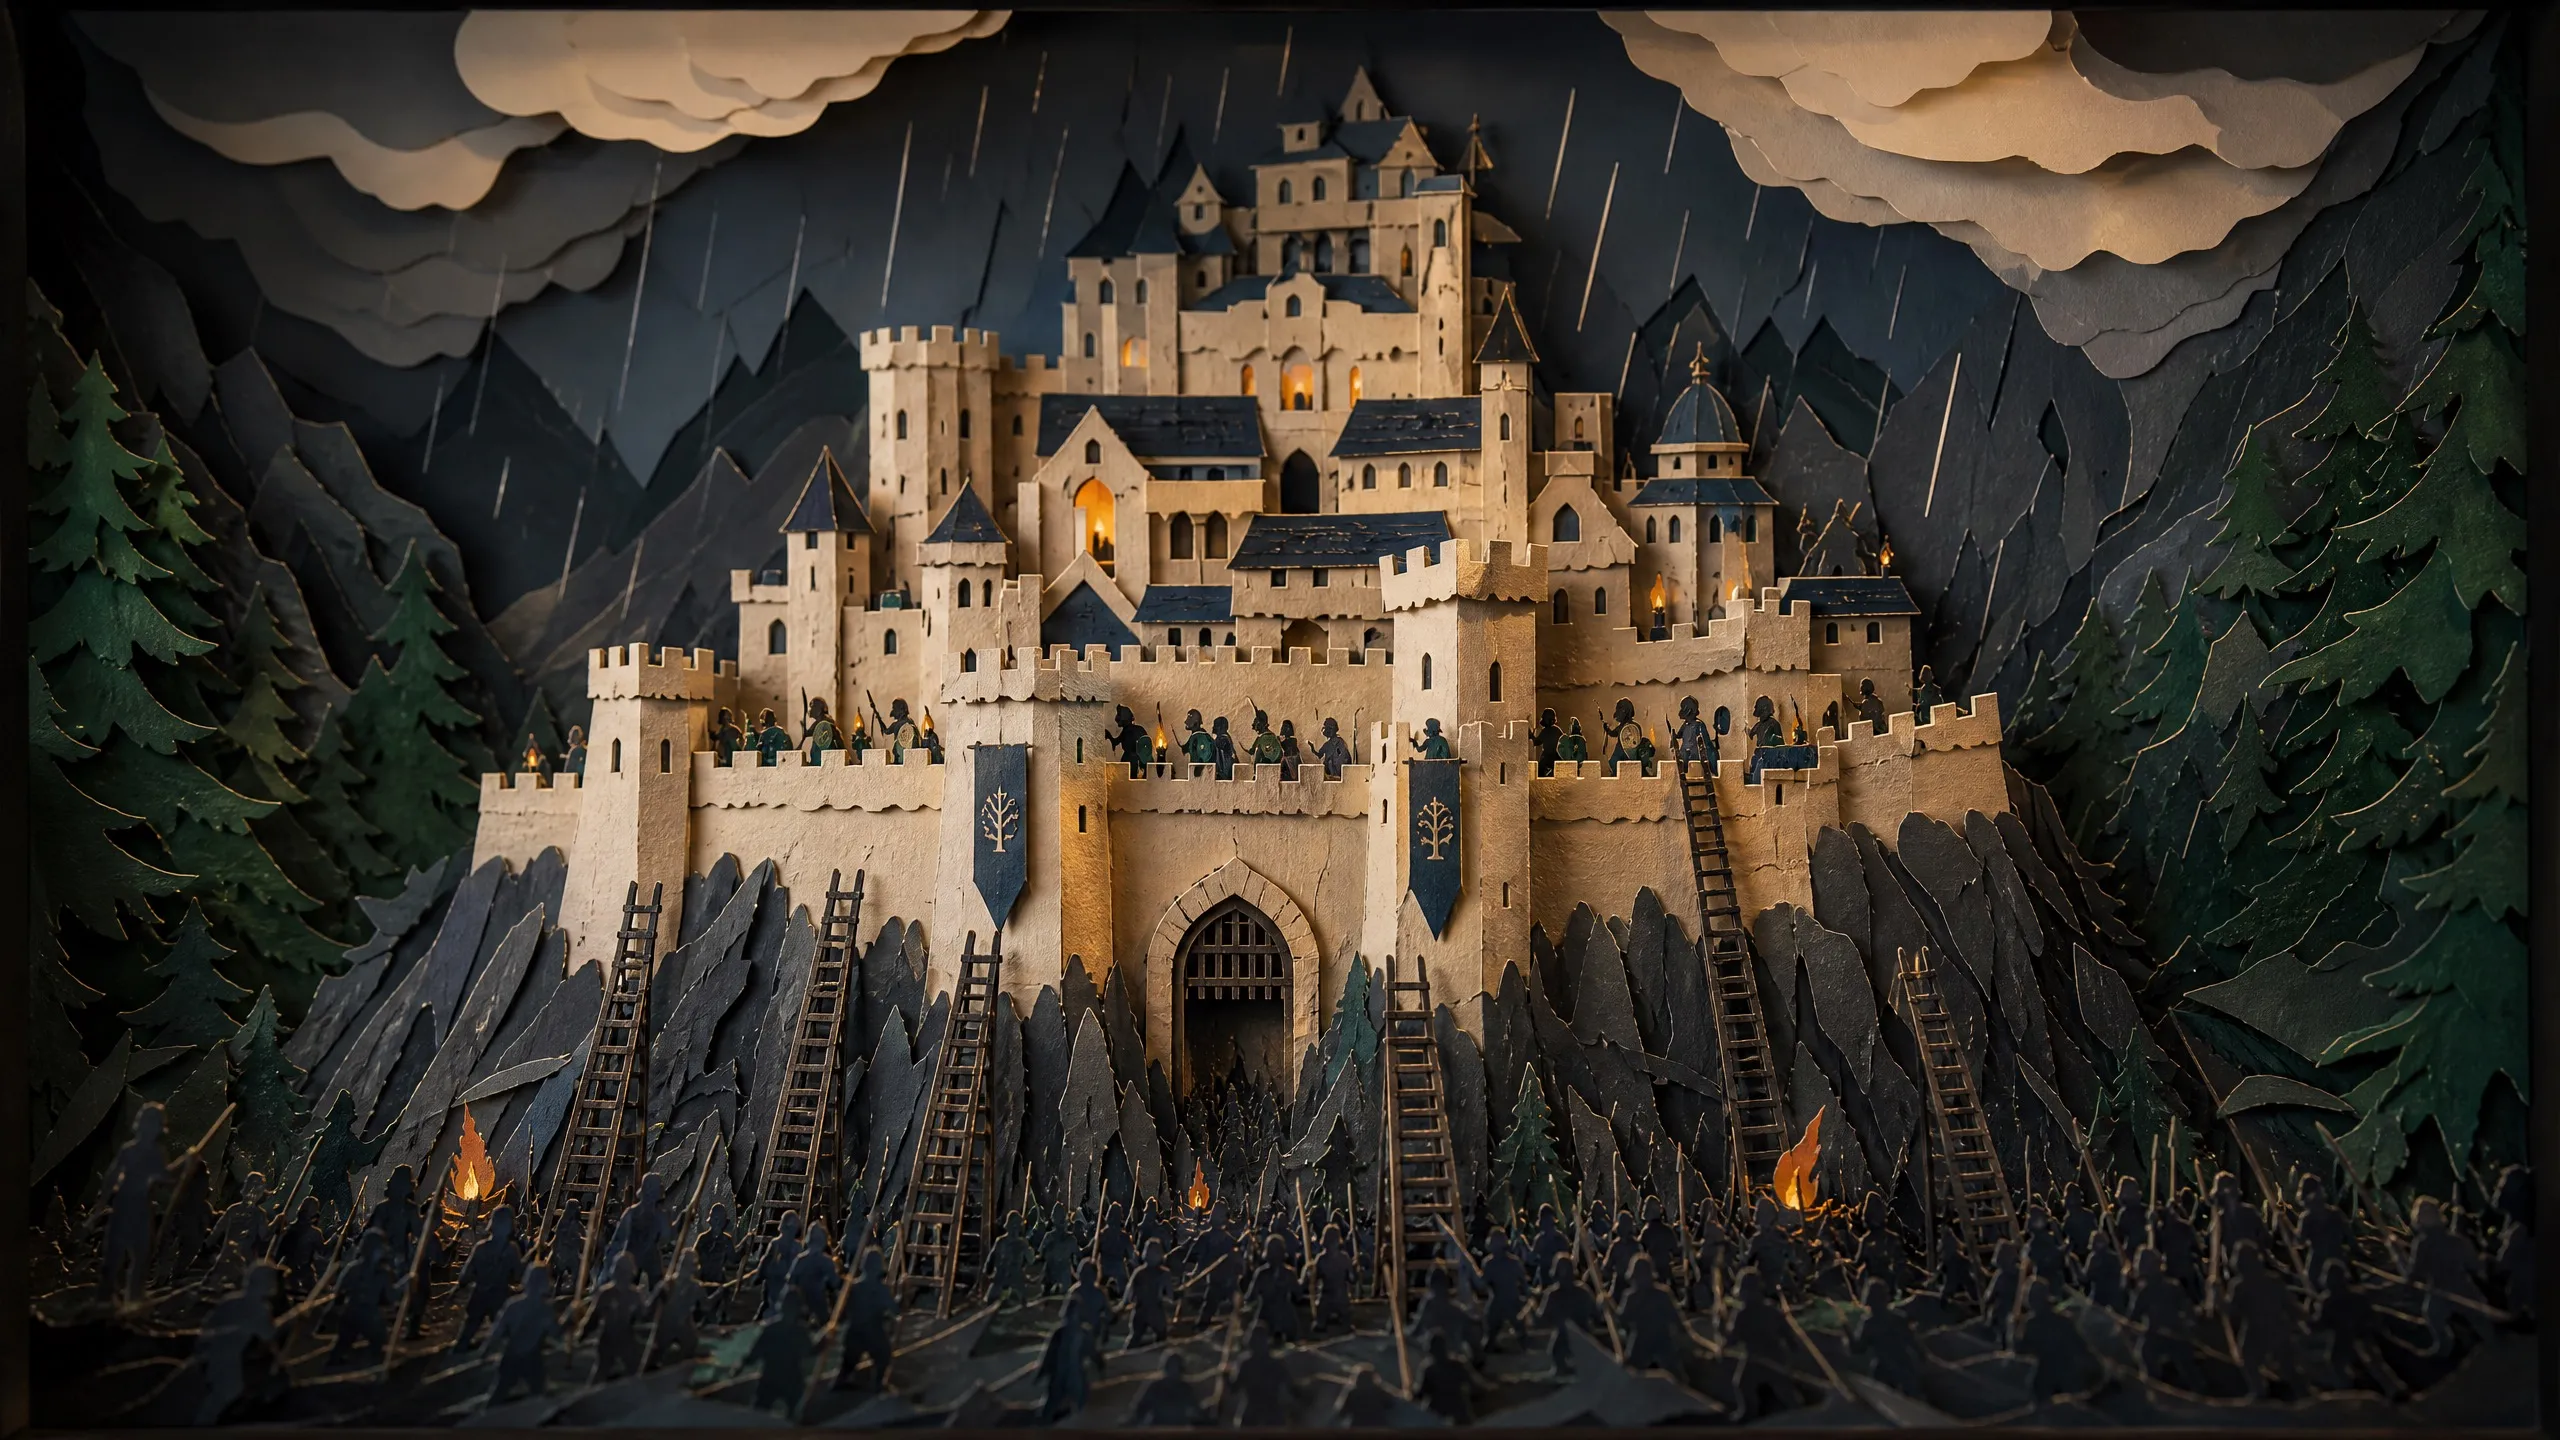
Хельмова Падь
Дата запуска: 2026-07-16
Тестирование сцены осады крепости: масштаб, освещение, архитектура и кинематографическая атмосфера.
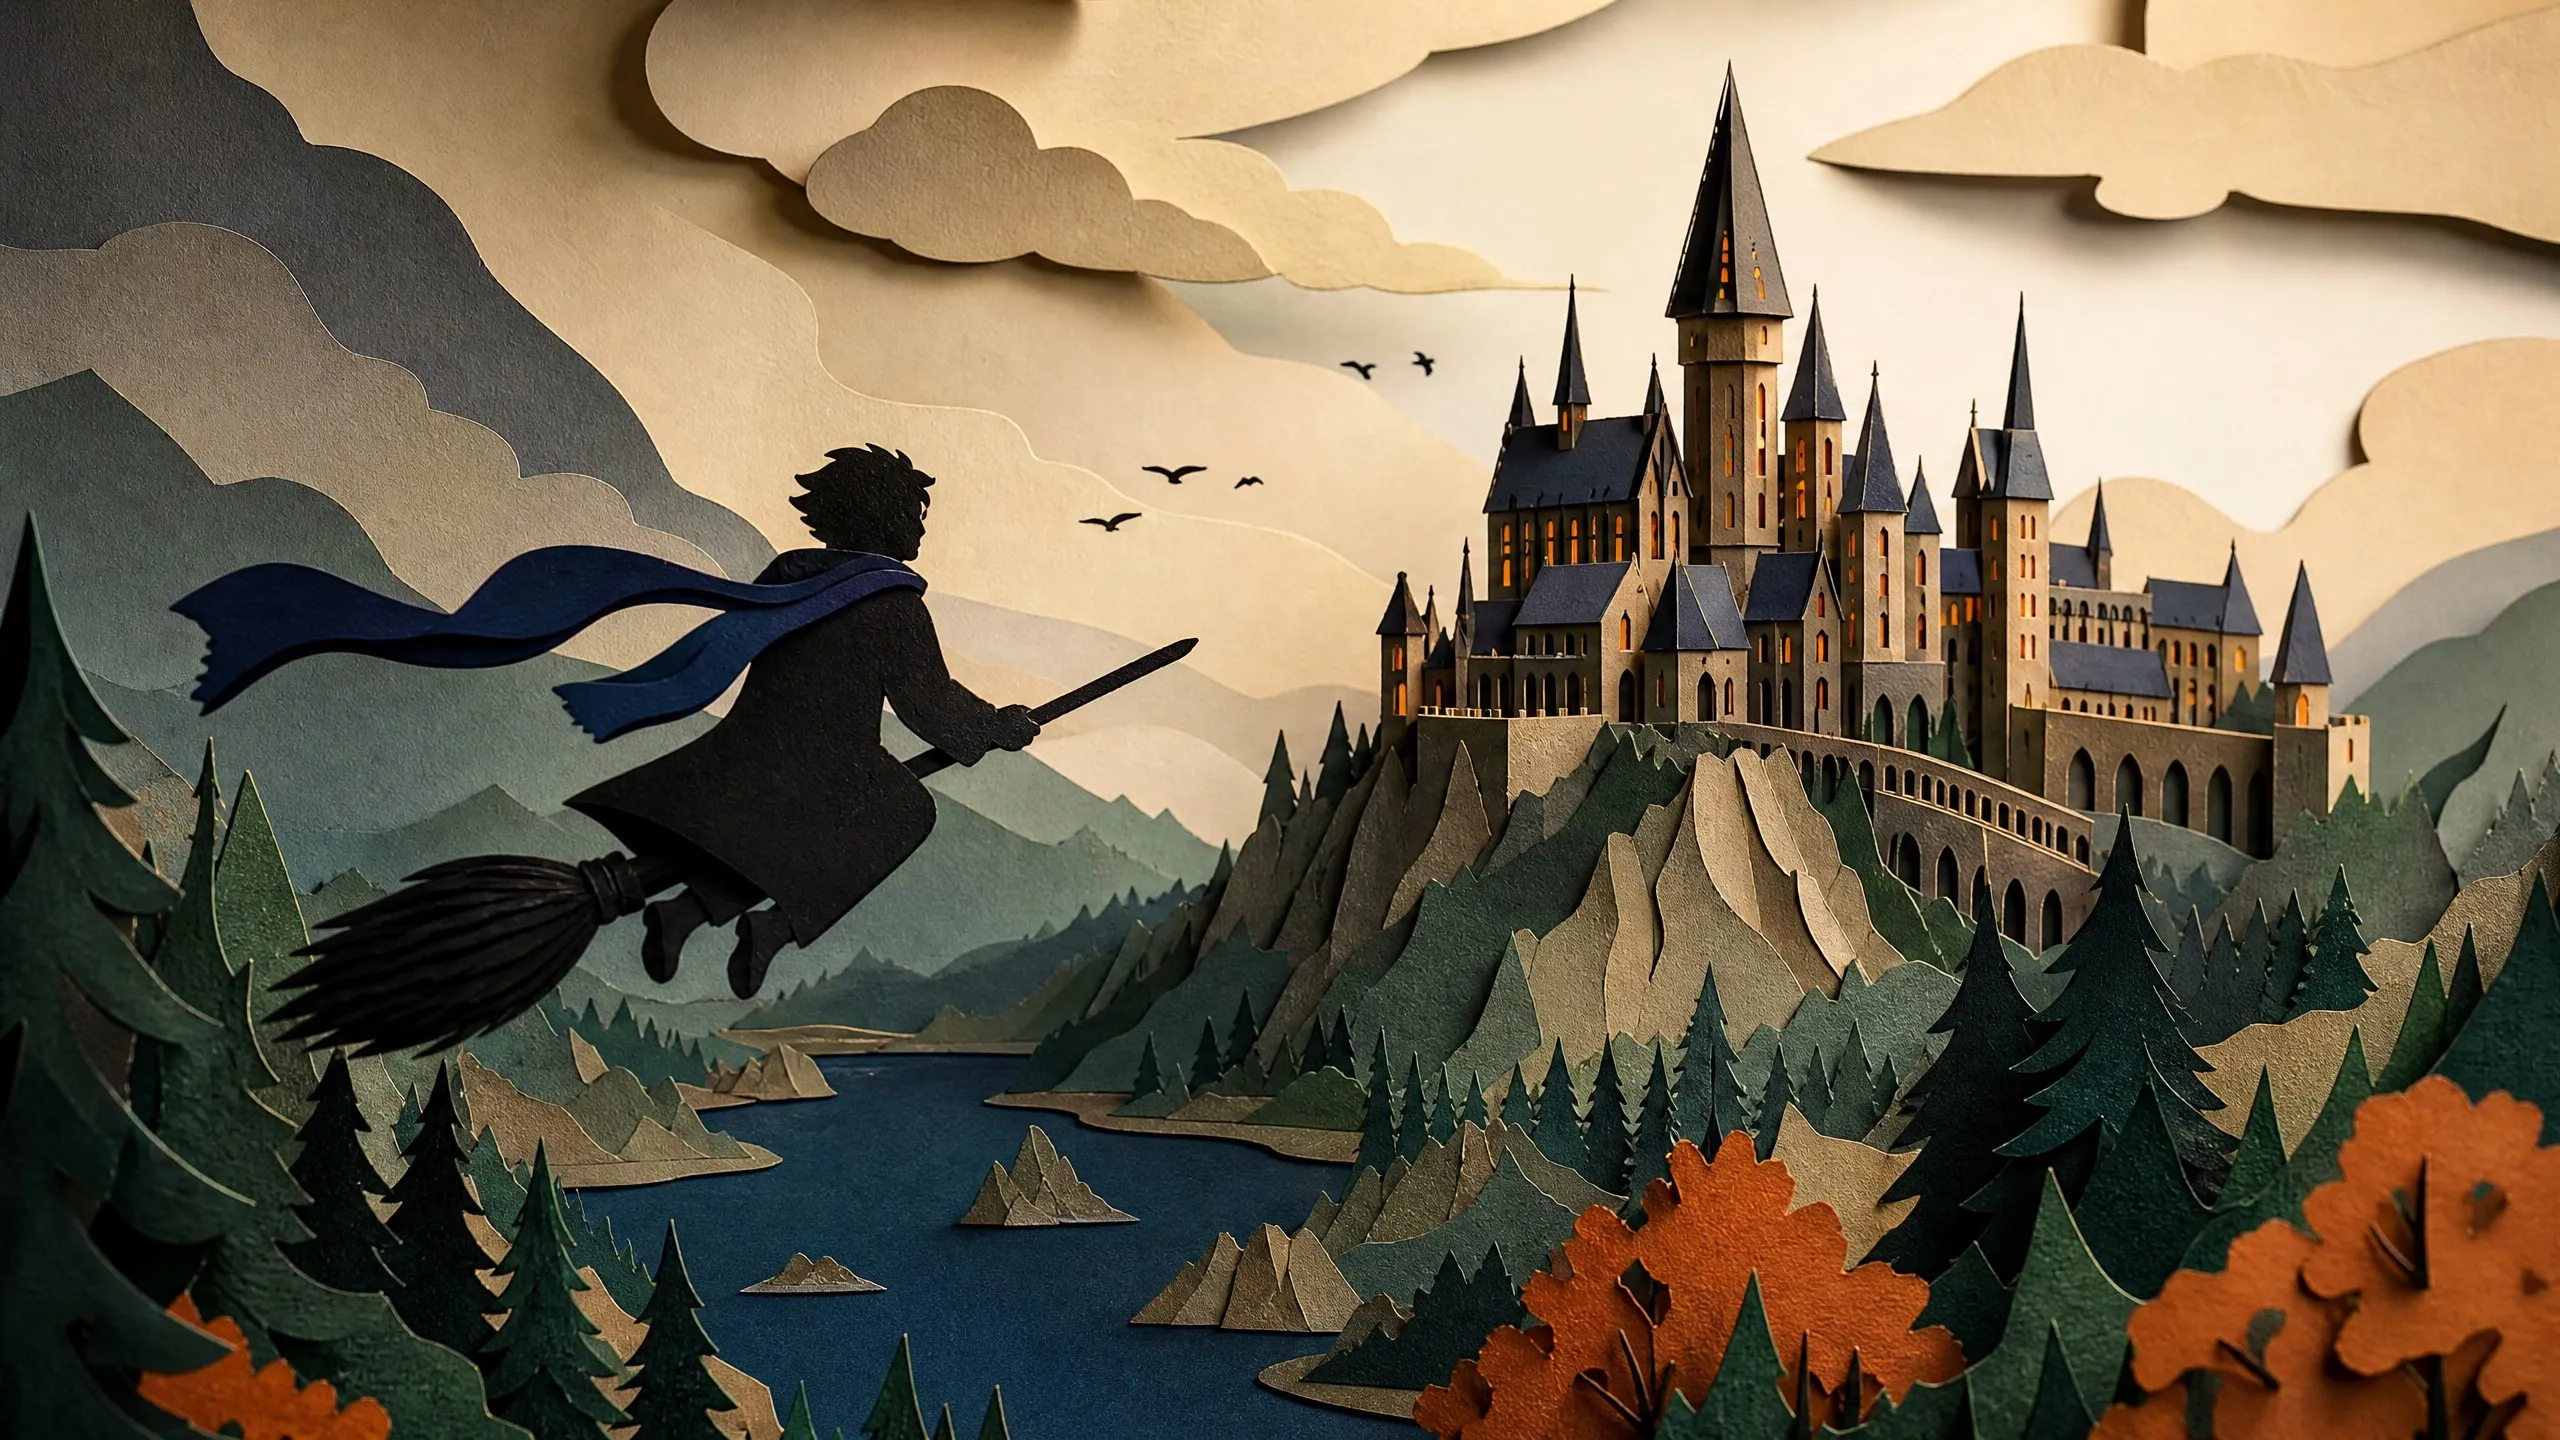
Симулятор полета на метле в Хогвартсе
Дата запуска: 2026-07-16
Тестирование сцены полета на метле: глубина, визуальные подсказки движения, масштаб замка и фантастическое настроение.
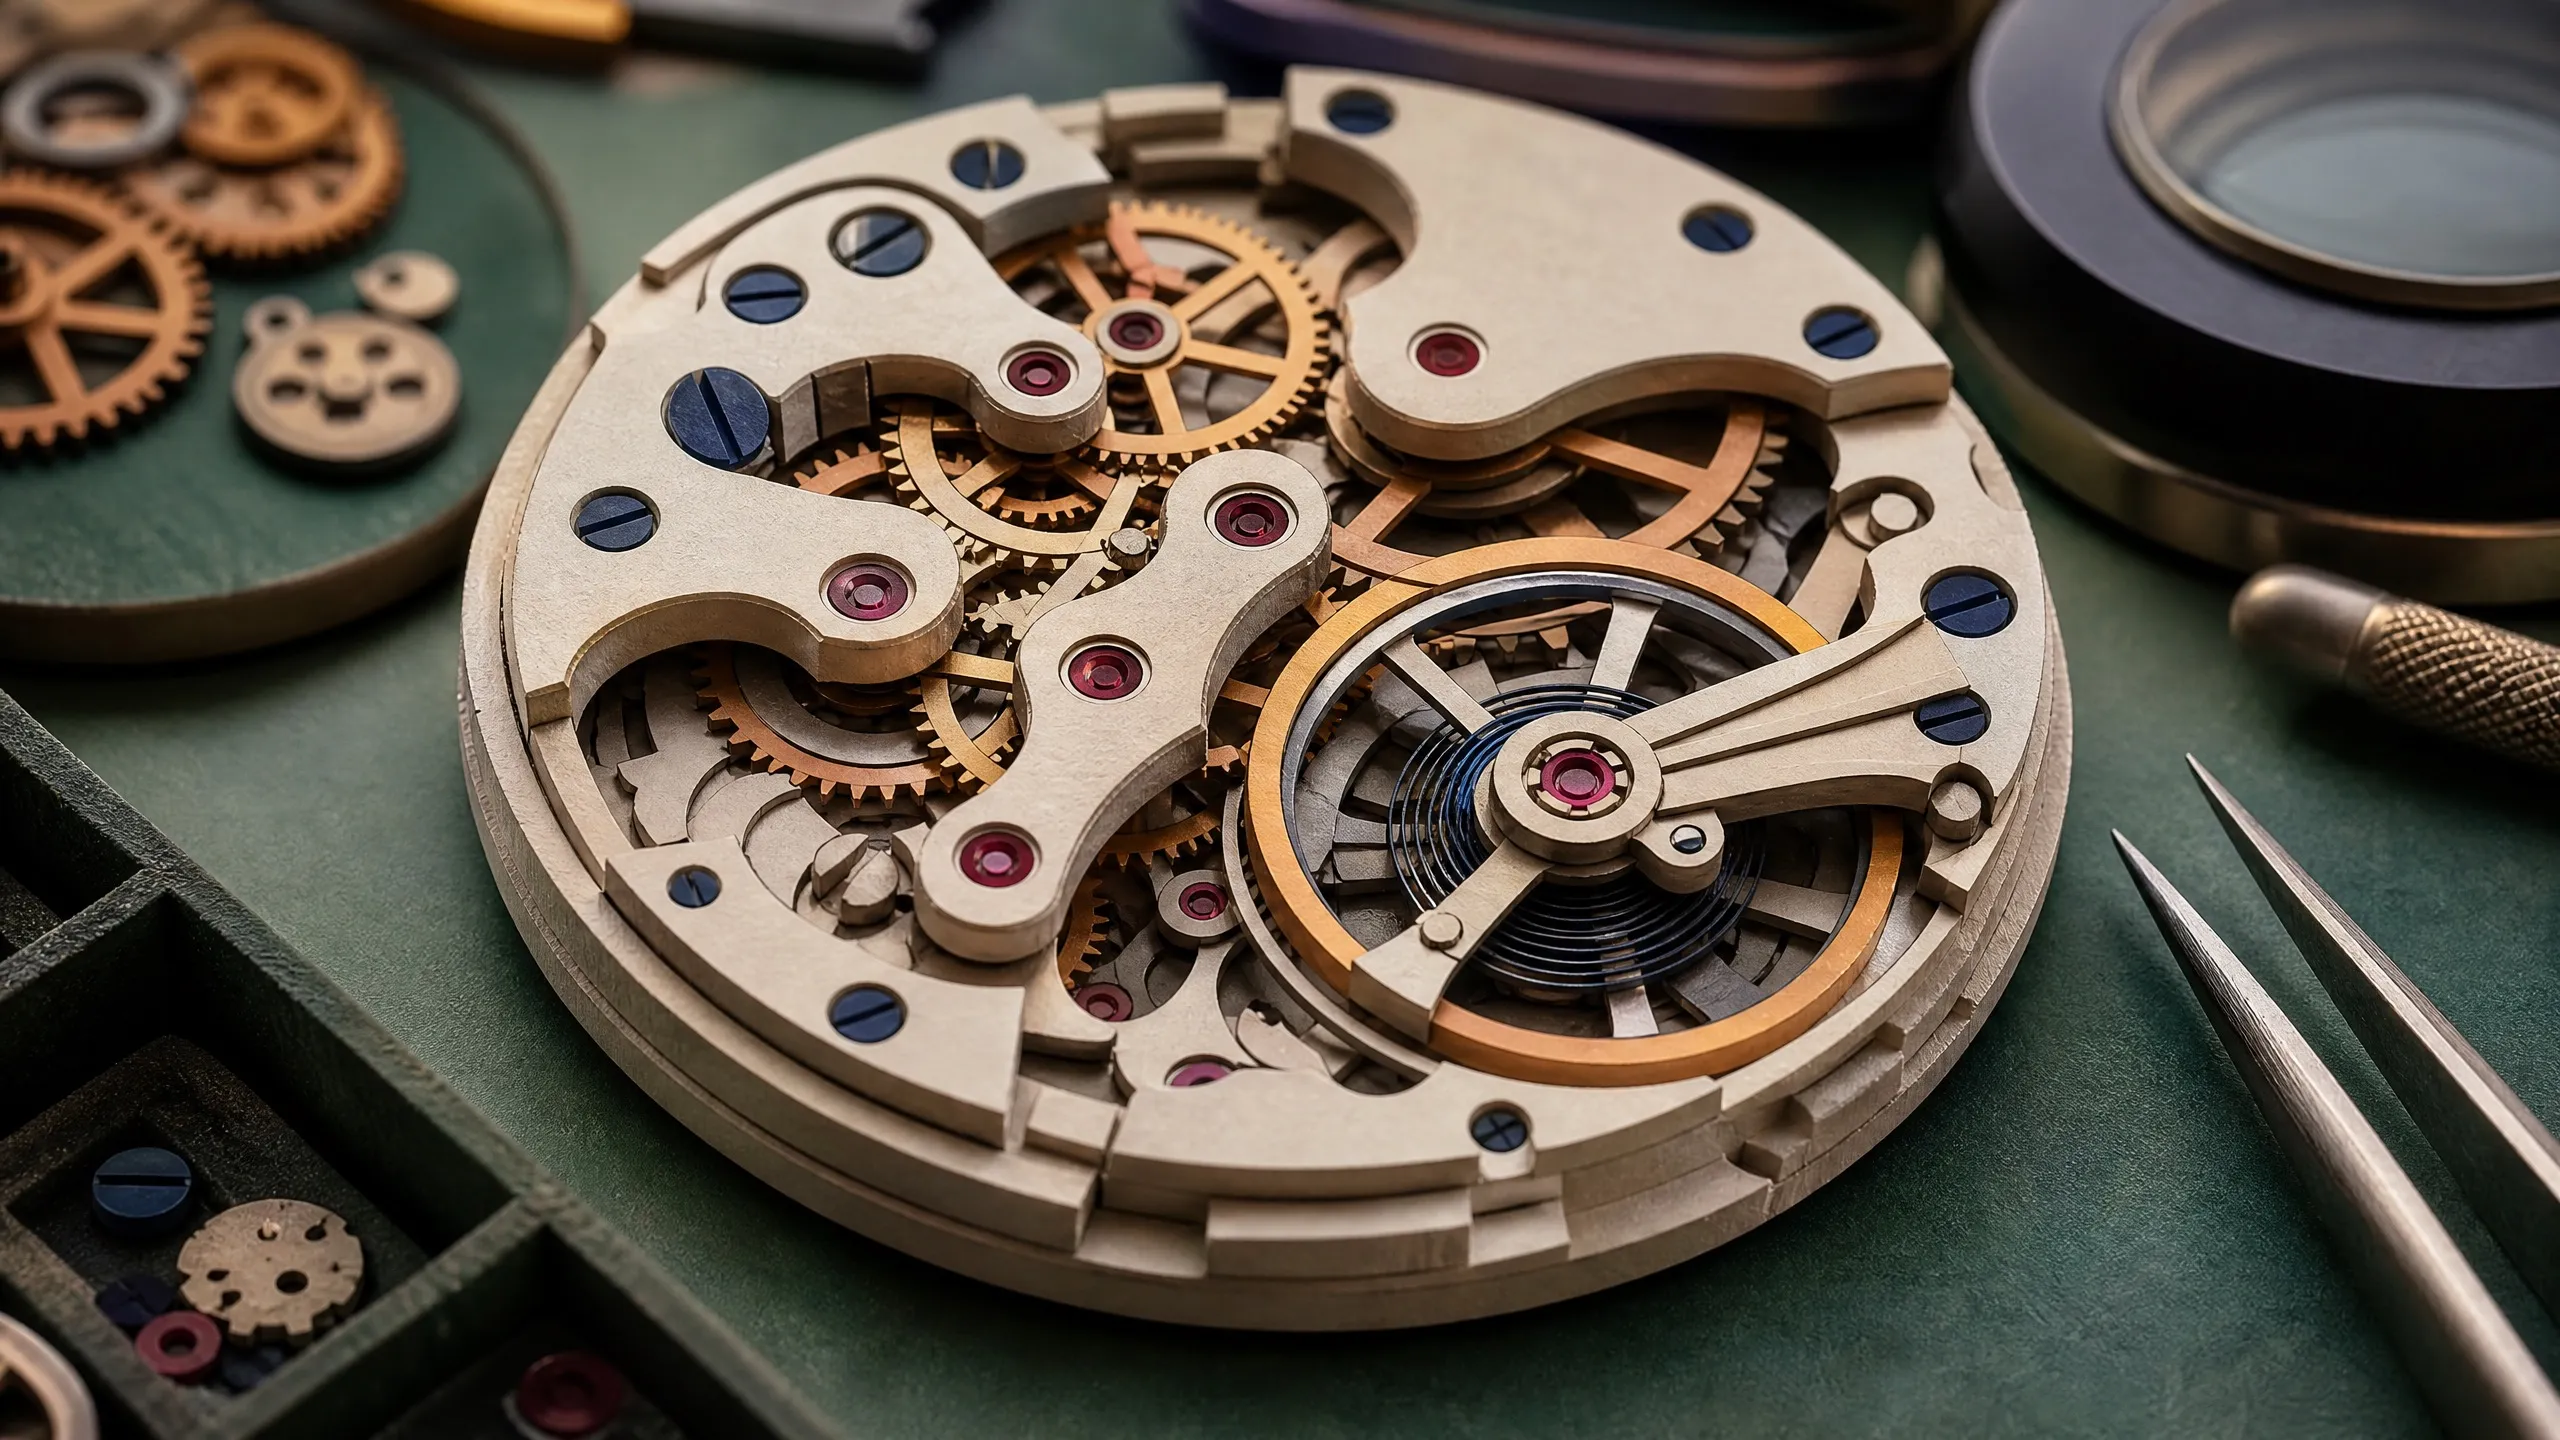
Симулятор механических часов
Дата запуска: 24.07.2026
Интерактивное тестирование часов: механическая читаемость, точное относительное движение и управление в 3D в реальном времени.
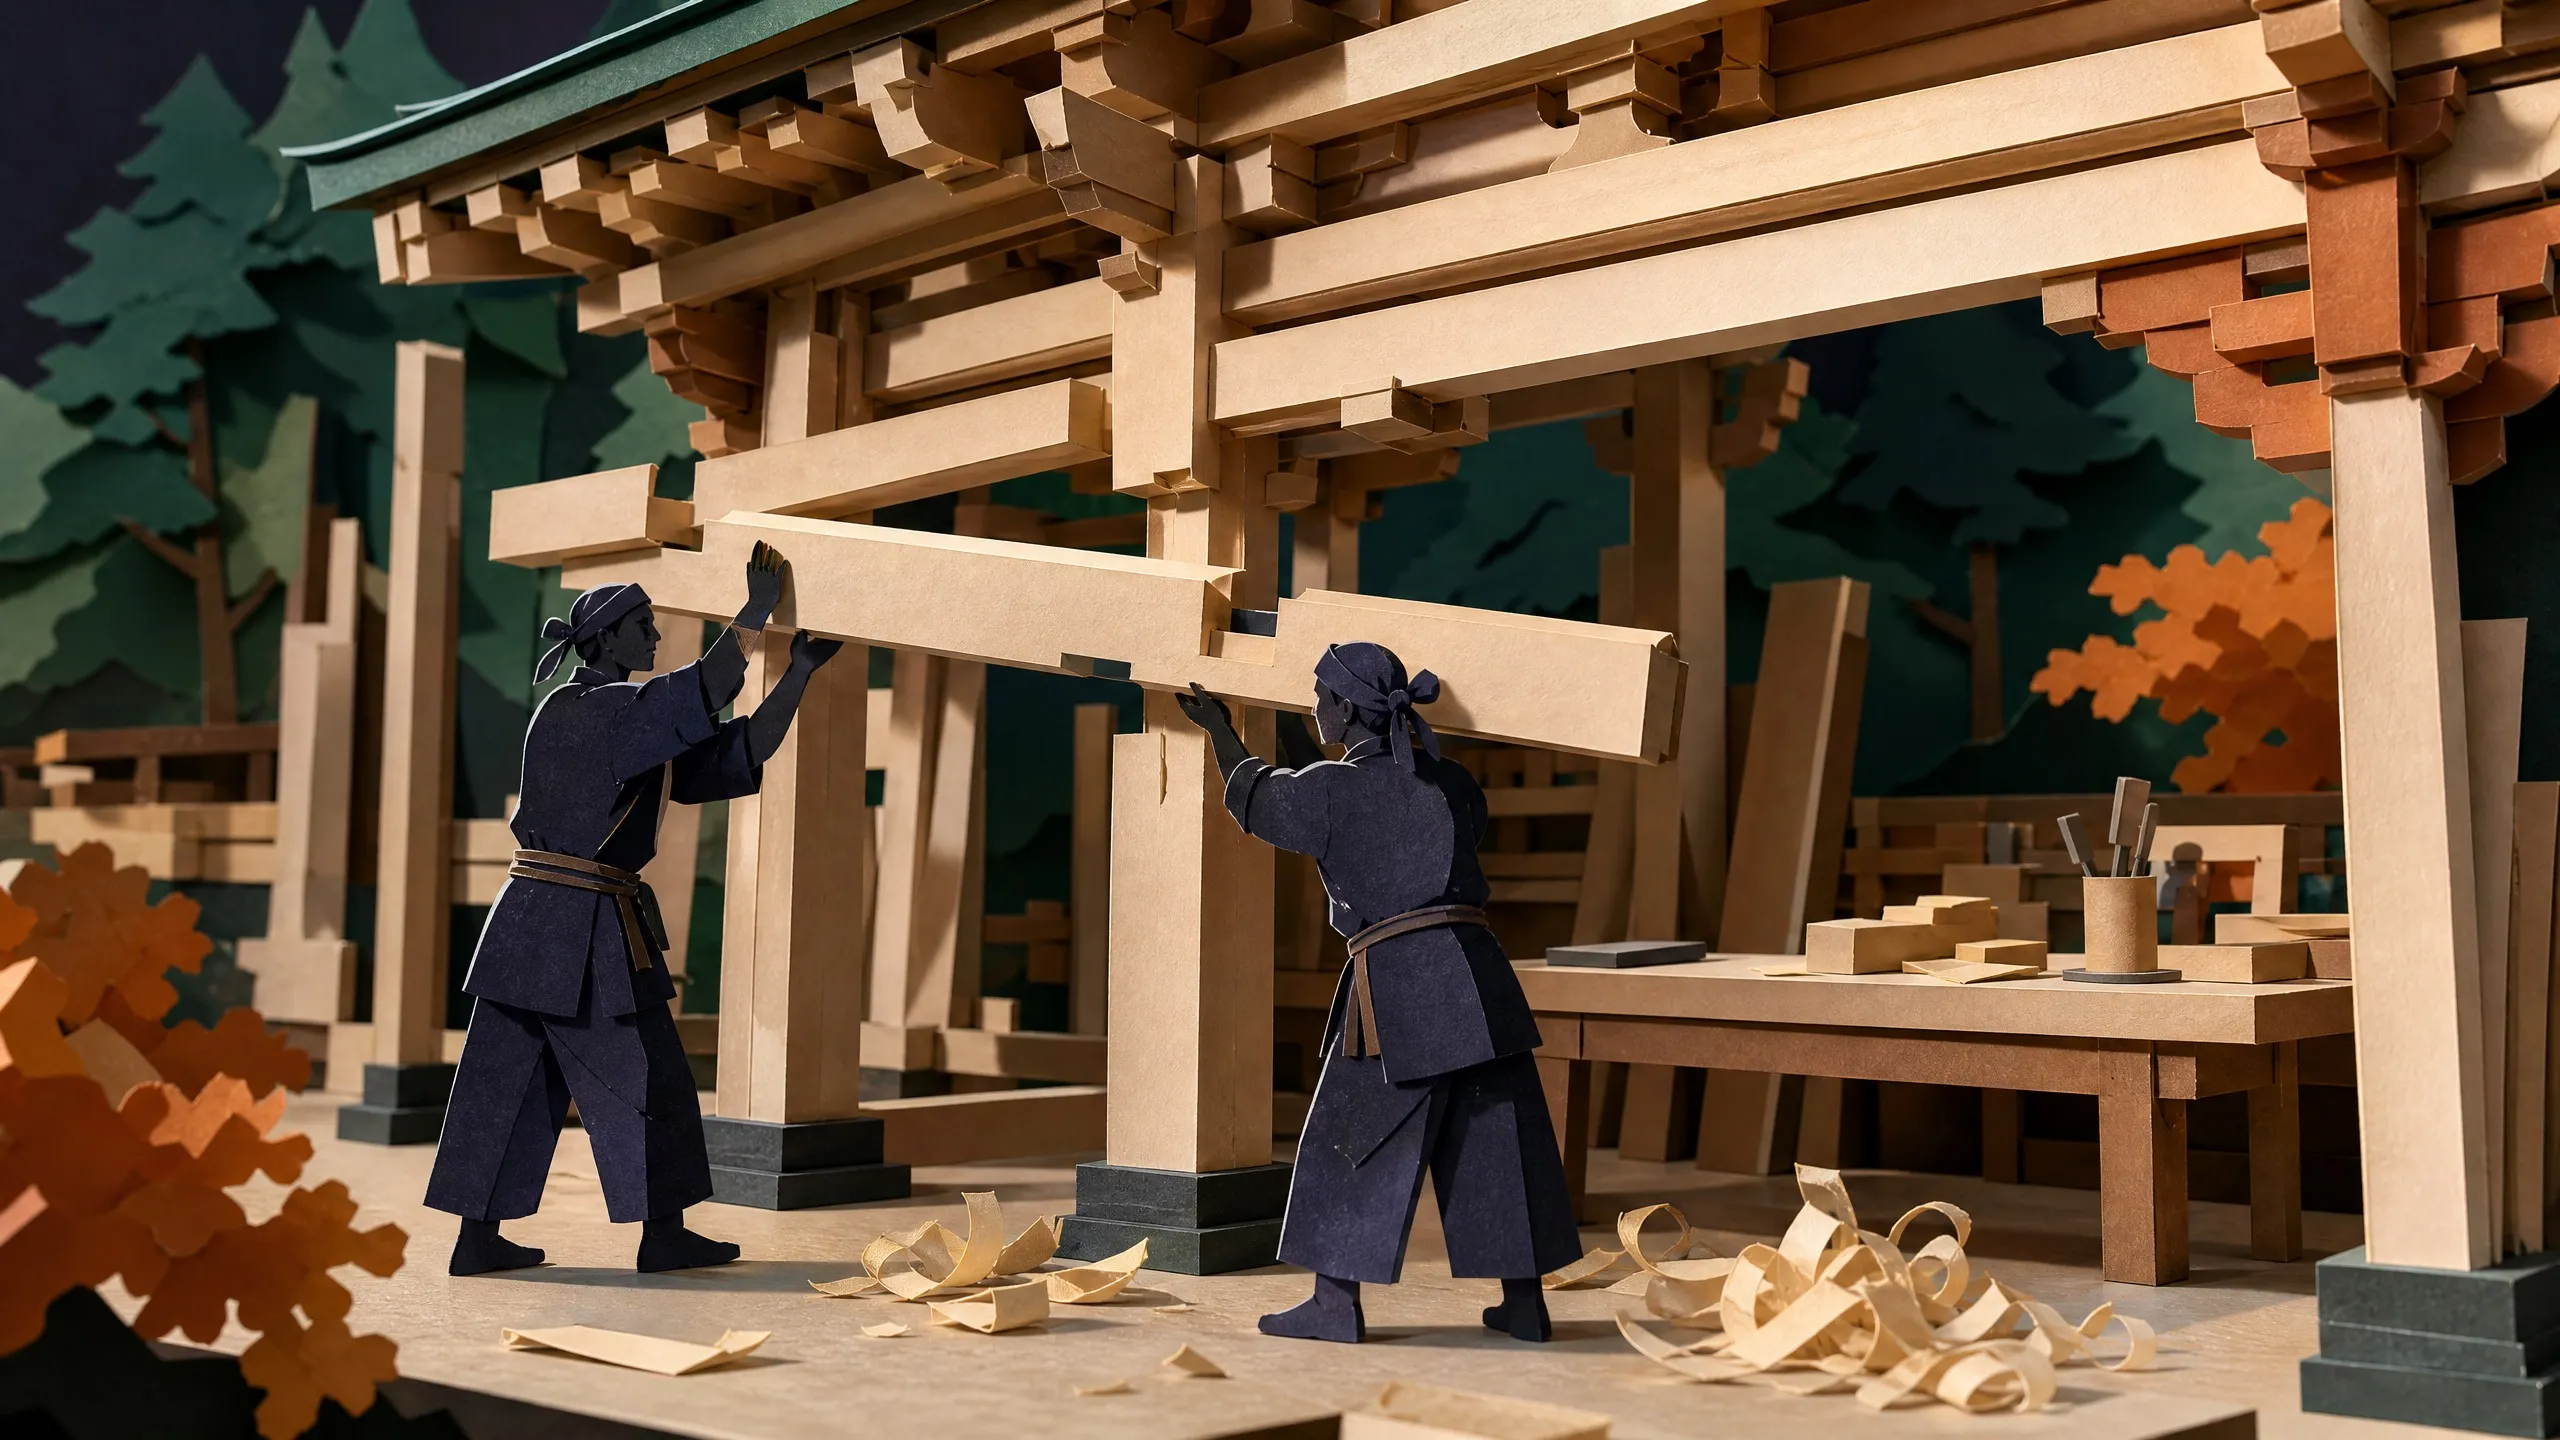
Сборка по «Yingzao Fashi»
Дата запуска: 2026-07-16
Специализированный тест · оценка отдельно
Сцена сборки древесины для тестирования структуры, соединений, порядка строительства и материала.
Снятые с эксплуатации тесты · 6 заархивированных запусков
Эти тесты больше не входят в активный набор. Их исходные результаты остаются доступными для просмотра.
Сравнение Kimi K3
Трое соответствующих коллег, бок о бок.
- Kimi K3 Эта модель
- Claude Fable 5
- GPT-5.6 Sol
- Claude Opus 4.8
6 бенчмаркs · 4 модели
Официальный профиль бенчмарка
Опубликованные результаты за пределами наших визуальных тестов
GPQA Diamond
93.5%DeepSWE
67.5%Terminal-Bench 2.1
88.3%Полная официальная таблица бенчмарков12 оценок и сравнение с коллегами
| Бенчмарк | Площадь | Балл | Сравнение |
|---|---|---|---|
| GPQA Diamond | Академическое рассуждение | 93.5% | |
| DeepSWE | Программирование | 67.5% | |
| Terminal-Bench 2.1 | Агентное кодирование | 88.3% | |
| SWE-Марафон | Долгосрочное программирование | 42.0% | |
| BrowseComp | Агентское исследование | 91.2% | |
| DeepSearchQA (F1) | Глубокое исследование | 95.0% | |
| MCPMark-Подтверждено | Использование инструментов | 94.5% | |
| AutomationBench | Автоматизация рабочих процессов | 30.8% | |
| SpreadsheetBench 2 | Работа с электронными таблицами | 34.8% | |
| OmniDocBench | Понимание документов | 91.1% | |
| MMMU-Pro | Мультимодальное рассуждение | 81.6% / 83.4% | |
| CharXiv (RQ) | Рассуждение по диаграммам | 84.8% / 91.3% |
Источники, детали ценообразования и методология
Проверенные данные о модели
Характеристики модели
- Статус
- Текущий
- ID модели API
kimi-k3- Контекст
- 1.05М
- Максимальный вывод
- 131К
- Лицензия
- Не подтверждено публично
- Способ доступа
- Не подтверждено публично
- Модальности
- Не подтверждено публично
- Аппаратное обеспечение
- Не подтверждено публично
- Kimi API · USD / 1 млн токенов
- $3 за ввод · $0,3 за кэшированный ввод · $15 за вывод
Цены не включают применимые налоги и отдельно оплачиваемые инструменты.
Источники бенчмарков
Moonshot сообщает, что Kimi K3 работает на максимальной когнитивной нагрузке по программированию, исследованию, использованию инструментов, работе с документами и зрению. Официальная таблица смешивает различные окружения провайдеров для некоторых задач агентов, поэтому каждая строка сохраняет свои настройки оценки.
Технический отчет Kimi K3Настройки оценки
- Максимальная когнитивная нагрузка, температура 1.0, top-p 0.95.
- Kimi Code harness на задачах DeepSWE v1.1.
- Среда Kimi Code; для других моделей указаны лучшие заявленные среды каждого провайдера.
- Claude Code для Kimi и Claude; Codex для GPT-5.6 по ветке задач с калибровкой H20 от 9 июля.
- Сжатие контекста до 300 тысяч токенов; полный прогон с контекстом в 1 млн без управления контекстом набрал 90,4%.
- Максимальные усилия при рассуждении, температура 1,0, top-p 1,0.
- Общедоступный поднабор из 600 заданий с официальной настройкой бенчмарка.
- Claude Code для Kimi и Claude; Codex для моделей GPT.
- Максимальные усилия при рассуждении; среднее значение по трём мультимодальным прогонкам.
- Без инструментов / с Python; исходный порядок ввода; среднее значение по трём прогонкам.
- Без инструментов / с Python; среднее значение по трём прогонкам.
- DeepSWE
- Официальный результат в рейтинге под mini-SWE-agent составляет 67.3%.
Редакционный вердикт
Где подходит эта модель
Kimi K3 хорошо справляется с долгим кодированием, использованием инструментов и визуальной итерацией. Команда исчерпала лимиты коротких и месячных планов во время регулярного использования, поэтому это размещение учитывает доступ и стоимость, а также чистую производительность.
Лучшее для
Внимание
Почему она занимает это место
Доказательство
Редакционный рейтинг моделей Mantis
Основной вывод: Kimi K3 в настоящее время находится в категории А.
Редакционный состав сентября 2026 года ставит Kimi K3 на 9-е место.
Открытый исходный код →Kimi K3: Open Frontier Intelligence
Основной вывод: В таблице релизов Moonshot представлены результаты конкурентного программирования, агентные и визуальные показатели, включая 88,3% на Terminal-Bench 2.1 и 81,2% на FrontierSWE.
Это результаты, предоставленные поставщиками при максимальных усилиях по рассуждению, и они варьируются в зависимости от используемого агента, поэтому они демонстрируют передовые возможности K3, но не являются сопоставимым общим баллом.
Открытый исходный код →Визуальный набор бенчмарков Mantis: Kimi K3
Основной вывод: K3 выполнил все девять общих визуальных бенчмарков в наборе Mantis.
Результаты предоставляют практическую проверку качества визуальной реализации наряду с опубликованными результатами бенчмарков.
Открытый исходный код →Связанные руководства